栈不只在函数调用里
栈不只在函数调用里
隔壁老康难度 ★★☆☆☆ · 前置:数组到底快在哪 | 一句话结论:栈的全部规矩都能从压、弹、只读栈顶这三个动作推出来,调用栈、撤销栈、括号匹配、DFS 的显式栈是同一个东西的四个身份;Go 的栈会自己往上长,所以栈溢出在这里跟 C 里不是同一个故事。
第三个月接到一个内部小工具:把配置模板里的变量引用展开成最终值。值是字符串,里面还能再写变量,${db_host} 里套 ${env},${env} 又可能被人填成一段自己还带引用的值。这么写确实省事,代价是没人能保证它一定收敛。我在测试里随手造了一个环,展开器跑进去就出不来了,一圈一圈地展开,字符串越接越长,最后是测试框架自己超时把它掐掉的。
我写的第一版是递归。
节点是变量名,展开就是把值里的引用再展开一遍,进去之前先记一下自己正在展开谁。环它看得出来,可一旦真踩上,debug.Stack 打出来是一大片地址加行号,几十层叠在一起,我从里面认不出哪层对哪层。那次没有线上事故,工具只在测试里跑过,环还是我自己造的。可盯着那一屏输出我想明白了一件事:我要的是一个我自己能读、能存、能数的栈,递归只是把这件事交给编译器代管。
看不见的栈,你只能相信它。
三个动作,剩下的全是推论
把栈剥到只剩动作,它只答应三件事:往顶上放一个、从顶上取走一个、看一眼顶上那个是什么。没有按下标取,没有遍历,也没有查找,连问一句里面有没有某个值都做不到。三条动作一摆出来,后面那些规矩就不用谁再规定了,它们是推出来的。第一条是顺序:放进来的东西只能从顶上取走,那么最后放进去的一定最先出来,因为它的上面没有别的;最先放进去的压在底下,它要出来,得把后来那些全搬走。后进先出不是设计者挑的规矩,是这三个动作的算术结果。有人把栈讲成一个有底有口的桶,这比方没错,可它容易让人以为顺序是桶的形状带来的。换一根两头都通的管子,只规定只能从一头进出,结论一模一样。
只有这三个动作,能推出很多东西。第二条是封闭。中间的东西拿不到,原因不是不方便拿,是根本没有任何动作能碰到它。这条常被当成缺陷写进书里,其实它是这个结构最值钱的地方:所有操作都落在同一个位置上,代价恒定,不管底下已经压了多高。第三条是深度。整个栈对外只暴露一个数,就是它有几层,常数时间就读得到。所以能用栈算的东西,最后往往都落到算一个深度上:括号配不配平、递归压了多深、撤销还能退几步,问的都是同一个数。
顺序、封闭、深度,都是从里面长出来的。
推论还有一条反着来的:谁先到谁先办的场合,栈就是错的工具,那是队列。栈把注意力钉在最近的一件事上,办完立刻退回上一件。
四个身份,一条约束
我后来在四处碰上它,每次长相都不一样,剥掉名字是同一个东西。
调用栈管的是返回。每次调用进来,运行时就往下压一层,一层里放两样东西:回到调用者的地址,和这一层的局部。深度就是嵌套到第几层。它只让你看顶上,所以函数只能一路往回退,退不出来就说明有人没返回;中间那一层长什么样它给不了,只能靠调试器把整片打出来当文本读,我那天卡住的地方就在这儿。也正因为只给顶,调用栈的深度是被动长出来的:你没有 API 问它现在多深,只能等它撑爆或者等 runtime.Stack 把整片抄下来。
撤销栈管的是回退。每做一步压一条,撤销就是弹出顶上那条、把它反过来执行。深度在这儿换了个意思:这条链最长能有多长,取决于你要回溯多久。它和调用栈有个细微的错位,调用栈的顶是最里面那次调用,撤销栈的顶是最新那个动作,一个往回退,一个往后退,方向相反,压栈的时机却都是事情发生的那一刻。所以撤销栈的容量得由你自己定,运行时不管这事,它只负责让你多退几步或者退不回去。
括号匹配管的是配对。看见左括号压,看见右括号弹,弹得动说明配对成功。栈深在这里就是当前的嵌套层数,扫完全程栈空就是配平,不空就是还有左括号没等到右括号;中间任何一步要弹却弹不动,那个右括号就是多余的那个。栈里存的不是括号字符,是它的下标,因为谁和谁配这件事只有位置答得上来。同一套走法换成 XML、JSON、到表达式求值的运算符栈,只换判断条件,骨架一个字不用动。
DFS 管的是下一步去哪。递归版的遍历,接下来该回哪存在 CPU 的栈上,由返回地址替你记着;换成显式栈,同一份信息躺在你自己的一片内存上,形式一模一样,只是从别人管变成你管。
四个身份到这儿就合成了一个,前三个的栈是运行时替你看的,第四个在你自己手上。
四百万层压下去,机器没响
我给那个小工具顺手做了个实验:让一个函数一层层往下调自己,每层带一个 48 字节的数组,看在 Go 里能压多深。函数头上加了 //go:noinline,这一行不是装饰,下面会说为什么。
1 | //go:noinline |
1000 层过,10000 层过,100000 层过,五十万、一百万、两百万,再往上四百万层也过,没有栈溢出。这台机器是 go1.27.2 windows/amd64,i9-14900HX,GOMAXPROCS=32。Go 在 64 位平台上把单条 goroutine 的栈上限开得很大,按每层四十来字节算,四百万层离那条顶线还远得很,所以它过得去,跟机器快慢没关系,跟运气也没关系。换成 C 就未必是同一个结局,那边栈是进程启动时就划好的一块,超了就是段错误,连一句像样的报错都不给。
机器连响都没响一声。换一条路,把同一件事做成显式栈。
1 | type frame struct{ n int } |
500 万层,堆增长 38.10 MB,每层 8.0 字节。一个 int 就是八个字节,一分不多。
这里有个坑,我第一次就踩了。第一版我没写 //go:noinline,觉得数比该有的小,就顺手给这个偏差编了个原因,说编译器把尾递归折成循环了。后来补上 pragma 再量一遍,每层字节一点没变,四百万层也照样一层层压上去。我猜的那件事压根没发生。Go 不做尾递归消除,为了确认这个我另写了个尾调用形状的版本,最后一句就是 return f(n-1),四百万层照样把栈吃掉。pragma 对另一种函数才要紧:体简单到能被内联的,最外面那几次调用会被折进调用点,那几层帧压根没进账单,账面就偏小。
解释是我自己补的,一次都没验。我后来只信加了 pragma 之后再量一遍的数。
每层四十二字节,那两百字节去哪了
第二个实验换了 200 字节的数组,在 goroutine 里递归,用 runtime.ReadMemStats 前后夹住,读 StackInuse 加 HeapAlloc 的差。深度从一千一路加到四十万,每一档各记一笔。
| 深度 | 增长 | 每层 |
|---|---|---|
| 1000 | 0.03 MB | 32.8 字节 |
| 10000 | 0.47 MB | 49.2 字节 |
| 50000 | 1.97 MB | 41.3 字节 |
| 100000 | 3.97 MB | 41.6 字节 |
| 200000 | 7.97 MB | 41.8 字节 |
| 400000 | 15.97 MB | 41.9 字节 |
从五万层往上,每层就锁在 41.3 到 41.9 之间了。中间那点抖动是栈扩容的账:栈不够用时运行时另要一段两倍大的,把旧的整块搬过去,搬家那一瞬新旧两段同时活着,摊到每层上就偏一点。
稳定下来的是四十二字节左右。
那我那个 200 字节的数组呢?没了。它只被写过第一个字节,别处一次都没读,编译器把它整个删了,连栈上的位置都没留。这四十二字节里没有它,装的是返回地址、上一层的位置、几个还要用的寄存器。
40 万层乘 41.9 字节,正好是表里那 15.97 MB。
前两行别当成本看。1000 层那行只有 0.03 MB,量到的是取整之后剩下的渣;10000 层那行 49.2 偏高,是那段深度正好骑在扩容边界上,两段栈还叠着。真要判断一层多贵,得看后面几行,前面两行量的是启动开销。
八 KB 是六 KB 取整上来的
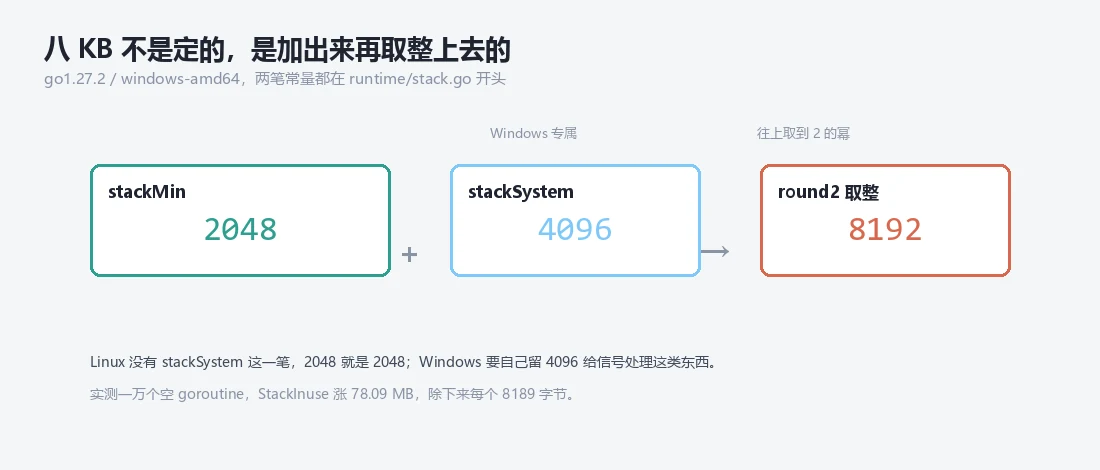
一万个空 goroutine,每个只干一件事:<-ch 挂在那儿。起完之后 StackInuse 涨了 78.09 MB,除下来每个 8189 字节。
八 KB 是白给的。
准确说不是白给,是被取整上来的。Go 里 stackMin 是 2048,这是最少给这么多;Windows 上还有一笔 stackSystem,4096,留给信号处理这类东西。Windows 不像 Linux 那样有独立的信号栈,这笔预留只能自己掏。两笔加起来 6144,而运行时要求栈大小是 2 的幂,round2 把它往上推一格,8192。两个数都在 runtime/stack.go 开头那几行常量里躺着,一个写着 2048,一个写着 goos.IsWindows*4096,八 KB 是它们乘除出来的,不是谁拍脑袋定的。同一份代码在 Linux 上量出来是 2 KB 起步,Windows 上一个空 goroutine 先付八 KB。
8189 和 8192 差三个字节,这点差我在源码里没找到对应的账,大概是那一万个 goroutine 起停之间还有别的栈在涨落,摊薄之后剩下这么点零头。能说的是每个约八 KB,不是精确到字节的八 KB。
快一倍的那一半,和它换走的东西
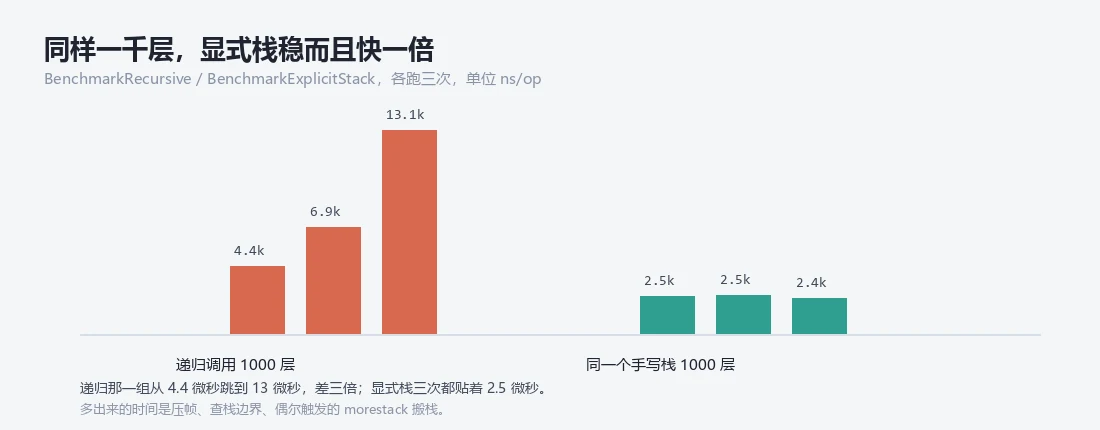
同样 1000 层,递归和显式栈各跑三遍基准。递归版 4381、6933、13119 ns/op,显式栈版 2503、2510、2376 ns/op,快一倍左右,而且稳得多。
递归那边三遍差了近三倍。
差的那一半有来源。递归每调一次都要压帧、出函数要查栈边界够不够,不够就跳进 morestack 要一段更大的、把旧的搬过去。1000 层这个深度恰好横跨好几次扩容,搬栈的账全摊在那一轮里,所以第一遍和第三遍能差出三倍。显式栈的扩容是 append 的事,切片翻倍,摊还之后每层几乎不花钱,但它的每一层都实打实压在堆上,500 万层就是 38.10 MB,这些内存是活的,每轮回收都得扫一遍,还扫不掉。递归的 42 字节躺在栈上,栈是每段单独管的,不进堆的账本,可它也不便宜:深到 40 万层,8 字节对 42 字节就是五倍多。
一个在账本上,一个不在。
三条判断,把栈拿回来
那个模板工具最后改成了显式栈,改完报环的时候能把整条路径打出来:a -> c -> f -> a,一行,谁都能看懂。递归版打不出这一行,因为路径在它那儿是 CPU 栈上的返回地址,不是数据。
后来我自己写东西,用三条判断该不该把栈从编译器手里拿回来。头一条是深度不确定,或者可能很大:递归的上限是运行时的限额,不是你的,显式栈的上限是你自己的内存,而且到顶之前你能看见。要是路径本身就算答案,比如想报出你是怎么走到这儿的,那串东西必须是数据,不能是 CPU 栈上的返回地址。还有一种是需要中途停下来:显式栈能整体存成一份快照,之后再接着跑,递归的现场是一堆寄存器和栈帧,存不下来。
三条都不成立的时候,我写递归。写递归的成本不是慢,是你把栈交出去了,从此它长在哪里、长到多深,都由别人决定。
回到 2023 年那个下午。我要的从来就不是一个数据结构,是一个能说清楚我正走到哪的东西。栈给的就是这一件事:它永远只告诉你顶上那一步,而只要我记得往回退,一步接一步就连成了整条路。