一张依赖图,比十条日志管用

一张依赖图,比十条日志管用
隔壁老康难度 ★★★★☆ · 前置:装包顺序是怎么排出来的 | 一句话结论:依赖关系存成图而不是存成列表,是因为图能回答列表答不了的问题——谁被谁依赖、环路在哪、扇出有多宽。
装包工具的进度条停在同一个位置不动,我先去查了网络。网速正常,镜像也通,换了个源还是停在那儿。后来我把工作区里几百个 package.json 一张张扫下来,按“我这个包依赖谁”整理成一张边表,几十行脚本就导完了。边表摊开之后,图上有一条 A 指向 B、B 指向 C、C 又指回 A 的环,构建脚本的排序跑到那一圈就开始原地打转,每个包都在等别人先出产物,谁也没等到。整个过程没有一条报错,连个警告都没有。我盯着那份边表看了很久,才意识到自己手里一直是一份“我要什么”的清单,从来没把它当成一张有两个方向的关系网。
停着,是因为顺序排不出来。
这件事里没有谁是坏人。文件写着谁依赖谁,脚本照着读,缺的只是把这些声明反过来再排一次的东西。我后来想,问题出在我一直把它当成一份清单在看。
清单和图的差别,就在这一眼。
关系都写在文件里,看见的却是一份清单
package.json 里那个 dependencies 是一个数组,一行一个包名,排得整整齐齐。顺着数组往下走能走很深,一个包牵着七八个,那七八个各自再牵着七八个,几百个文件能牵出上千条边。问题不在深度,在方向:这一路永远朝前走,只回答“我需要什么”,从来不回答“谁需要我”。手里捏着这份边表,你能算出自己缺哪些包,算不出自己动一下会踩到谁的脚。
它是一份单向视野。
文件能表达的东西就到这儿。它描述的是“我这个包要什么”,主语固定是我。依赖关系完整的形态是一条有方向的边,两个端点各自携带信息,砍掉任何一端,剩下的都只是一份引用列表。
两个端点,各说一半。
一个下游挂着三十七条入边
扇出在依赖图里对应的是入度。一个包被多少个上游直接依赖,它的入度就是多少;它的故障面,是这些上游各自往下牵着的全部东西。我那张图里入度最高的一个基础库挂着三十七条入边,画出来像一只摊开的手掌,所有指头汇到掌心。它在任何一条链路上都只出现一次,所以在任何一份按请求采样的日志里,它的分量看起来都跟旁边那些点差不多,谁也不会多看它一眼。
单条链路只会经过它一次。
日志是路径上的一段采样。请求从 A 进来的那次,它出现一次;从 C 进来的那次,它出现一次;从另外三十五个入口进来,它还是只出现一次。要把这些“一次”加起来,得有个字段记着这条边是从哪来的,而大部分日志的字段里没有这一格,只有当前请求的耗时和几个业务参数。翻十份日志,你能拼出十条链路,拼不出这张网。查到最后总有人提议加个 traceid 把上下游串起来,可串起来之后仍然是一条一条的线,线上没有任何位置告诉你,这个点还挂着别的三十几条线。
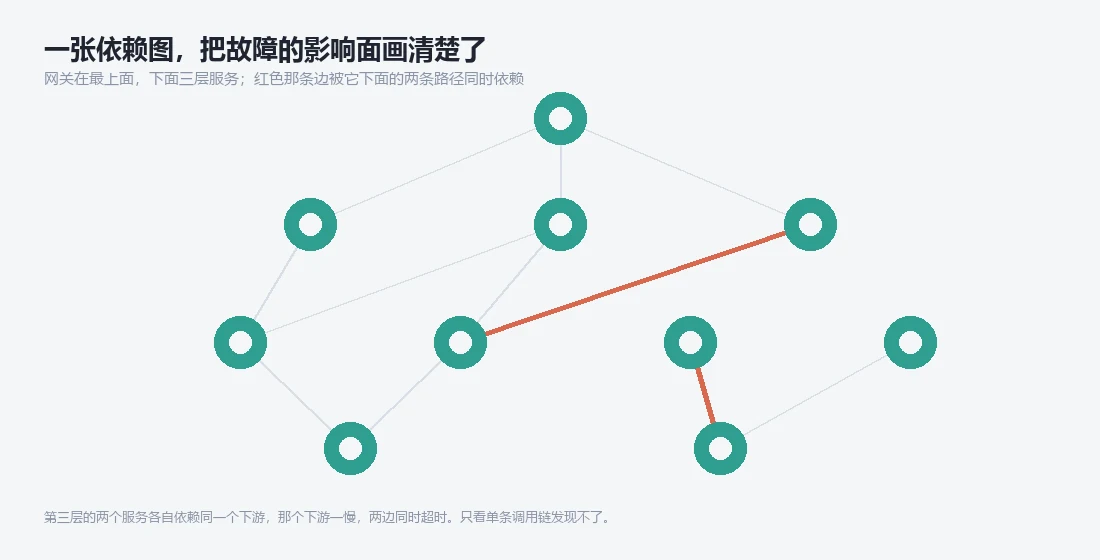
扇出跟链路长度给出的直觉正好相反。一条链路越长,人越觉得它危险,因为环节多、耗时累加、出错的概率随环节数往上走。可决定一次故障波及范围的,是那个被很多条链路共享的点:链路再长,也只影响从它进来的人;共享点一倒,所有经过它的链路一起断。我在图上数过,最长那条链有十四个点,而入度三十七的那个库,删掉它能让四十多个包同时失去前置。
前者的影响是一条路径,后者是一整张网。
1 | // 入度:这个包被多少个包直接依赖 |
十几行,一个数组加一遍扫描。得到的除了最大值,还有一份排好序的名单,把前十个点摊出来看,通常就能看出哪几块地基承受的重量不成比例。
改代码之前就算得出来。
环不报错,它只是让你排不完
拓扑排序跑到一半停住,意味着剩下的点里每一个都还有入边。装包现场的表现是卡住;服务之间互相调用的表现是两个服务互相等,各自超时、各自重试,日志里全是超时记录,没有一条写着环。同一个结构问题,在两种场景里长成两副面孔,共同点是它都不主动说自己是什么。人在这种现场容易往错误的方向找,因为超时看起来太像网络问题了。
长度不够,就是有环。
环的形状还可能很隐蔽。A 指向 B、B 指向 C、C 指回 A,这种三角形一眼能看出来,通常是写错了、两分钟能改掉的那一类。麻烦的是经过三十个点的环,它在图上摊得很开,肉眼顺着走会走丢,中间还夹着别的分支。检测它不需要看图,也不需要知道环长什么样,只需要看排序结果够不够长:三千个节点首尾连成一个大环,Kahn 跑完返回“有环”,三色 DFS 也返回“有环”;在环上摘掉任意一条边,两边同时变成“无环”。
三种输入我各跑了一遍,结论一致。摘边那个动作是重点:它说明两边都不是靠“图看起来很乱”来判断的,依据只有排序有没有把所有点收进去。
一个整数就够。
反向边是另一张表
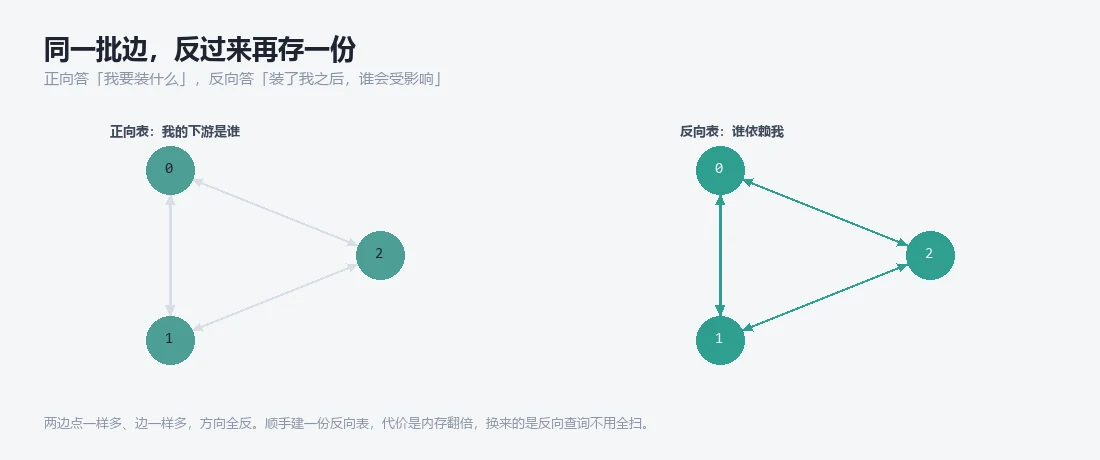
正向邻接表回答“我依赖了谁”,这个问题跟声明顺序一致,所以人人都有。反过来问“谁依赖了我”,正向表里没有索引,只能把每个点的邻接表挨个翻一遍,边数上万时一次要几毫秒到几十毫秒,而这个问题在一次排查里往往要问几十遍。更要命的是它问不出第二层:想知道改这个包会顺着哪条路波及更远的地方,得从起点做一次反向广度优先,正向表里连第一条反向边都找不到。
问得最多的,恰好是反向那个。
1 | // 反向边:从被依赖方查上游,rev[v] 就是依赖 v 的那些包 |
同一批边换个方向再存一份。存两份的代价是内存翻倍,收益是两类查询都变成跟度数成正比。边表本来就不大,翻倍换来的是一张随时能回答“改这个会波及谁”的索引。
反向查出来是一张名单,名单上还得排个序:我依赖的这些东西里,哪几个最危险。依据是它们各自的入度,或者更狠一点,把它们挂着的上游再展开一层,数一数总共有多少条路径最后会走到这里。这个数在正向表里要跑一遍全图才能得到,在反向表里是几个数组查表。排序这个动作本身不产生新信息,它只是把已经存在的关系换个顺序摆出来,人才能看见。
存一张图要多少空间
一百万个点、平均度 4 的图,邻接表存下来 53.41 MB。同一张图换成 n×n 的位矩阵,是 116.42 GB,差了两千多倍。位矩阵的算法很直白:一百万乘一百万再除以八,一个比特管一条边,一个不多一个不少。可没有哪台机器会为了一张依赖图去开 116 GB,光是分配那一下就得先找到一块装得下的连续内存,而这块内存通常找不到,操作系统会先摇头。
稀疏是常态。
一个包平均依赖四五个,放到一百万点的完整关系里,非零的位置不到百万分之五。邻接表要给每个点留一段头,边少的时候头比边还占地方。
真正实现里通常用两个数组拼起来,一个存偏移、一个存邻居,点少边多的时候更省。多存一份反向表,也就再多一份同样大小的数组,规模上还是这个量级。跑起来也不贵:一百万个包、出度 3 的图,拓扑排序 36.73 ms(append 队列)/ 33.02 ms(预分配队列);出度 8 时 73.11 ms / 61.91 ms。构图和排序的成本可以忽略,贵的是收集和清洗那些边。
那一半时间没有算法能帮你省。
图落后于代码,比没有更糟
判断标准不在图的规模,在这张图被问的频率。一次性的整理,导出来画一张图看两眼就够,看完删掉都行。每天都要回答“这个包能不能升”、“改了它会影响谁”的地方,才值得把它落成一张表,跟代码一起版本管理,改一条边就更新一次,让图的更新跟着提交走,而不是跟着人的记忆走。图一旦落后于代码,它比没有更糟,因为人会信它。
问一次是分析,问一百次是基础设施。
我现在会看三个信号:动手改一个点之前得先查一遍上游;同一个环被两个人分别发现过一次;有人开始手画依赖图拍照发群里。
三个里凑两个,我就把图存下来,正向反向各一份,环检测挂到提交钩子上,让它在人看见之前先报一次。
上面的代码加起来不到五十行。
麻烦的是让它一直跟代码同步活着。这套东西我搭过一次,后来是靠提交钩子才没荒掉,人记不住去手动更新它。
那圈环改完,进度条一口气跑到了底。三个人后来都在群里说没想到是这个包,我们查了两天的东西,钩子两秒钟就报了出来。