切片扩容为什么要拷贝整块内存

切片扩容为什么要拷贝整块内存
隔壁老康难度 ★☆☆☆☆ · 前置:接口慢了两百毫秒,最后是一张表的问题 | 一句话结论:扩容贵的地方不在 append 那一行,在它必须换一块新地址、把老数据整块搬过去,而块越大,搬起来越慢。
把一天的订单摊成 CSV,本地跑一百万行,这个导报表的活我入职第三个月接的。第一版写完一跑,比坐我左边的同事那版慢五倍多。两段代码我都翻出来对过,循环体几乎一样,都是一行 append 往里塞,差别只有他在循环外面先写了一行 make。我盯着那行 make 看了很久,心里有点不服气,因为那周我刚在周报里写自己已经能独立写业务逻辑了。
不服气归不服气,数还是得量。
那会儿我对 append 的理解只有一句话:它会自己长大。怎么长、长大要付多少钱,我没想过,也没人跟我讲过。我甚至觉得它比按下标写更聪明,因为不用提前算长度。这个想法在我脑子里待了两天,直到我把每次容量变化都打印出来。
最后一行写着 len=1000000 cap=1055744。多出来的五万多个槽位一个元素都没装,它们躺在内存里,什么也没干,却要我付内存,还要占着那块地方不让别人用。我一开始以为是分配器取整的毛病,后来才发现取整只是一小部分,真正的大头在另一件事上:这一百万个元素在长到这么大之前,被整块搬过很多次,每一次搬家都要一份时间,那份时间不会因为搬家结束就还给你。
增长是台阶,不是斜坡
打印容量变化的代码只有十来行。做法很土:每 append 一次就比一次 cap,变了就打印一行,最后数一数有几行。三十六行,一行一次扩容。(这个数我后来复现了三次,每次都是三十六次,一次不多一次不少,连最后的 1055744 都一模一样。)
1 | package main |
容量序列的前十一项是 4、8、16、32、64、128、256、512、848、1280、1792。前面八项规规矩矩地翻倍,到 512 换了走法,下一级不是 1024,是 848。头一项为什么是 4 不是 1,我一开始也没想通:8 字节的申请要经过分配器的尺寸档向上取整,最小那几档是 8、16、24、32,第一格落在 32 上,除以每个元素 8 字节,cap 就是 4。
台阶从这儿开始变窄。
尾部三次的触发点是这样:第 539649 个元素扩到 674816,第 674817 个扩到 843776,第 843777 个扩到 1055744。累计拷贝 4154012 个元素,最终长度一百万,等于每个元素平均被搬了四遍多。四遍多这个数我一开始没看懂,按翻倍算,从 1 翻到一百万只要二十次,次数少,总代价应该也少才对。次数确实不多,可每次搬的是当时那一整块,前几次搬得少,后几次搬得多,加起来跟最终长度成正比,跟次数关系不大;前段翻倍,后段收窄,最后落在 4.15 这个数上。
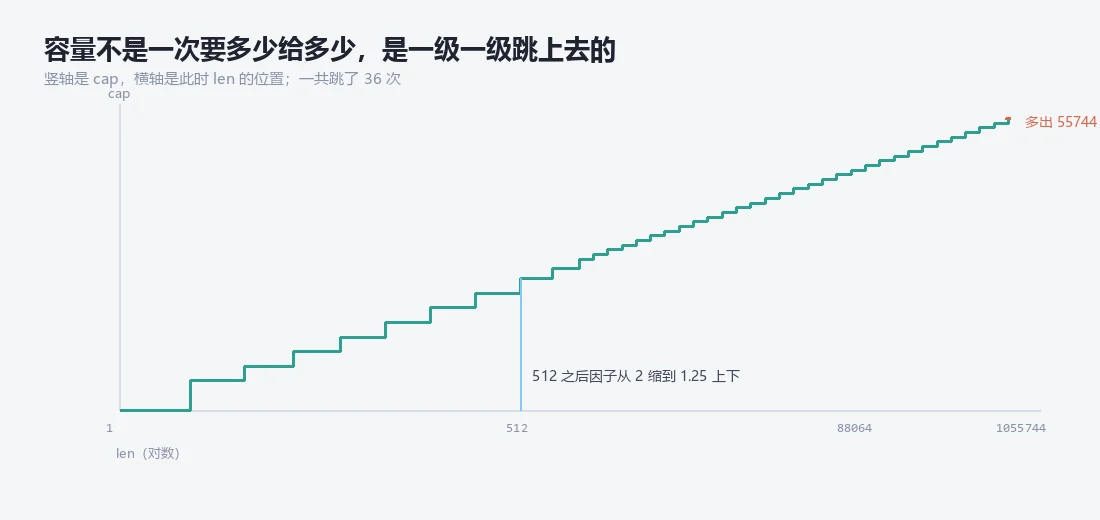
台阶越往上越窄,两次之间的空隙刚好够再塞一次搬家。
不换地址,就没有第二种办法
要回答为什么每次都得整块搬,得先回到切片怎么取值。s[i] 编译出来是基址加上 i 乘 8,一次乘法一次加法,取完就走。这条算法成立的前提只有一个:所有元素挨在一起,第 i 个就在开头往后数 i 个。连续不是习惯,是承诺。有了这个承诺,一次搬运才能带上一整行,预取器才能顺着往下猜。这两件事我在数组到底快在哪里量过,一千万个 int64 顺序读一遍,比同样长度的链表快将近两倍,多出来的时间全花在等内存上,跟算法没有关系。
现在要在尾巴上再加一个元素。
你想要的是原地把那块内存扩一下,可分配器按 size class 切块发出去,你手里这块右边是不是空的、是谁的,它不查也不保证。隔壁可能早就许给别人,也可能正好是另一个切片的数据。所以 growslice 只有一条路:找一块更大的、装得下的新内存,把老数据整块拷过去,再把旧的还掉。贵的不是申请,是搬。
还有一件事,我第一次踩的时候完全没意识到。
新块的首地址变了,原来那个切片头里的指针指向一块已经还回去的内存。所以 s = append(s, x) 这个赋值不是习惯,是必须。你把返回值丢掉,编译器不拦你,可下一次写就写到了旧地址上。少接一次赋值,就是一个悬空指针,它还不一定当场报错,可能过几轮 GC 才咬你一口。
512 之后,台阶窄了
512 之后每一级大概是前一级的一点二五倍,可落到具体台阶上是 848、1280、1792,比值分别是 1.66、1.51、1.4,忽高忽低。
从这几个数往回推,后段的规则大约是:新容量等于旧容量加上旧容量的四分之一,再加一百九十二。512 算出 832,848 算出 1252,1280 算出 1792,都对得上,那个一百九十二是从 256 这个门槛来的。832 是纸面上的数,落到分配器上还得往上取整:8 个字节一个元素,832 个是 6656 字节,分配器没有这一档,往上取到 6784 字节,正好装 848 个;1252 个是 10016 字节,取到 10240,正好 1280 个。纸面的一点二五落到台阶上,就成了 1.66 和 1.4。
那为什么不是 1.5?
把拷贝总量算一遍就有答案。因子取 k,总拷贝量约等于最终长度乘上 k/(k-1):k 取 2 是 2 倍,取 1.5 是 3 倍,取 1.25 是 5 倍。实测 4.15,落在 3 和 5 中间,因为前面九个台阶还是 2 倍。因子越小,拷贝次数越多;因子越大,新旧两块同时占着的时间越长,峰值内存越高。Go 挑了省内存的那一边,这在内存贵、GC 要扫两遍的地方划算,代价就是我表上那四遍多的搬运。
(我到现在也没找到一份官方解释,只能从这串数字往回推。)
两毫秒,只发生在一百万次里的一次
我把 append 拆成两种情况量:切片正好装满、下一次必须扩容,以及切片留着一个空位、下一次不用扩容。同一段循环跑两遍,只差一个开头。
1 | package main |
| 切片状态 | 不扩容 | 要扩容 |
|---|---|---|
| len=cap=1024 | 0 ns | 1311 ns |
| len=cap=16384 | 3 ns | 75862 ns |
| len=cap=262144 | 3 ns | 546284 ns |
| len=cap=1048576 | 3 ns | 2267972 ns |
1024 那行,不扩容量出来是 0 ns,因为一道算术加一次写入确实不到一纳秒,被截断了。要扩容的那一列从 1311 纳秒一路涨到 2267972 纳秒,同一个 append,价差一千七百多倍。三十六次扩容合计 6.6 到 6.9 毫秒,占全部 append 耗时的 58.5% 到 60.4%。一百万个里有九十九万九千九百六十四个不扩容,基本不花钱;剩下三十六个,把六成的时间吃掉了。
最慢的五次是这样。
| 触发元素 | 扩容后 cap | 这一次的耗时 |
|---|---|---|
| 539649 | 674816 | 1.2038 ms |
| 843777 | 1055744 | 1.1003 ms |
| 69633 | 88064 | 633.6 µs |
| 139265 | 175104 | 550.8 µs |
| 110593 | 139264 | 538.1 µs |
第 843777 个元素那一次花了 1.1003 毫秒,第 539649 个花 1.2038 毫秒,再往下是 633.6、550.8、538.1 微秒,量级一档一档往下掉。(说句题外话,那天下午我一直在怀疑是自己代码写错了,因为第一版打出来的点全是 0。)均摊 O(1) 这句话没错,它算的是长跑的平均值。一次请求不等长跑,它等的是自己那一次。均摊把尖峰平均掉了,你的 p99 里还留着它。
平均是给规划用的,不是给等待用的。
从 282 GB/s 掉到 3.4 GB/s
为了弄清这两毫秒花在哪,我把 memmove 单独拎出来量了一遍。两块预分配好的切片,拿 copy 搬,块大小从 8 KB 一路加到 64 MB,每档跑三遍取中位。
| 一次拷贝 | 数据量 | 带宽 | 单次耗时 |
|---|---|---|---|
| 1024 个 int64 | 8 KB | 282.5 GB/s | 不到 1 µs |
| 65536 个 | 0.5 MB | 67.4 GB/s | 不到 10 µs |
| 1048576 个 | 8 MB | 9.0 GB/s | 0.931 ms |
| 8388608 个 | 64 MB | 3.4 GB/s | 19.915 ms |
1024 个 int64 是 8 KB,拷贝速度 282.5 GB/s,8 KB 还在 L1 里,一条指令搬几十个字节,这个数是缓存的速度,不是内存的速度。65536 个是 0.5 MB,掉到 67.4 GB/s;1048576 个是 8 MB,9.0 GB/s,一趟 0.931 毫秒;8388608 个是 64 MB,3.4 GB/s,一趟 19.915 毫秒。块大了八千倍,带宽掉了八十三倍。
块越大,带宽越低。
把这条曲线和扩容序列对起来,4.15 这个数字才有重量。按搬走的旧容量算,最后三次一共搬 206 万个元素,前面三十三次加起来 210 万,几乎对半分;按搬进去的新容量算,最后三次是 257 万,前面三十三次 158 万,比例更悬殊。两种算法都指向同一件事:前面那些全在缓存里打转,三十几次加起来不到一毫秒;最后三次,每一次都要走一趟内存。那两次最大的扩容,一次 1.21 毫秒,一次 1.10 毫秒,加起来 2.3 毫秒。带宽表里 8 MB 那一档纯拷贝只要 0.931 毫秒,多出来的那部分不是搬,是分配器向系统要一块新的 8.4 MB,内核把页清零,第一次写进去还要触发缺页。这三笔谁也躲不掉,只要还得换一块新地址。
搬家之外,还得先开荒。扩容的代价跟次数关系不大,跟终于搬了多少字节关系很大,而块越大,单位字节越贵。
半毫秒的钟,看不见几纳秒的事
我最早想量的不是扩容,是单次 append 到底几纳秒,想用它来算一次扩容能顶多少次。
1 | package main |
跑出来 99% 的点都是 0。我一开始以为是我写法有问题,后来单独量了一次那把尺子:一百毫秒里连读一千二百八十二万次 time.Now,值只变了 133 次,相邻两次变化的最小间隔 441600 纳秒,中位 555500 纳秒,平均七十多万纳秒。也就是说这台机器上 time.Now 大约每半毫秒才走一格,一次 append 才几纳秒,两个时间相减是 0,再拿总时间去除非零次数,倍数就是 +Inf。我盯着那行 +Inf 看了好一会儿,第一反应是编译器把循环优化掉了,于是把结果塞进一个包级变量又跑了一遍,还是 +Inf。尺子比被测的东西粗,量出来的东西就没有意义。
换成 testing.Benchmark 才拿到数。
它自己决定跑多少轮,用总时间除以次数,轮数够多,单次的抖动就被摊开了,上面那张单次 append 的表是这么来的。这件事我记了很久,它让我第一次意识到,计时器的分辨率决定了你能看到多细的东西,比它更细的变化在你这儿根本不存在,你会以为它是 0,还会拿着那个 0 去下结论。后来我量别的东西之前都会先问一句这把尺子够不够细,测网络延迟、测 GC 停顿、测一次系统调用,都是同一个道理,时钟太粗的时候你不是在测一个很小的数,你是在测噪声的下限,而那个下限看起来往往特别干净,干净到你根本不会怀疑它。现在回头看,那天我怀疑错了对象,问题从头到尾都在那把尺子上。
把 38 次分配压成 1 次
回到开头那行 make。
1 | func fill(n int) []int64 { |
同一百万个元素,三种写法摆在一起。
| 写法 | 耗时 | 分配字节 | 分配次数 |
|---|---|---|---|
| 空切片一路 append | 11.3 ms | 41.7 MB | 38 次 |
| make 容量后 append | 2.4 ms | 8.0 MB | 1 次 |
| make 长度后按下标写 | 2.1 ms | 8.0 MB | 1 次 |
时间是五倍,内存是五点二倍,分配次数是三十八倍。(这组我后来复现了三次,每次都在五倍上下浮动。)一行 make,换掉三十七次搬家。后两种差 0.3 毫秒,可以不管,分界线在给不给容量,不在给长度还是给容量,因为 append 只要有容量就不用搬,跟里面有没有值没关系。
预分配也不是白拿的。
你说一百万,就真的先占 8 MB,哪怕最后只写了十行。估大了浪费,估小了照样扩容,但扩一两次跟扩三十几次不是一个量级:按七成给,最多扩两次,那点代价已经落在噪声里。有一类情况不必预分配,长度真的不知道,通常也很小,几十个元素的切片,扩容全在小档位里跳,一次几十纳秒,为它写一行 make 反而是干扰。我刚改完那阵子还矫枉过正,连一个最多存三个元素的临时切片都要 make 一下,被同事看见问我在防谁,我才发现自己把那句预分配更快当成了口号在用。
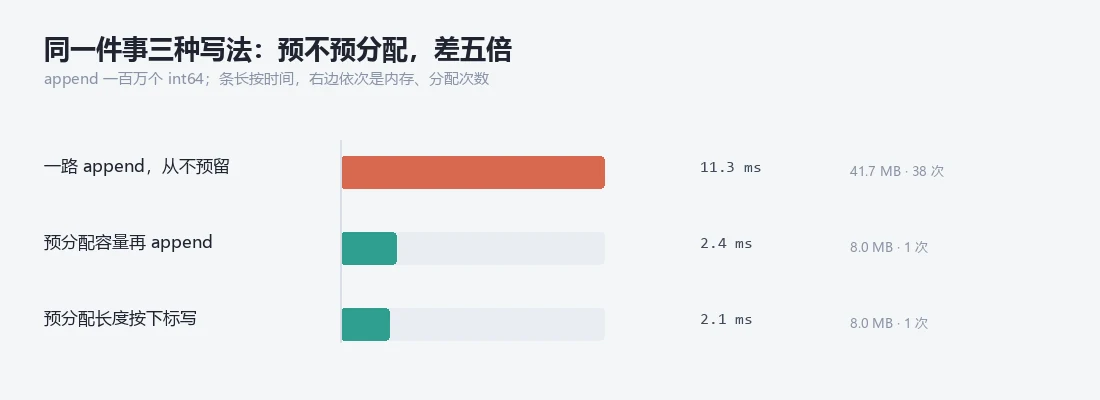
一行代码,两种命运。
知道上限就先给容量
第一条,知道上限就先给容量。导出、批处理、读文件,这三种场合长度基本是现成的。
第二条,请求路径上的 append,先问它有没有上限。
有上限就预分配;没上限说明这个切片会长到多大你不知道,那它多半不该留在请求路径上,至少不该一路 append 到底。
第三条,拿不准就先量。
量出来的五倍和感觉里的五倍不是一回事,尤其是在你刚学一门语言的时候,因为那时候你连该怀疑哪儿都不知道。报表那个接口最后改了两行:循环外面加一行 make,把 append 的返回值好好接住。2.4 毫秒那个数出来的时候,我把左边同事的代码又看了一遍,他那边其实什么都没做,只是从一开始就知道要给长度。我现在写 append 之前会先停半秒,想一下这个切片最后大概多长,那半秒比后面省下的两毫秒便宜得多。