type switch 的 case 顺序决定走哪条路
type switch 的 case 顺序决定走哪条路
隔壁老康难度 ★★★☆☆ · 前置:值接收者和指针接收者,方法集差在哪 | 一句话结论:type switch 的匹配是从上往下逐个比较,第一个命中的 case 就停下,后面的不再看,所以 case 的顺序就是分派逻辑本身,越具体的接口越该排在越前面。
写这段代码的起因很普通,一个上传接口的参数是 any,进来可能是带面积的结构体,可能是错误值,也可能就是个整数。我要在里面分出几条路,每条路做不同的事,最省事的写法当然是 type switch。排 case 的时候我按直觉来,先把宽松的接口放前面,再把严格的接口放后面,理由听起来也顺,宽松的能兜住更多东西,不容易漏掉什么,宽的在前读起来还像从一般到特殊。写完跑了一遍,输出和我预期的对不上,而且对不上的地方正好落在第一个调用上。那种感觉不是报错,代码跑得很顺,只是走到的地方不对,像钥匙插进了另一把锁,还转得动。
我盯着屏幕看了一会儿,先怀疑是自己把方法写错了,又怀疑是嵌入接口没生效,最后才想到去看 case 的排列顺序。
改的时候把两个 case 对调了一下,再跑,输出就换成了另一行。
前后动了三行,代码总行数一个字没变,行为却完全是另一件事。
顺序就是内容,这话是被那一次输出逼出来的。
为了把这件事看清楚,我把要用到的东西压到最小。三个接口,Shape 只有一个 Area() int,Named 只有一个 Name() string,ShapeNamed 把这两个都嵌进去。两个结构体,Sq 三个方法全实现,NoName 少一个 Name,再加一个 Nope 接口专门用来试断言失败,它一个方法都没实现,任何具体类型都进不去。
1 | type Shape interface { |
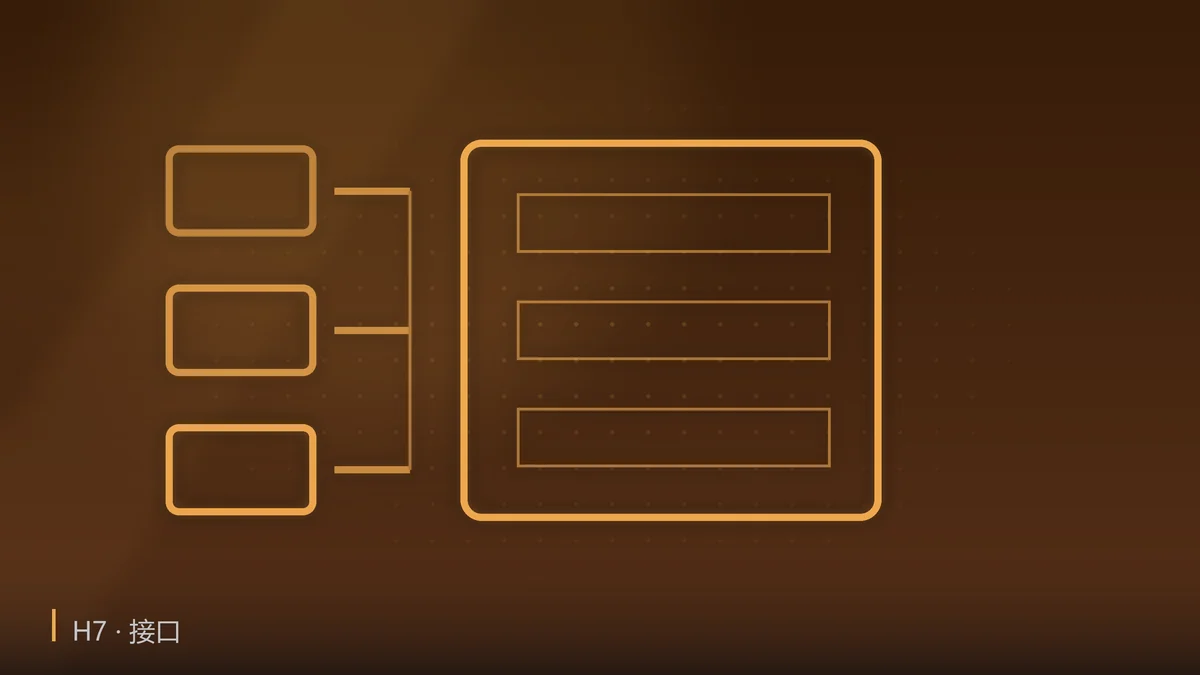
三个接口摆成一个层级
这三个接口不是一个平面上的三个名字,它们之间有明确的包含关系。
1 | ShapeNamed ⊃ Shape, Named |
ShapeNamed 要求两个方法都在,一个都不能少,所以能满足 ShapeNamed 的值,一定也满足 Shape 和 Named(这条是单向的),反过来不成立。NoName 有 Area 没有 Name,它满足 Shape,不满足 ShapeNamed,也不满足 Named,三条里只中一条。这种包含关系在编译器那边就是方法集的子集判断,一个接口的方法集是另一个的超集,赋值和断言才成立,运行期不做名字查找,也不做任何字符串比较,只看类型描述里那张方法表够不够长、对不对得上。接口之间没有继承这回事,嵌入只是把方法列在同一个名字下面,最后拿来比较的还是方法本身,谁嵌了谁不影响判断结果。这张图只画了方法集的包含,没画运行时的任何结构。画出这一层就够用了,因为 type switch 判断的是方法集,不是值有多大,也不是值放在堆上还是栈上。一个值能不能进某个 case,凭据只有它有没有把那几个方法实现齐,方法名、参数、返回值都要对得上,少一个都不算。
这跟接口大小无关,也跟里面装的是值还是指针无关,编译期就算完了,运行时只是照着那张表比对。
先看方法的形状。两个结构体都用值接收者实现方法,所以 Sq 的值和它的指针都满足接口。这一点在讲断言的时候会用到,因为断言的目标类型和值的方法集必须对得上,对不上 ok 就是 false。
反过来,如果哪天你把 Area 改成指针接收者,Sq 的值就不再满足 Shape,而 *Sq 还满足,接口的满足关系是跟着接收者一起走的。
第一个匹配上的 case 就收手
describe 的 case 顺序是 nil、ShapeNamed、Shape、Named、int 和 int64 合并成一个、error,最后是 default。这个顺序不是随手排的,我要拿它验证一件事,同一个值被好几个 case 同时接住的时候,到底哪一支会赢。
1 | func describe(v any) { |
五个调用跑完,输出正好五行,顺序和调用顺序一一对应,中间没有 panic,也没有多余的空白行。这一组输出就是整篇的全部论据,后面所有推论都只从这五行里读。
第一行对应 describe(Sq{3}),打印 both sq,走的是 case ShapeNamed。
1 | both sq |
这一行是整篇的关键,Sq 同时满足 ShapeNamed、Shape、Named 三个 case,三个都接得住它,实际执行的只有第一个,也就是排在最上面的那个。第二行对应 describe(NoName{3}),打印 shape only 9,NoName 不满足 ShapeNamed,第一个 case 落空,继续往下落到 case Shape 上,9 是 3 乘 3,来自 Area。
第三行 describe(42) 打印 integer,第四行 describe(nil) 打印 nil,第五行 describe(fmt.Errorf("boom")) 打印 error boom,各自命中各自的 case,一个都没有多走。
五行读完,一张模糊的直觉就变成了一条可验证的顺序关系。我最初以为这三个 case 里会有一个被跳过,事实是前两个都能接住 Sq,真正生效的只有排在最上面的那个,顺序一变,输出就跟着变。
NoName 那行更直白,它缺一个方法,第一个 case 就直接落空,连争的机会都没有。
所以真正被这条规则淘汰掉的是那种看着很像、却总差一个方法的值,它会在第一个严格的 case 上被挡回来,然后一路向下找那个它能满足的接口,找到为止。匹配是自上而下。
type switch 的匹配就是从第一个 case 开始逐个往下比较,命中就停,剩下的 case 不再看。
它不是打分,不会挑最贴切的那一支,也不会因为下面的 case 更具体就跳回去重选,更不会把几个能匹配的分支都执行一遍再合并结果。这条规则把 case 的顺序从一个排版问题变成了一个逻辑问题,顺序写错,代码照样编译,照样跑,只是走到的地方不是你要的,而且不会有任何提示。
编译器不会拦你,静态检查也未必看得见,测试更未必拦得住,只有输出会告诉你。所以改 case 顺序的时候,我心里默认这是一次逻辑改动,得重新跑一遍。
这条规则还有一个副作用,读代码的人也得按顺序读,不能跳着看,因为跳过前面几支直接看下面那个 case,得到的结论往往是错的,你以为它接住了什么,其实根本轮不到它,而写的人如果自己不标注,读的人多半会跳。
把 Shape 写在前面,Name 就永远用不上
这是一个很容易犯的错,我自己就犯过。直觉上把宽的接口先写,好像更安全,反正兜得住,漏不掉,而且宽的放在前面,读代码的人一眼就知道这里兜了所有形状。实际后果是,一旦 case Shape 排在 case ShapeNamed 前面,Sq 就永远走不到 ShapeNamed 那一支,因为它在 case Shape 那里就被拦下了,Name 方法从头到尾没有被调用过一次。代码里那行 x.Name() 还在,看着像活的,其实永远不会执行到,IDE 不会把它变灰,编译器也不会报未使用。更麻烦的是这种顺序不会让程序出错,both sq 变成 shape only 9,两个结果都是合法的字符串,测试里如果只断言非空,照样过,谁也发现不了。它不是排版问题。正确的方向是从具体到宽泛。条件最苛刻、方法集最窄的接口放最前面,宽一点的往后放,default 兜最后。这样每个值都会先被最适合它的那一支接住,接不住的才往下掉,掉到底还有默认分支接着,一层一层分下去,每个 case 都能拿到它真正该处理的那一批值,同一批值也不会被两个分支抢。
这个排法还有个副作用,越靠前的分支越具体,读的人从上往下看,就像顺着一条从窄到宽的河走,哪一段收窄一眼就能扫出来。
反过来排,前面那个宽的 case 会把所有东西全吃掉,后面写的分支等于死代码,编译不报,测试也未必发现,只有哪天你把宽的那个 case 删了,才发现下面的分支从来没被验证过,也从没被谁信任过。
我把这条当成写 type switch 的默认动作,新写一个 switch 的时候先不急着敲 case,先按方法集的宽度把接口排一遍,再往里面填内容,排完再回头看一遍,确认没有哪个宽的挡在窄的前面。
多个类型挤在一个 case 里
一个 case 后面可以跟多个类型,用逗号隔开。合并与拆开差在一个地方:
| 写法 | 分支里 x 的静态类型 |
想拿具体类型 |
|---|---|---|
| 一个类型一支 | 就是那个具体类型 | 直接用 |
| 逗号合并几个 | 退回接口类型本身 | 还得自己断言一次 |
int 和 int64 就是这么并在一起的,describe(42) 打进那个 case,输出 integer。合并之后有一个变化要留意,这时候 x 的类型不再是被命中的那个具体类型,而是接口类型本身,因为一个分支里躺了好几种类型,编译器没法替你挑一个出来,只能退回到最宽的那个静态类型上。这个变化不会报错,也不会在编辑器里标出来,只能靠你自己记住,一旦忘了就要在分支里跟编译器磨半天。上面那两行编译不过,x 在这一支里的静态类型是 any,要转成 int64 得自己断言一次。这不是限制,是必然,分支内部拿到的变量必须有一个统一的类型。合并 case 省下的那几行,代价正好落在这里,分支里每做一次运算都得先把类型拿回来,代码反而更长,读的人也得多跟一步,所以合并只适合那种分支里什么都不做的场合(比如整支只打一行日志),或者只是把值原样传下去。真要在分支里算东西,拆开写的代价其实更小,因为少了来回断言,也少了读的人在心里默默转换一次类型。
我现在的判断很简单,分支体超过三行就别合并,三行以内并一下无所谓,省下来的行数到时候都要还回去。
我现在的习惯是把合并降到最低,最多留一个 int 和 int64 的合并,那种地方本来就不需要知道具体是哪个宽度。合并会丢类型。想拿具体类型,就把 case 拆开写,一个类型一个分支,代价是代码长一点,好处是 x 的类型是确定的,不用再断言一次。
这两种写法没有绝对的好坏,看你在分支里要做多少事,如果只是打一行日志,合并更省,如果要算东西,拆开更稳。真类型写成一个 case,和用逗号隔开有什么区别?
1 | case int, int64: |
.(type) 只能长在 switch 的头上
.(type) 是 type switch 专用的写法,只能出现在 switch 的 guard 位置,也就是 switch 紧跟的那个表达式里。把它单独拿出来用,写成 x := v.(type),是语法错误,编译直接不通过,报错会指在那行赋值上,说这里放不下一个类型断言。这个限制在语法层面,不在运行时,编译器根本不会让你生成这样的代码,也就没有所谓的运行期检查可以绕开它。
我第一次撞上它的时候还以为能拿它返回一个类型值,后来才明白它连值都不产生。这条限制背后是一个很朴素的道理,switch 的每个分支都是独立的,分支里的变量只能由分支自己决定类型,表达式那一侧没法预先给一个统一的选择,只能交给 switch 来做。这也是它为什么长得像断言,却只能待在 switch 里,一点都不通用。原因是 type switch 的每个 case 里 x 的类型都不一样,case ShapeNamed 里它是一个 ShapeNamed,case int 里它就是一个 int,编译器没法在外面给它定一个统一的类型,只能等到分支内部再定。所以它必须贴着 switch 写,让编译器知道该在哪个位置做这次推导。
同理,把 .(type) 塞进函数参数或者赋值语句的右边也不行,那几处的类型是编译期就要定死的。
1 | x := v.(type) |
断言失败不 panic,但要还你一个零值
.(T) 是单个类型断言,单值形式失败会 panic,程序直接停在那里,错误信息里带着实际类型和你想要的那个类型。写成 q, ok := a.(T) 的双值形式就不 panic,ok 告诉你成没成。这里有个细节容易忽略,失败的时候 q 不是没有,它是 T 的零值,照常可以打印,照常可以拿去参与运算,编译器也不会因为这个值有问题而提醒你一句。
双值形式是 Go 里少数几个拿第二个返回值当异常用的地方,习惯别的语言的人容易只取第一个。
1 | var a any = Sq{3} |
1 | assert to Shape ok 9 |
如果没有检查 ok 就直接用 q,程序不会崩,只会安安静静拿到一个零值,然后拿这个零值继续算下去。错误被推迟到很远的地方才现形,等到那时候,现场早就没了,日志里只剩下一个看起来完全正常的 0。
零值不一定是失败。反过来读也成立,看到一个 0 不能断定断言失败,因为一个真的 NoName{Side: 0} 断言成功,Side 也是 0。
case nil 问的是接口本身
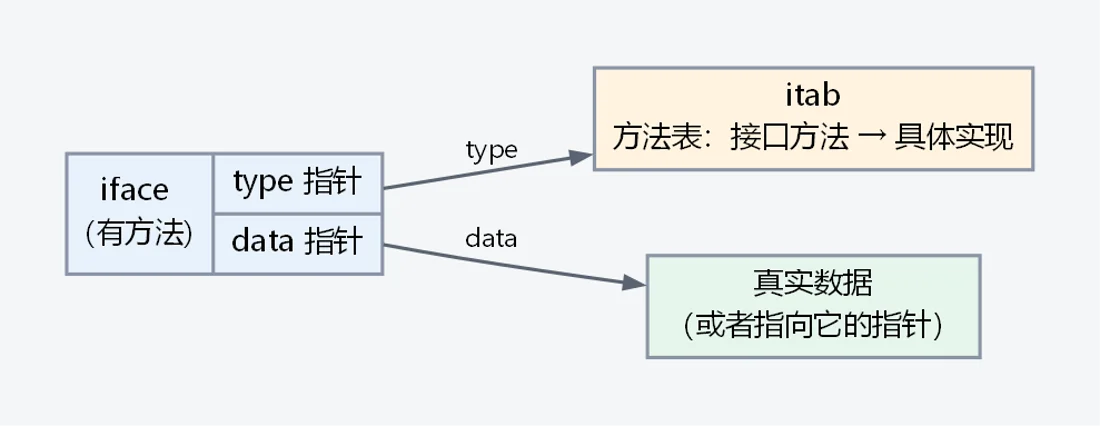
case nil 匹配的不是某个类型,它问的是这个接口值本身是不是 nil。这个区别很实在,一个装了 nil 指针的接口,接口本身不是 nil,它还是两个字,第一个字是类型信息,第二个字是空指针。
这样的值不会命中 case nil,会命中它实际的那个类型,因为它的第一个字是有东西的。
这也是 typed nil 那类问题的入口,返回值声明成 error,实现里返回了一个 (*MyErr)(nil),接口本身不是 nil,调用方 if err != nil 会成立,然后拿着一个空指针去调方法,崩在离现场很远的地方。它还留着第一个字。describe 里把 case nil 放在最前面是有意的,它是唯一一个不看方法集的分支,问的问题和别的 case 完全不同,所以摆在哪儿都行,放在最上面只是让它读起来更顺,也让下面几个接口 case 的层级关系完整地露出来。
没有 default 的 switch 什么都不做
default 不是必需的,可以完全不写。没有默认分支又没有 case 命中时,type switch 直接结束,后面的代码照常往下走,一支都不执行也是完全合法的结果。这里容易漏,是因为写 type switch 的时候,脑子里往往把它当成一次分派,默认最后总有一支会被执行。
一支都不执行才是常态。
两次都没有报错,都是盯着输出才发现的。
它不吵,所以更要自己看。
实际上一支都不执行的时候,函数会安静地返回到下一行,返回值是零值,看起来就像处理过了,调用方根本分不清是真处理了还是悄悄滑过去了。所以我在 describe 里留了 default,哪怕它只打一行 unknown。留下的好处不是多一个分支,是把没有考虑到的情况显式摆到台面上,跑的时候一眼能看见,不用等到线上出了一个莫名其妙的结果再回头查。
不留默认分支的时候,漏掉的值会静默地穿过去,这两种做法都能跑,区别在于出错的时候你多久能知道,以及知道的时候手上还剩多少线索。default 并不是为了兜底数据,它是为了让漏掉的值有个地方说话,写的时候多想一步,改的时候少查一天。
这坑我踩过两次。
第一次把 Shape 排在前面,Sq 全进了错的那支。
第二次是断言之后没看 ok,直接拿 q 去用,拿到的是 0,还以为是数据本身算错了。