队列为什么会把内存吃光
队列为什么会把内存吃光
隔壁老康难度 ★★☆☆☆ · 前置:栈不只在函数调用里 | 一句话结论:无界队列把生产比消费快这件事,从延迟变大偷偷换成了内存涨上去不回来,而且出队不会让底层数组还一个字节;有界队列加背压才是把它摆回台面的做法。
给一个内部服务加了条异步落库的路:接口把请求收下就返回,写库交给一个常驻的 goroutine 慢慢做。上线那周 P99 从四十毫秒掉到八毫秒,我在周会上还挺得意,觉得自己把一条阻塞路径切干净了。两个月后同一个接口开始拖,监控里那根内存曲线从一条平线变成一道斜着往上爬的坡。
坡不回头的。
我先去查数据库,慢查询日志干净,连接池没打满。再翻 GC 日志,回收频率正常,每轮能收回的量也没见少。对象的数量没有越涨越多,是有东西一直被攥着没还。
翻到第七个文件才逮住它。
是我自己写的:一个 []job 切片配一把互斥锁,投递就是 append,取走就是把下标往后挪一格,从头到尾没人给它设过长度上限。写端在 HTTP 处理函数里,读端只有一个 goroutine,中间还要串三次外部调用。流量小的时候写端和读端刚好打平,流量一上来,写端一秒塞进去的量读端追不上,而这件事没有任何地方会报错。
没有上限这四个字,就是全部病因。
队列这个词太顺口。顺口到我写它的时候只想到进和出,没想到它同时也是一块内存。写那段代码时我脑子里是一根管子:左边进,右边出,中间那段空着,两头接上就算通。管子当然有粗细,可粗细这件事在管子的概念里压根不存在,所以我一格都没想过要给它定个数。
管子有粗细,我没量过。
队列只答应三件事,第四件得你自己补
把队列剥到只剩语义,它能承诺的东西确实只有三条。一端进一端出,先进来的先出去,两头各管一头:写的人不必知道谁在读,读的人不必知道谁在写。三条都在讲顺序和耦合,没有一条讲数量。
顺序是顺序,容量是容量。
这里有个很容易滑过去的地方。先进先出说的是相对次序,它保证先来的先被处理,但对总量一个字都没说。一百条是这个语义,一亿条也是这个语义,只要还按顺序出队,两条都算队列在正常工作。所以当有人问队列会不会撑爆内存,语义层面压根没有答案,它压根没打算回答这个问题。
顺序归顺序,容量还得自己给。顺序和容量是两件正交的事,语义管前一件,后一件必须由写代码的人在某一处显式地定下来。他不写,等于默认不设限,而不设限的东西,一定会在某个夜里用你不想看的方式告诉你它有多大。还有一层更细的:容量不写,长度也就没人盯。队列里此刻有多少条,在 append 那版里其实一直读得出来,len(q.buf) - q.head 就是,可它从来没进过任何一块监控面板,因为我压根没觉得自己需要知道。没盯的东西不会自己变好,只会自己变大。
不设限,就是把决定权推给运行时。
不设上限,等于把消费不过来翻译成内存上涨
生产比消费快,本身不是故障。任何系统都有峰值,一秒进来两千条、一秒只能处理八百条,结构上完全正常。问题在于这件事被记在哪里,谁去承担那个差额,以及承担的方式是当场疼还是攒着疼。
有界队列把它记在写端:满了就推不进去,推不进去就得等、就得报错、就得让上游慢下来。这个过程有点难看,接口要返回 429,日志要刷一串拒绝,上游同事会来找你。但它准确,压力当场就传回去了,谁快谁慢一目了然。
看起来像是坏消息的那个选项,其实是唯一会说话的那个。
无界队列把它记在堆上。写端永远成功,接口永远很快,没有任何人被拒绝,看起来一切正常,只有进程的 RSS 在往上涨。同一个消费不过来,在有界队列里长成一次失败,在无界队列里长成一段内存。延迟变大是能感知的,内存涨是感知不到的,直到它涨到机器扛不住,或者被人从监控上看见。
这边不报错,那边就得报错。
我那个服务铺在四台机器上,每台八个 G。按一秒积压三百条、每条六十四字节算,一小时是七十兆上下,一天一点六个 G。数字本身不算吓人,吓人的是它只往一个方向走:消费能力没有恢复,堆就不会自己降。这些对象还得被 GC 一遍遍标记,堆越大,每轮标记越久,两边一凑就成了正反馈。更要命的是这条坡没有平台期,它只是一条更缓的直线,缓到你能在一个季度里都以为它正常。回头看我那两个月,曲线每次看都只是比上周高一点点,单看任何一天都像正常抖动。
一百万条压进去,七十五点一兆,出队一半一个字节不还
我为了把这件事量清楚,在测试里写了一个最朴素的切片队列,元素固定六十四字节:一个 int64 的 id、一个 int64 的时间戳、再加四十八字节的负载,加起来正好一条缓存行。
1 | type item struct { |
推一百万条进去,runtime.GC() 之后读 HeapAlloc:七十五点一兆。平均每条七十九字节,len 是一百万,cap 是一百二十三万一千二百三十二。后者乘六十四字节,正好七十五点一兆。多出来的那十五兆不是切片头的开销,是 append 扩容留下的空位:cap 比 len 多出来二十三万格,一格六十四字节,一样占着堆。三段加起来是六十四,不是六十五也不是六十三,这个数不是随手挑的,一条缓存行正好一行,元素本身跨行的开销被排除掉了,剩下的差全部来自队列自己的写法。八字节加八字节加四十八字节,一个不多一个不少,印出来就是六十四。
然后出队五十万条。
堆变化负零点零一兆。cap 还是那个一百二十三万一千二百三十二,head 变成了五十万。我能等,GC 也等了好几轮,那个数组一格没少。这个结果事先就能猜到:buf 还是那个切片,append 只在尾巴上加,没人从头上摘。
队列的长度从一百万降到五十万,占的内存一点没变。
head 是个整数,它往前走的意思是前面那段我不再看了,不是前面那段被还掉了。底层数组只要还被 buf 指着,GC 就没有理由动它。切片这种结构天生只能从尾巴上长,前面空出来的位置它记不住,也用不上,那一段就一直挂在那儿,直到整条队列被丢掉。它所有的内存成本都记在历史峰值上,跟你此刻手里有多少条无关。 峰值一百万条,这条队列从此按一百万条收费,哪怕它现在只剩一条。空着不等于还了,这是两件事,中间隔着一次 copy,而大多数人不会为它写那次 copy。要还也简单,出队到某个水位就把剩下的搬回数组开头,代价是一次 O(n) 的搬运,做不做又是个取舍。
换成环形队列,容量定死一万,满了覆盖最老的,同样推一百万条:堆零点五七兆,队列里始终是一万条。
七十五点一兆对零点五七兆,一百三十一倍。
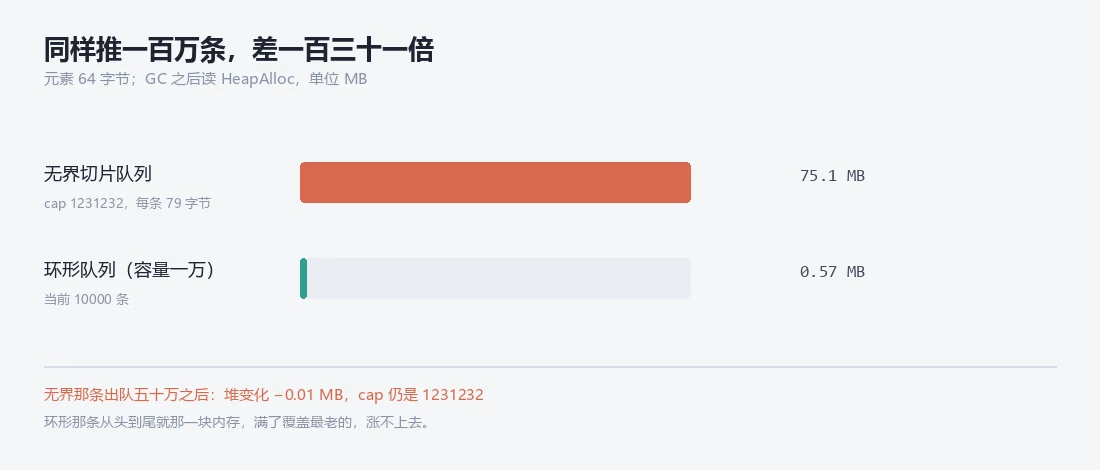
横轴是推进去的条数,纵轴是 HeapAlloc。切片那根是一级一级的台阶,扩完不下来;环形那根从第一条到第一百万条几乎是平的。
台阶在这里有代价。切片的扩容是另开一块更大的、把旧元素全搬过去,旧的那块在搬完那一刻才死。所以扩容的瞬间进程同时占着新旧两块,峰值比稳态还高一截。
头一回量堆,我量出了两倍的数
上面那组数是第二次跑出来的。第一次跑完,终端上写着一百三十五点二兆,每条一百四十二字节。
我拿这两个数去跟同事说,他问了一句:读之前 GC 了吗。
没有。那一版测试里,ReadMemStats 是紧接在收尾那次 Push 后面调的。刚构造出来还没被引用的对象、扩容时扔下的旧数组、测试框架自己的一些临时数据,全都还挂在堆上算数。这些垃圾在下一轮 GC 里会消失,可我读得太早,把它们一起记进了账。
加上 runtime.GC(),同一个测试,同一个进程,七十五点一兆、每条七十九字节。
差了将近一倍。
量堆跟量别的东西不一样。耗时、次数、字节数写多少就是多少,堆是一个还没结清的账本,垃圾是已经死掉但还挂在账上的对象。不先强制收一轮,读到的就是账面余额,不是实际欠款。顺序也得对:runtime.GC() 在前,ReadMemStats 在后,中间别再分配东西,否则你自己新申请的那点内存又会被算进去。这条规矩听起来像废话,可它的量级不是小数点后几位,是整整一倍,足以让一个结论反过来说。我后来给所有量堆的测试都加了这一行,加完再没出现过两个版本对不上的情况。
一百四十二字节和七十九字节,两个都真,但只有一个能拿去跟别人比。
十六到二十五倍,藏在一个取模里
既然切片只在尾部 append,推一条的成本该跟环形差不多才对。我拿 testing.B 量了一遍,容量一千零二十四,推一条再弹一条,各跑三次。
| 写法 | 三次 ns/op | B/op |
|---|---|---|
| 切片队列:append 推,head++ 弹 | 169.2 / 156.4 / 101.6 | 334~383 |
| 环形队列:取模算下标 | 9.521 / 8.350 / 9.717 | 0 |
| 掩码队列:容量取二的幂,& 代替 % | 6.172 / 5.404 / 6.060 | 0 |
差距在十六到二十五倍之间,掩码版又比环形快三成五,九点五纳秒降到六点一。
九点五纳秒对一百六十九纳秒,差的不在数据结构,在内存分配。切片那 334 到 383 字节不是每次都有,是 append 摊下来的:绝大多数推入不扩容,偶尔一次要开新数组、搬全部元素、扔掉旧的,均摊到每一步,每次推入就背了三百多字节的分配账。这条账迟早会以 GC 的形式还回来,堆越大还得越久。三次跑出来的数没一次重复,一百六十九、一百五十六、一百零一,离散得厉害,原因也在这儿:扩不扩容决定这一次是几纳秒还是几百纳秒,平均值被少数几次搬运拉高了。所以你看到的 169.2 和 101.6 不是两台机器的差别,是同一个进程里扩容撞没撞上的差别。
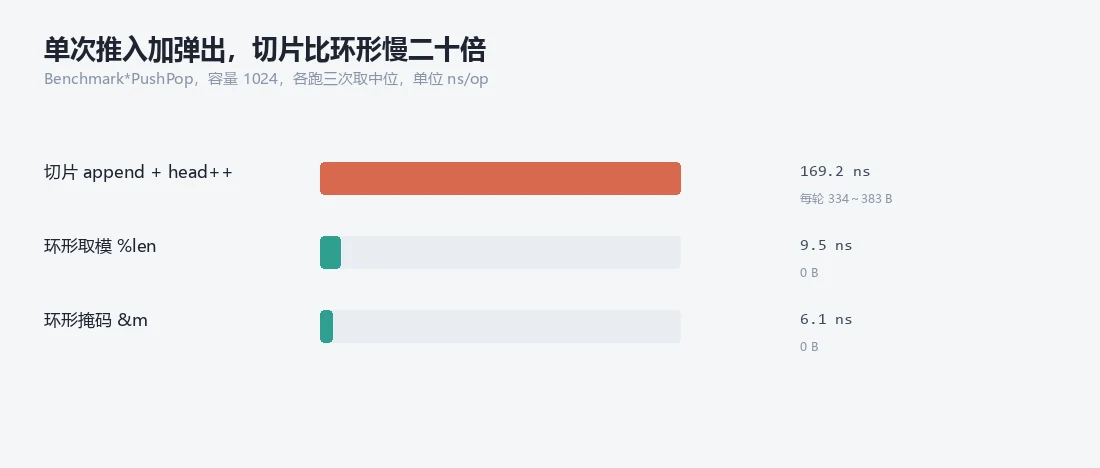
环形那两种写法,推一条就是一次赋值,没有 append,没有扩容,B/op 是零。把容量定死这件事,在性能上不再是限制。
掩码那百分之三十五差在一次除法。
tail % len(buf) 是一次真除法,除数是变量,编译期消不掉,硬件上得走慢路径。容量取成二的幂之后,tail & m 在二进制上跟取模等价,但它是一条与指令,一个周期。
1 | type maskQueue struct { |
m 是 n-1,n 必须是二的幂,这个前提不在类型里,只能写在注释和构造函数里。改容量的人看不见它,就会踩。踩法很安静:容量写成一千,m 就是 999,tail & 999 只碰得到二百五十六个格。我原以为那是 0 到 255,跑完发现不是——999 的二进制是 1111100111,中间夹着两个 0 位,掩码把地址切成了三十二段、每段八格(0–7、32–39、64–71,一直到 960–967 和 992–999)。我拿这个错误版本跑了十万次推入,落过的下标刚好二百五十六个,最大那个是 999。队列看起来在转,实际上四分之三的空间白占,剩下七百四十四个格永远不写。
容量写不写,是接口签名的一部分
我后来把那把锁和切片一起删了,换成一个定长一万的环形,满了直接覆盖最老的,再在投递的地方加一句:覆盖计数每秒涨得比零多,就打一条日志。这个改动有一个直接后果,高峰期的老任务会被丢掉。
这是一次真实的取舍,不免费。
但它把一件模糊的事变清楚了:这个队列最多装一万条,超出的部分会丢,丢了多少我能看见。之前那一版什么都没丢,只是把丢没丢的问题挪到了堆上,等 OOM 才第一次被人知道。
有没有更中间的做法?多了。满了就阻塞写端,或者返回错误让调用方自己重试,或者做双阈值:水位到七成就开始给写端限速,到九五成开始拒绝。这些做法有一个共同点,都在某一个确定的位置上,把不行说出口。
队列的容量不是实现细节,它是接口的一部分。它决定了推不进去的时候会发生什么:是等、是丢、是报错,还是让内存替你顶。这四种行为对调用方来说完全不同,而它们只由你写不写那个上限决定。所以我现在的习惯是,写任何队列,第一步先把容量写出来,哪怕只是 make([]job, 0, 1024) 再加一句到顶就拒绝。这一步花不了十分钟,但它决定了半年后半夜被叫起来的那个人是不是我。
容量没写出来的队列,不叫容量大,叫没设限。没设限的东西,第一次被人知道的时候,通常已经是内存报警了。