索引长成一棵 B+ 树,是被磁盘逼的
索引长成一棵 B+ 树,是被磁盘逼的
隔壁老康难度 ★★★★☆ · 前置:磁盘上不能用二叉树 | 一句话结论:B+ 树把数据全放叶子、把叶子连成链表,为的是让一次范围查询只走一条链,而不是回头爬树。
我把 orders.db 当成一个二进制文件打开,seek 到第 2 页,读了它的头十二个字节。那天我想弄明白的事很具体:一条 user_id 等值查询,加索引之后 0.47 毫秒,不加 21.91 毫秒,这四十六倍省在哪一页上。表是我自己建的,六列,一百万行,page_size 设成 4096,行摊在七千多个页里。树矮所以快这种说法我一开始也不信,矮多少、快在哪一段、中间那笔账怎么算,还是得把它拆到页一级自己看一遍。
偏移 0 那个字节是 5。
5 是内部表页。SQLite 给每一页只发一个身份,2 是内部索引页,5 是内部表页,10 是叶子索引页,13 是叶子表页,这四个数我一开始一个都不认得,翻了半页 file format 文档才敢确认。5 意味着这一页上不放任何一行 orders 的数据,只放指向下一层的指针,外加末尾一个最右指针。偏移 3 到 4 是两个字节的 cell 数,读出来 17。偏移 8 到 11 是四个字节的页码,指着第 18 页。十二个字节把一整页交代完了。
一百万行,根页上只有十七个键。
我本来只想确认那句到处都能看到的话,数据只在叶子。真读下去才发现重点不在数据,在叶子。行确实不在这一页,也不在第二层的任何一页,要一路走到底才第一次碰到 orders 的行。SELECT * FROM dbstat 走不通,本机这个 SQLite 3.50.4 编译时没开那张虚拟表,直接报 no such table,我只好写个十几行的脚本,按页号广度优先往下走,每到一个页就把页类型和 cell 数记下来。
1 | PAGE = 4096 |
三层走完,七千页出头,文件读了两遍。
页数差了一页,那页不在树里
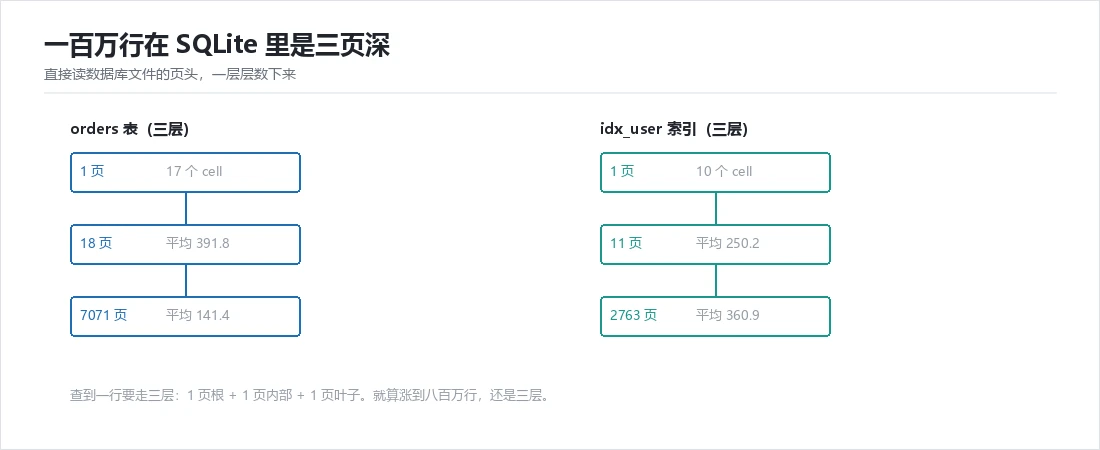
先把数摆出来。表树第一层 1 页 17 个 cell,第二层 18 页、每页平均 391.8 个,最少 340 最多 410,第三层叶子 7071 页、每页平均 141.4 行,最稀的一页只装了 8 行。索引树也是三层,1 页 10 个 cell,第二层 11 页、平均 250.2 个,叶子 2763 页、平均 360.9 条。两边层数一样,密度的分布完全两样,表的叶子稀、索引的叶子密。这个差别是倒推出来的,一页四千零九十六字节除以行宽,行越宽装得越少,两条线本来就该分开走。
三层页数加起来 1 + 18 + 7071 = 7090,文件里写的却是 7091 页。
我以为是脚本把 freelist 上的页也算进去了,来回翻了半小时。
老周路过看了一眼,说第 1 页放的是 sqlite_master,orders 的根页在第 2 页,你从第 2 页起数,那不就少一页。
对,是我把 schema 忘了。
数对上了,能看的东西才多起来。根页 17 个 cell 加末尾那个右指针,正好 18 个孩子,落在第二层的 18 页上。第二层每页平均 391.8 个 cell,18 页乘出来 7052,再把每页末尾那个没有 key 的右指针加上,7070,跟叶子页数 7071 差一。差的那一是平均值反推的误差,391.8 本身四舍五入过,真值落在 7052 到 7053 之间,加上十八个右指针正好把 7071 盖住。索引那边严丝合缝,1 + 11 + 2763 = 2775,跟它实际占掉的页数一条不多。
数自己闭合了,说明我没有漏页。
内部页只带钥匙,叶子页才带整行
内部页的 cell 是两样东西,一个 id,一个四字节页号。叶子页的 cell 是六个列拼起来的一整行。如果内部页也带整行,也就是 B 树那种每层都存记录的做法,一个页装得下的孩子数就跟着掉下去,它得先塞下六列,一行摊开大约二十九字节,再把四字节页号摊回每一行,一页四千零九十六字节除下来是一百四十出头,扇出从 392 掉到 141 上下。这个差价能算:三层树能装的行数,B+ 树这边是 392 × 392 × 141,两千一百多万行,每层都带整行的话是 141 × 141 × 141,两百八十万行,同样是三层,容量差 7.7 倍。
多一层就多一次页读。
更贵的地方还不在容量。B 树里行散在每一层,一次查找可能半路就命中,一次范围扫描走到一段的尽头却没有链可走,只能退回父页,挪到右边一个孩子,再下去。每一次回退都是一次新的页读,而且那个父页多半早就被别的访问挤出了缓存,读回来又是一次完整的寻道。两千万行的时候,一边还是三层,另一边已经在修第四层了。
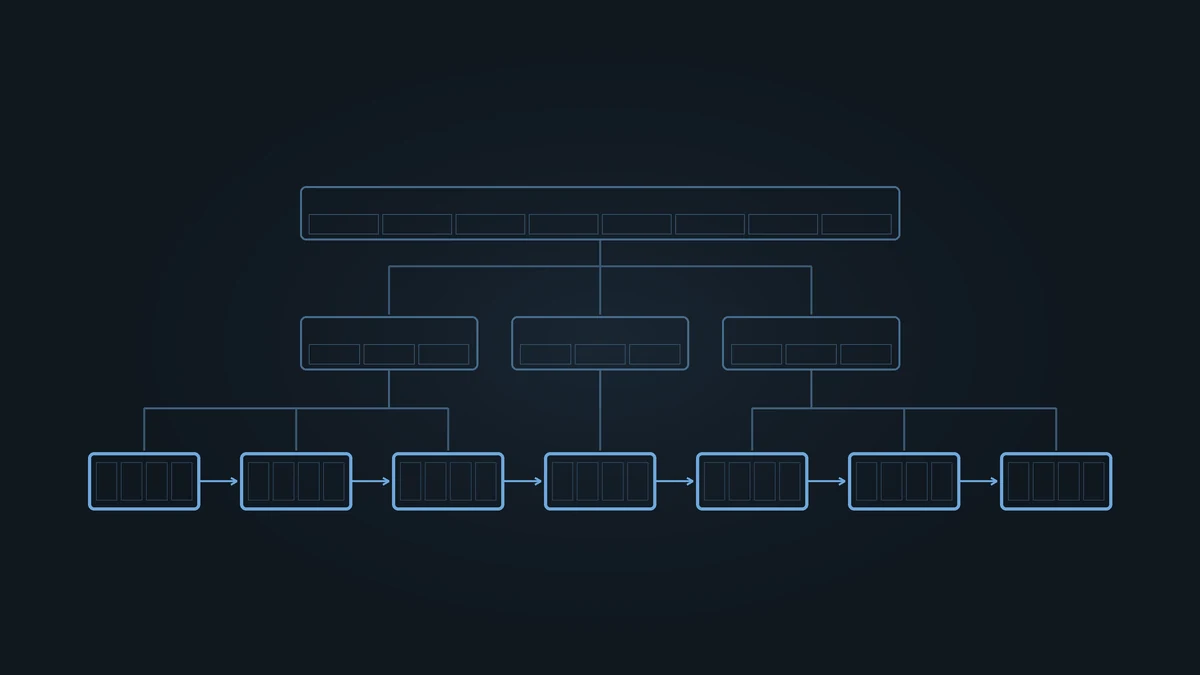
一份设计拆成两半,内部页专干指路,叶子专干装货。
一条链把范围查询从爬树改成走路
between 那条查询,3.4 倍。
两千一百行取出来,无索引 23.94 毫秒,有索引 7.11 毫秒。这两千一百行按每页 141.4 行摊开,落在十五个表页里,这十五页在索引里是挨着的,在表里不挨着。索引叶子按 user_id 排,行的物理位置按 id 排,两个顺序之间没有关系。所以那 7.11 毫秒分成两笔:一笔在索引上顺着链走十五页,另一笔是把两千一百行逐个取出来,跳两千一百次,每一次都可能落在一页新的表页上。
链省掉的是找,不是取。排序那两行更能说明链值多少钱。order by user_id limit 20 0.35 毫秒,93.7 倍,它连根都没怎么回,从最左的叶子进去,顺着链数二十个 cell,取二十行,收工。另一行 limit 20 offset 30000 2.06 毫秒,50.2 倍,比上一行多了一点七毫秒,这三万多个 cell 全在索引页里走过去,一次回表都没有,因为 SQLite 到第三万零二十个才去表里取行。索引在这儿不只是查找结构,它本身就是一份提前排好的副本。
顺序不要钱,位置要钱。
表自己就是一棵按 id 排好的索引
id INTEGER PRIMARY KEY 在 SQLite 里是 rowid 的别名,所以这张表本身就是一棵按 id 排好的 B+ 树,行就住在叶子上。聚簇索引说的是这件事,数据跟主键挤在同一棵树里,主键的顺序就是行在文件里的顺序。二级索引是另外一棵树,idx_user 的叶子里存的不是整行,是 user_id 和 rowid 两样东西,一百万条摊到 2763 页上,一条平均十一字节出头,这是它只占 10.84 MB 的原因。
存 rowid 而不是存一个地址,是因为地址会变。页装满就分裂,一半的 cell 搬到新页去,原先记下的偏移量全都指错地方。整表重建的时候行也会挪。rowid 不跟着搬,它是行在那个表里的身份证,除了重建整张表,它一直是那个数。
代价是取一行要多跳一次。
索引告诉你 rowid 是 418233,你要的那五列还在表树里,得拿着这个数再去表树走一遍,从根到叶子,三次页读。
稳定比快重要,跳一次就跳一次。
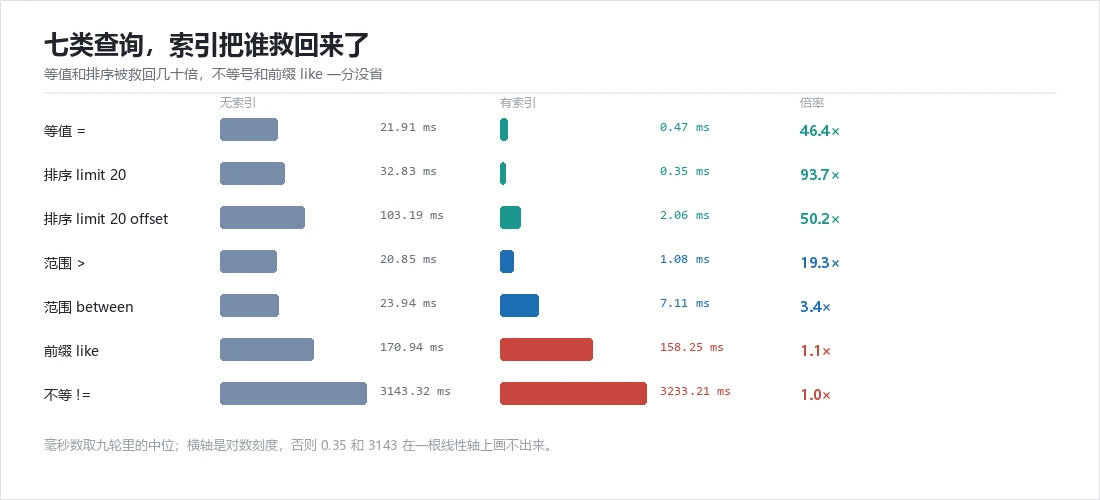
回表这件事,二十行看不出来,一百万行藏不住
同一批数据我又建了一张五列的表,加了联合索引 (user_id, status)。select user_id, status from t where user_id = 12345 走 COVERING INDEX,最快 0.13 毫秒、中位 0.36。把 amount 也取上,计划没变,可它得回表了,0.40 和 0.41。结果集只有二十二行的时候,回表就是二十二次随机页读,运气好全落在缓存里,几乎不要钱,我一开始看的正是这个数,差点顺手写下回表可以不管的结论。
把结果集放大到九十九万九千九百七十八行,同一件事换了个量级。select count(user_id) from orders where user_id != 25000 走 SCAN orders USING COVERING INDEX idx_user,76.463 毫秒,因为它只碰索引,一行表数据都不用取。同样这个条件,把六列里的五列取回来要 1053.791 毫秒,十三点八倍。
回表的单价是一页,行数是乘数。七条查询,同一张表,加索引前后各跑九轮,预热一遍之后取最快和中位:
| 查询 | 无索引(最快/中位) | 有索引(最快/中位) | 中位倍率 | 计划 |
|---|---|---|---|---|
等值 user_id=25000 |
21.41 / 21.91 ms | 0.34 / 0.47 ms | 46.4× | SEARCH USING INDEX |
| 范围 between | 23.51 / 23.94 ms | 4.91 / 7.11 ms | 3.4× | SEARCH(两边界) |
| 排序 limit 20 | 32.12 / 32.83 ms | 0.34 / 0.35 ms | 93.7× | SCAN USING INDEX |
| 排序 limit 20 offset 30000 | 101.26 / 103.19 ms | 1.26 / 2.06 ms | 50.2× | SCAN USING INDEX |
范围 >49990 |
20.43 / 20.85 ms | 0.97 / 1.08 ms | 19.3× | SEARCH(单边界) |
不等 !=25000 |
2743.93 / 3143.32 ms | 2744.25 / 3233.21 ms | 1.0× | SCAN orders |
前缀 like 'n12%' |
148.85 / 170.94 ms | 140.38 / 158.25 ms | 1.1× | SCAN orders |
五条掉下去,两条原地不动。
算不过账的时候,规划器直接放弃索引
!= 那张计划我看了三遍,加不加索引都是 SCAN orders。
一条 != 能拆成两段区间,小于 25000 的一段和大于 25000 的一段,两端都落在索引上,都能走。规划器还是不走,因为摆在它面前的是两个数:走索引要回表九十九万九千九百七十八次,扫表只要顺序读七千零七十一页。随机读和顺序读不是一个价,一页随机读抵得上十几页顺序读。我原本以为是不等式没法转成区间查找,把计划打出来才明白,它压根没打算找,它在比价。
索引没坏,是这笔买卖不划算。
前缀 like 是另一码事。note 上根本没有索引,idx_user 对 'n12%' 一点忙也帮不上,两边都扫表,1.1 倍是文件变大之后的抖动,两边的数落在同一个区间里。真要让前缀走上索引,得在 note 上单独建一棵,而且建的时候用的排序规则要和查询里的一致,否则索引里那一列的顺序跟 'n12%' 需要的顺序对不上,规划器照样不会用。
索引不是一列有就行,得是这一列、这个顺序、这个比较规则,三样齐了才轮得到它上场。
十点八四兆买的是副本,不是三次页跳
建索引这个动作本身也要花时间。同一个 CREATE INDEX,命令行里冷跑 357.9 毫秒,Python 里单独一条 1420.9 毫秒,差了四倍,两边跑的不是同一套 PRAGMA,Python 那边开着 WAL,还多算了一次提交,这两个数我没并成一行,谁引用的时候记得带上环境。文件从 7091 页涨到 9866 页,27.70 MB 变成 38.54 MB,多出来的 2775 页正好 10.84 MB,涨幅 39.1%。
建的过程不神秘,把一百万条 (user_id, rowid) 排一遍,再从最左的叶子开始,一页填满换下一页。顺序填只碰最右边那一页,页分裂少,所以它比一条一条 insert 快得多。真要一条一条插,一百万个 key 随机落进树里,每次分裂都得把一页的 cell 拆成两半,写放大立刻上来(写放大就是写进去一字节,盘上挨了几字节)。
读的账记在查询上,写的账记在每一次插入上。
形状只保证三件事,其余的都归写入
这棵树能保证的只有三件事。给一个 key,三次页读找到行;给一段 key,顺着叶子链走过去,不用回头;给一个顺序,索引本身就是那个顺序,不用排。这三件事跟数据量几乎无关,行数翻十倍,多的是最底下那一层的页数,不是层数,一百万行三层,两千万行还是三层,读一行的页数不变。代价也清楚,写在另外三处:一行数据存在两个地方,写入要写两遍,叶子只装得下一百四十来行,页分裂来得频繁,索引自己吃掉 39% 的文件。
形状是拿这三样换那三样的。那个脚本我又跑了一遍,这次只打印每层的页数和 cell 数,不打印树。三行,1、18、7071,跟第一次一模一样。看久了会觉得这棵树长得有点笨,根页只挂十八个指针,中间那层也没坐满,绝大部分空间摊在最底下。我原来以为这是设计上的浪费,量完才转过弯来,正是这种头小身子大的形状,让一次等值查询只读三页,让一次范围查询只走一条链。脚本量不出来的东西还有一样,是分裂的历史。表叶子平均一页装一百四十一行,最少那一页只装了八行,这个差不是谁设计出来的,是插入顺序留下的痕迹,裂开之后两边各让一半,后来再没填满过。索引叶子平均三百六十一,最密的一页塞了四百一十二,因为它本身窄,一页能兜住的条目多。这一层我这次没往下追,只把几个极值抄在备注里,等哪天要调填充因子再回头看。填充因子就是留给未来插入的空位比例:SQLite 用 PRAGMA page_size 只能间接影响,MySQL 的 innodb_fill_factor 能直接压一页最多填到九成。顺序插入时它几乎不花钱,因为新行总是落到最右边那页;随机插入时它决定分裂什么时候来,压得越低写放大越小,代价是树更高一层。这根旋钮和这一篇讲的“页是收费单位”是同一件事的两头。