布隆过滤器为什么会误判

布隆过滤器为什么会误判
隔壁老康难度 ★★★★☆ · 前置:一个 bit 当六十四个 bool 用 | 一句话结论:误判率由每 key 位数决定,它赢的是内存不是速度,删除得换计数布隆。
一个查不到的东西,布隆过滤器有百分之一的概率硬说它存在。
这不是 bug,是它被设计出来的理由。
在数据库前面挡缓存穿透、给一亿条 URL 去重、让 LSM 树判断一个 key 在不在某个 SSTable 里,套路是同一个:先问一句便宜的,再决定要不要付昂贵的查询。便宜到什么程度,一亿条 URL 一百二十兆上下,一台机器随便塞,甚至能跟着进程一起发出去。代价写在名字里,它只回“可能存在”,不回“在”。位数组的每一位都被若干 key 共享,一次查询看见的是若干个 1,看不见这些 1 是谁写的;从被反复涂写的位里反推“这个 key 来过”,本来就不可能精确。所以它只能当筛子:说不在,直接返回;说在,回去问精确结构。顺序反了,虚报就成了错误。
不少系统把它挂在缓存旁边,后面却没接一个能给确定答案的东西,到头来怪它不准。
二十行,和一个不肯松口的判断
布隆过滤器只有一个位数组,和 k 个哈希函数。加一个 key,算出 k 个位置,全部置 1。
查一个 key,同样算出 k 个位置:只要有一个是 0,这个 key 一定没进来过;k 个全是 1,只能说“可能”。
0 是确定的,1 是不确定的。
这个不对称是全部的根,也是它所有毛病的来源。它不会漏报,只会虚报。反过来,任何一次删除都可能让某个位从 1 回到 0,而这个位还撑着别的 key,漏报就出现了。所以普通布隆的“不漏报”有前提:建好之后不再删。还有一层更少被提到的前提,哈希得均匀,key 之间得独立,否则公式给的误判率只是纸面数字。它的查询也不返回原因,没有 key 的痕迹,没有计数,只有一个是非题和百分之几的“是”。排查时这一点很要命,你只能知道它说在,不能知道它凭什么说在。
二十行,没有树,没有指针,没有扩容。
1 | type Bloom struct { |
代码里用两个 64 位哈希拼出 k 个位置:h1 加上 i 乘 h2。独立算 k 次哈希更随机,可那点 CPU 会盖过查位本身。
Kirsch 和 Mitzenmacher 证明过,这样拼出来的误判率与独立哈希同阶,只是公式要乘一个小修正。
位数组大小 m 和哈希个数 k 是仅有的两个旋钮。m 决定内存,k 决定每次查几个位。
读可以完全无锁:只碰位数组,不写任何共享状态。写要小心,k 次置位不是原子的,两个 goroutine 同时改同一个 64 位字会丢更新。这里丢的不是精度,是漏报。本该为 1 的位没写进去,之后所有靠它的 key 都会被判成不在,一个都不剩。按字做原子或,或者把数组切成几段各配一把锁,都能兜住。查询侧的成本不随并发涨,它才敢站在最前面。
误判率跟着位数走
一百万个 key,一百万个确定不在集合里的查询,i9-14900HX 上跑出来的。
| 每 key 位数 | k | 实测误判 | 理论误判 | 内存 |
|---|---|---|---|---|
| 7.000 | 5 | 3.4639% | 3.4658% | 0.83 MB |
| 8.000 | 6 | 2.1391% | 2.1577% | 0.95 MB |
| 9.585 | 7 | 1.0086% | 1.0040% | 1.14 MB |
| 12.000 | 8 | 0.3182% | 0.3142% | 1.43 MB |
| 16.000 | 11 | 0.0445% | 0.0459% | 1.91 MB |
| 20.000 | 14 | 0.0059% | 0.0067% | 2.38 MB |
每 key 7 位时,五个哈希,误判 3.46%;给到 20 位、十四个哈希,误判 0.0059%。
内存从 0.83 MB 涨到 2.38 MB,不到三倍,误判率掉了将近六百倍。7 位那档,差不多每二十九次查询就有一次白跑。
换真实数据复核:一亿号段里的订单号,先做一次 hash64 再进过滤器,m/n 仍是 9.585,k 仍是 7。
一百万次查询里 9859 次误判,0.9859%。随机整数那组是 1.0086%,同一量级,哈希没把分布搞坏。
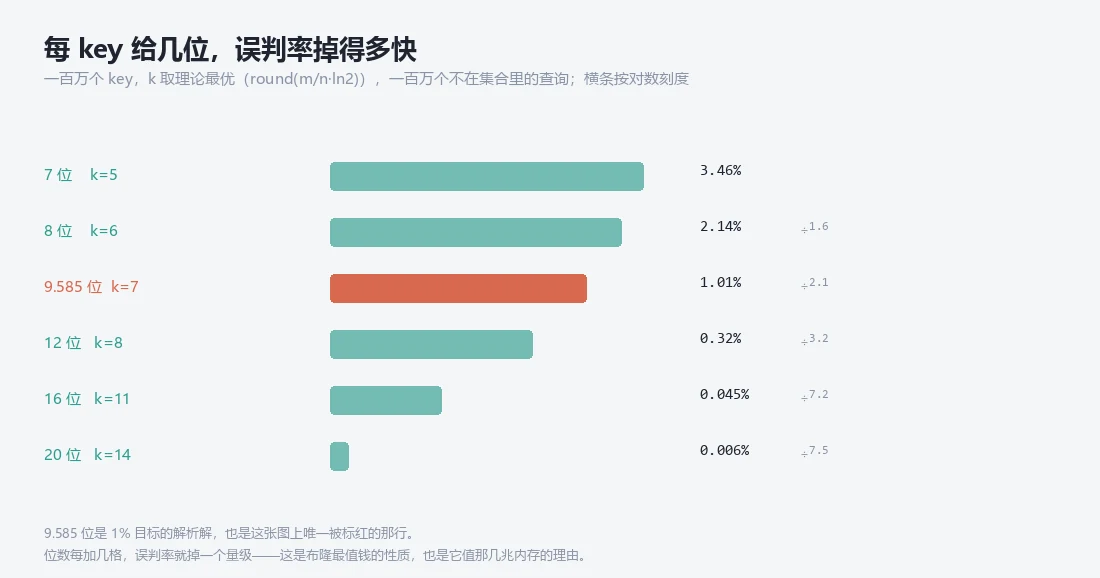
图里六条横条是对数刻度,肉眼看到的长度差,就是几个数量级的差距。
9.585 是怎么算出来的
目标误判率 p,每 key 位数 b = m/n,最优哈希个数 k = b·ln2,此时 p = 2^-k = 0.6185^b。要 1%,2^-k = 0.01,k = log2(100) = 6.64,取整到 7,再反推 b = 6.64/ln2 = 9.585。所以 9.585 位不是经验值,是 1% 这个目标的解析解。k 取 round(m/n·ln2) 也是同一个式子,位数定了,最优哈希个数就定了,多一个少一个都更差。工程上记两个数就够:每多一位,误判率乘 0.6185;内存翻倍,误判率变成原来的平方。
取整会带来偏差。k 从 6.64 取到 7,理论误判 1.0040%,实测 1.0086%,差 0.0046 个百分点。
这点差是采样噪声,不是公式错了。想稳稳压到 1% 以下,位数往上多给一点,或者接受这个零头。
一位不是一票,是指数的一个单位。
公式还有前提:哈希足够均匀,key 之间独立。真实数据不保证独立,订单号有号段、有递增前缀,直接取低位会撞得很惨。
先做一次 64 位混合哈希,再进过滤器,就是把这层相关性洗掉。洗不干净的时候,实测会高于理论。
删一个 key,等于把别人的位一起抹了
普通布隆没有删除接口。硬要删,就是把 k 个位清 0。问题是这 k 个位不只属于你。
十万个 key,删掉五万个,再查这五万个:50000 个全部仍报“在”。一个都没删掉,位被邻居撑着。
计数布隆把每个位换成一个 uint16 计数器。加的时候加一,删的时候减一,减到 0 才算真的空。
同样删五万个,49989 个正确报“不在”,剩下 11 个因为共享位置的计数没归零,仍然残留。
剩余误判 0.0280%。代价是内存:同参数下普通布隆要 958500 位,也就是 120 KB;计数布隆每个位置一个 uint16,958500 × 2 字节 = 1.9 MB,正好十六倍。
还有溢出。uint16 上限 65535,同一个位置被超过六万次插入踩中,计数器就废了:要么饱和,然后永远删不干净;要么回绕,把别人的计数一起带走。热点 key 很容易把某几个位置踩热,URL 去重这种长尾分布尤其明显。生产上要么把这批热位置盯住,要么换 uint32、内存再翻一倍,要么干脆别删,用定期重建代替在线删除。重建常做成双缓冲:新过滤器照常写,旧过滤器只读,等旧的那批 key 过期得差不多,一次性换过去,中间一小段两边都要问。计数布隆不是“普通布隆加个删除”,它换了一套失败模式:普通布隆怕位太满,计数布隆还怕计数器溢出和并发加减。
共享的位,没有单独的引用计数。
不能删不是实现缺陷。位是共享的,共享的东西没有单独的引用计数,就不知道什么时候该释放。
这是拿删除换来的空间效率,不是谁忘了写 Delete 方法。
快百分之十,省五十四倍
同一百万个“不在”的查询:布隆 19.6624 ms,每次 19.7 ns,内存 1.14 MB;map[uint64]struct{} 21.6239 ms,每次 21.6 ns,内存约 61 MB。
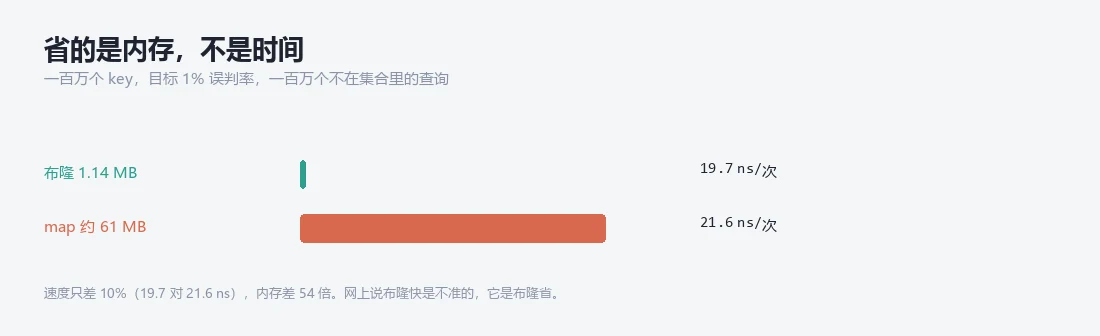
布隆每次查要算七个哈希、摸七个位;map 只算一次哈希、走一个桶。速度只差一成,内存差五十四倍。布隆还快 10%,原因不在哈希,在缓存:1.14 MB 能整块待在 L2 或 L3 里,61 MB 待不下,map 的每次查询都可能往内存跑一趟。这个解释顺手解释另一个现象,key 少的时候两者速度会拉近,因为 map 也塞得进缓存;key 一多,内存差五十四倍,速度差仍只有一成,因为两边都被内存带宽卡住。布隆省,不是布隆快。省下来的内存可以拿去做别的事,这才是它该待的位置。
网上说布隆快,多半是拿它跟“扫一遍 Redis”或者“查一次数据库”比。那是网络往返的胜利。
它赢在每 key 不到两个字节就能记住“在不在”。一亿条 URL,map 要六 GB 上下,布隆一百二十兆。
每多四分之一内存,买到的倍数不一样
从 9.585 位加到 12 位,内存多 25%,误判从 1.01% 掉到 0.32%,降了 3.1 倍。
从 16 位加到 20 位,同样多 25% 内存,误判从 0.045% 掉到 0.006%,降了 7.5 倍。
因为 25% 是比例。基数越大,这 25% 折成的绝对位数越多:前一段加了 2.4 位,后一段加了 4 位。而误判率按位数指数下降,每多一位乘 0.6185。位数越多,同样的比例内存换来的位数越多,买到的倍数就越大。这跟边际收益递减的直觉相反。直觉假设收益按内存线性增长,实际是指数;线性世界里多一倍内存多一倍效果,这里多一倍内存,误判率是平方级地掉。所以别用“加 25% 内存大概降 25% 误判”去估算,会低估得很离谱。
这条曲线对选型有用。在 12 位、误判 0.3% 觉得够用,就别加;在 16 位还嫌 0.045% 高,加到 20 位只要多 25% 内存。
先定误判率,再算位数
布隆适合三种场合:集合很大、查询很多,并且你允许“可能存在”再落到精确结构上确认一次。
数据库前的穿透保护、爬虫的 URL 去重、LSM 树里判断 key 在不在某个文件、CDN 判断资源是否缓存过,共同点是:说“不在”能省一次昂贵的查询,说“在”再查一次也不亏。反过来,集合只有几十万条,map 占几十 MB,你的机器不在乎,那就别上布隆。需要删除、需要遍历、需要精确计数、需要知道具体是哪一条,它一样都给不了。
选型时先定误判率,再算位数,再算 k。1% 要 9.585 位,0.1% 要 14.4 位,0.01% 要 19.2 位。
拿 key 数乘一下,内存就出来了。这个数比任何 benchmark 都好用,因为它不会随机器变。
回到开头那 1%。它不是误差,是报价。你付 1.14 MB,买一个“可能有 1% 假阳性”的答案。
觉得贵,就加内存;觉得假阳性不能忍,就换精确结构。它从来不假装自己精确。