Redis 用跳表,不是为了快

Redis 用跳表,不是为了快
隔壁老康难度 ★★★★☆ · 前置:堆为什么只排一半序就够了 | 一句话结论:查找和范围查询跳表都输给排序数组,Redis 图的是插入不挪内存、实现简单、加锁只碰局部。
跳表在纯查找和纯范围查询上,都输给一个排好序的切片。
Redis 的 zset 底层就是跳表,这套结构被讲过太多遍,讲到后来往往只剩一个“快”字收尾。我原本也这么记着,直到前段时间用 Go 把跳表和排序切片各写了一份,在同一台机器上量同一批操作,机器是 i9-14900HX,go1.27.2 windows/amd64,p 一律取 0.25。
十万个 key 的规模上,插入跳表快 9.82 倍,查找慢 6.07 倍,范围查询慢 14.43 倍。三个数字里,两个是跳表输掉的,而 Redis 用的是那个输两局的。
它图的东西不在表里。
十万个 key 长出十层
跳表就是一层链表压着一层链表。最底下那层装着全部元素,按 key 排好序;往上每一层都是下一层的一个抽样,只留一部分节点。查找从一个很稀疏的高层开始,往右一步能跨过一大片,走不动了就沉到下一层,用更密的链表把剩下的距离走完。这个动作跟翻纸质字典一模一样:先估个大概翻到 F 附近,再往前挪几页找 F 开头的词,翻到那一页才看见具体那个单词。空间换时间的老路子,只不过换出去的空间打了折扣,抽样不复制元素,只多存几个指向同一批节点的指针。十万个 key 不会变成二十万个 key,只是每个 key 头顶上多插几根针。
层数不是建表时定好的。每个节点插入时自己掷一次币,p 的概率继续往上长,1-p 就停住。
p=0.25 的意思是四分之三的节点只有一层,四分之一的节点能再上一层,十六分之一能上两层,再往上以此类推。
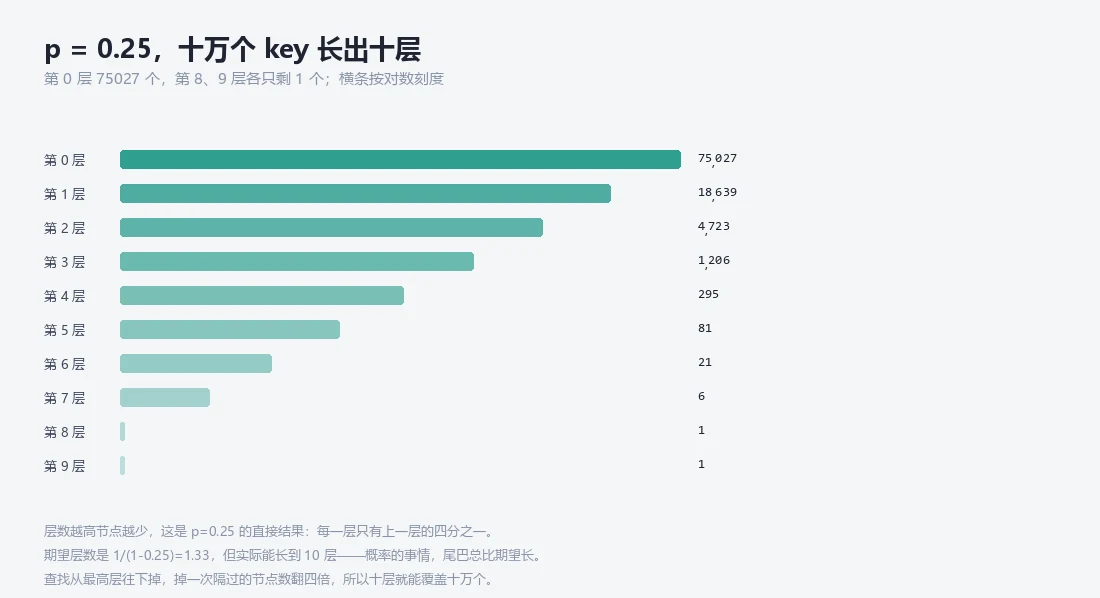
十万个 key 跑下来,最高长到 10 层,光最底下一层就占了七万五。
按每个节点能到的最高层数分桶,从底层往上数:75027、18639、4723、1206、295、81、21、6、1、1。十个数字加起来刚好是 100000,每个节点只被数了一次,分在自己停住的那一层。相邻两桶的比例压在 4 附近,这就是 p=0.25 的形状:往上一层,节点数掉到四分之一。最上面那两层各挂着一个节点,看着寒酸,可它们值这些空间,因为查找是从顶层起步的,一步就跳过七万多个 key。内存的大头压在底下那 75027 个只有单层的节点上,占了全部节点的四分之三,也占掉全部内存的一大半,它们这辈子只贡献一条 next[0]。
把 p 改成 0.50,同样十万个 key 长到 17 层:49963、24845、12518、6353、3253、1546、736、383、208、90、54、27、13、6、3、1、1。比例变成 2,高度几乎翻倍。
看上去 p 越大层越多、查找越快,其实每层能跨的距离同时变小了,横向步数会把它补回来。理论上的查找路径长度是 (1/p)·log n,两个 p 差不了多少,把 p 钉在 0.25 的是内存:每个节点要存 层数+1 个指针,p 翻一倍,指针也翻一倍。
插入、查找、范围
三个操作得拆开看,它们的成本形状完全不同。
1 | func (s *skipList) Insert(key, val int) { |
插入分两步。先从最高层往下,每一层找到新 key 该插在哪两个节点之间,把前驱记下来;再按新节点掷出的层数,从下往上把指针接进去。改动的指针数是层数加一,跟表里躺着十万个元素还是十个元素无关。链表插入本来就长这样,跳表只是把找位置那一步从 O(n) 压到 O(log n)。
查找只有一条规则:右边节点比目标小就往右,否则下沉一层。从最高层走到第 0 层,期望步数是 O(log n)。
范围查询先用查找定位下界,然后顺着第 0 层的 next 一个个往后走,走到上界为止。要两百个就取两百个。
三个操作,三种走路方式。
和排序切片逐项对照
对手是排序切片。同一批 int 塞进一个 []int,sort 一次,查找用 sort.SearchInts 二分,范围查询二分到下界再切一段。它没有任何花招,是这个题最笨也最标准的解法。
| n | 插入 跳表 | 插入 切片 | 倍数 | 查找 跳表 | 查找 切片 | 倍数 | 范围 跳表 | 范围 切片 | 倍数 |
|---|---|---|---|---|---|---|---|---|---|
| 1000 | 77 | 80 | 1.03× | 101.5 | 50.6 | 2.01× | 228 | 65 | 3.54× |
| 10000 | 536 | 537 | 1.00× | 212.5 | 103.1 | 2.06× | 775 | 74 | 10.48× |
| 100000 | 1231 | 12087 | 9.82× | 972.5 | 160.3 | 6.07× | 582 | 40 | 14.43× |
倍数是慢的除以快的:插入那三列是切片除以跳表,查找和范围那六列是跳表除以切片。
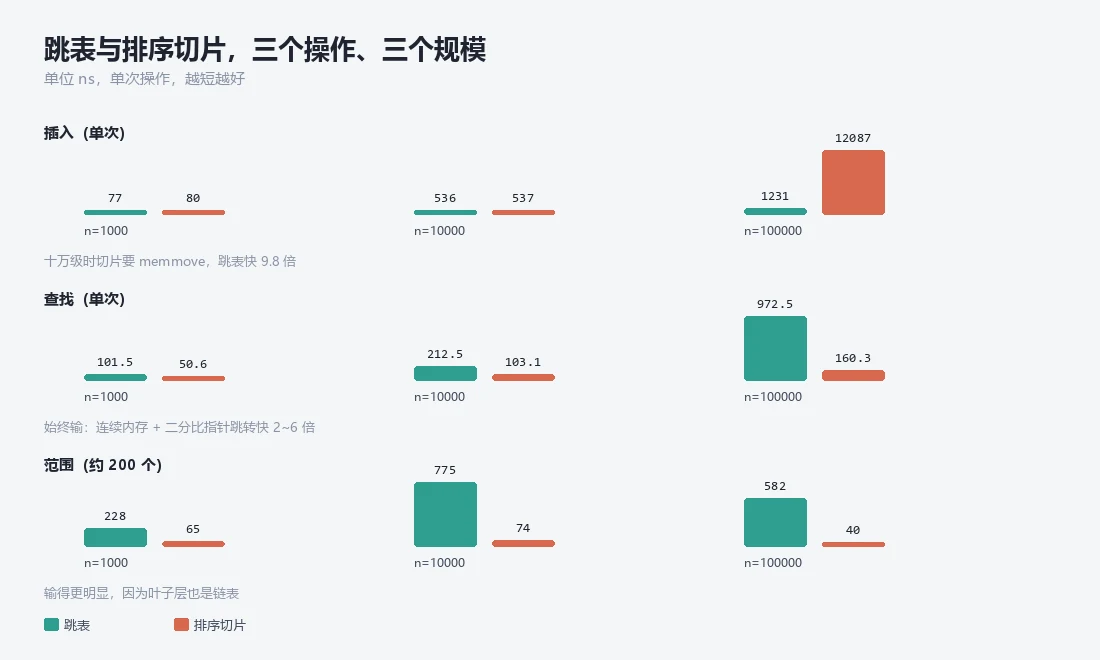
插入这一列最好看,也最容易被误读。n=1000 时跳表 77 ns、切片 80 ns,只快 1.03 倍,四舍五入就是平手;n=10000 时 536 对 537,还是平手。切片插入之所以在小规模跟得上,是因为 memmove 搬的是连续内存,搬几百个 8 字节整数在几十纳秒这个量级上根本不算什么,而跳表插入要掷层级、要走十几次指针、要在堆上分配一个新节点,这些固定开销把省下的搬运吃光了。数据量涨十倍,切片的搬运成本涨十倍,跳表的 log n 只多走了几层。到 n=100000,切片 12087 ns,跳表 1231 ns,才拉开 9.82 倍。所以“跳表插入快”这句话得加定语:大规模、插在中间的时候才快。
查找和范围这两列反过来,跳表从头到尾都在输,规模越大输得越多。n=1000 时查找慢 2.01 倍,n=100000 时慢 6.07 倍;范围查询更难看,三个规模分别是 3.54 倍、10.48 倍、14.43 倍。原因不复杂:二分查找每次跳到数组里一个位置,一次读进来的一整条缓存行装得下十几个 int,下一次比较大概率还在同一条线上。跳表每下沉一层、每往右走一步,都是解引用一个堆上的指针,那个节点上次被访问可能已经是几万次操作之前,缓存里早没了。CPU 等一次内存的时间,够它做几十次加法。范围查询输得最狠,因为它的主循环是顺着第 0 层的 next 一路走,两百个节点散落在堆的各个角落,等于把随机访问做了两百遍。
输在内存,不在算法。
42 字节和 5 字节
十万个 key 按结构算下来,跳表占 4267784 字节,折成每个 key 42 字节。排序切片那边,key 去重之后剩 63140 个 int,505120 字节,按原始十万个 key 摊是每个 key 5 字节。
两边的账差了 8.5 倍,这不是四舍五入的误差。
差额全在指针上。一个只到第 0 层的节点,至少要有 key、value、next[0] 三段;每多一层多一个 8 字节指针;再加堆分配器给每个小对象套的头。层数还是个变量,next 得做成切片,切片头本身又是 24 字节,跟元素一起分配在堆上。排序切片那边的账简单得过分:一个 int 8 字节,去重后多少个数就是多少,没有别的开销,连扩容都只在 append 那一刻发生一次,之后就是一段连续的内存被二分反复切片。
这 8.5 倍不只体现在内存条上。节点散在堆里,GC 要一个一个扫,缓存要一条一条换。
省下来的字节,也省下了顺序。
Redis 图的是另外三件事
到这儿该问一句:既然查找和范围都输,zset 底下凭什么放跳表。
第一条,插入不用 memmove。zset 的写入路径上,新元素插到中间是常态,排名、分数、范围全靠元素有序。底层如果是有序数组,每次插入都要把后面几十万个元素挪一格,O(n),而且这一步发生在 Redis 那个唯一的命令线程上,挪内存的这段时间所有客户端的命令都在排队,网卡那边收进来的请求只能干等。跳表插入改几个指针,十万级时快 9.82 倍。这个倍数是平均值,我量不了 p99——半毫秒一格的表测不出单次延时的分布。但这个均值差的方向和来源是清楚的:数组每次插入都要把后面几十万个元素整体挪一格,挪的量跟着元素个数线性长;跳表改的指针条数只跟层数有关,跟集合多大无关。所以元素越多,这个倍数只会变大,不会变小。
第二条,实现比红黑树简单得多。红黑树插入要处理五种情形,删除要处理四种,每种都带一串旋转和重新染色,写完了还得证明它没违反那五条性质,改一行代码心里都没底。跳表插入是找到每层前驱、接上指针;删除把前驱的 next 指向后继、把节点还回去。两种操作都能在白板上画清楚,写错了跑一遍测试就能看出来。范围查询在红黑树上更别扭,得中序遍历摸到起点,再沿着线索往后走,中间还要处理回溯,代码量翻一倍不止。
在能跑的前提下,好调试是硬指标。跳表出问题时,从顶层把每层的链表打一遍就能看清形状;红黑树出问题时,得先把那些旋转在纸上推一遍。zset 的实现者解释这个选择时,把好实现、好调试排在很前面,理由里没有“更快”。
第三条,并发加锁只影响局部。这条在 Redis 的单线程模型里不显眼,换成要放锁的存储就是决定性的:跳表插入只需要锁住几个前驱,范围查询锁一段连续的链表;红黑树旋转一次,父子关系动的是整棵子树,锁切不细。Java 的 ConcurrentSkipListMap 读操作完全不加锁,写操作只对局部做 CAS,靠的就是写路径是局部的。这三条里,没有一条叫更快,也没有一条跟查找和范围有关。
两次量错的数字
第一版我用 time.Now 把每一次操作夹在中间,跑完发现 n=1000 那一行的三列全是 0 ns,倍数算出来是 NaN。代码没错,是尺子没有刻度:这台机器上 time.Now 的步进大约 0.5 ms。Go 在 Windows 上取当前时间,读的是 KUSER_SHARED_DATA 里那个由系统时钟中断更新的字段,中断一次它才动一次,中间来问一万遍都是同一个数。一次跳表插入几十到几百纳秒,两次采样的差值落在毫秒量级,除掉之后不是 0 就是一堆噪声,倍数自然成了 NaN。我当时盯着那三列 0 看了很久,第一反应是自己把循环写空了,加了打印才确认循环真在跑,只是表盘一格都没动。我以为在测一次插入,其实在测表盘的最小刻度。
微秒以下的事,这块表盘一概看不见,它只会回你一个 0。
第二版改成把同一个操作重复 200 轮,量总时长再除以 200,想着这样总该够了。n=100000 的切片插入跑了两分多钟没完,进程被我 kill 掉。回过神来才明白,那 200 轮不是 200 次常数操作,每一次都要 memmove 十万个元素,200 轮叠起来是两千万次元素的搬运。我以为在测单次插入的成本,其实在测一个 O(n²) 的循环。
第三版干脆交给 testing.Benchmark,让库自己定 N,我才不用猜。
1 | r := testing.Benchmark(func(b *testing.B) { |
中间还撞了一个编译错误:r.Nanoseconds undefined。testing.BenchmarkResult 里没有这个方法,时间藏在 r.T 里。我以为 r 就是那个 Duration,其实 r.T 才是。
数字稳下来之后,还得确认两边在算同一件事。9506 个 key 灌进两份实现,存在的漏报 0,不存在的误报 0;四组范围查询的命中数是 9506、85、2、0,和排序切片逐组对上。对不上,倍数就不用看了。
写多读少,还要范围扫描
写多读少、要范围扫描、还要并发写的场景,跳表是最省心的选择。zset、LevelDB 的 memtable、ConcurrentSkipListMap,都是这个形状。
读多写少、数据基本不动、内存又紧的场景,排序数组加二分更合适。它查找快 6 倍,还省 8.5 倍内存,代码三十行。索引文件、字典表、配置快照这类东西,装进切片排一次序就够了。
只在末尾追加的场景,比如按时间来的日志和指标,切片追加是摊还 O(1),跳表没有优势,二分还更快。这种数据连排序都不用,天生有序。
以单点查询为主、范围查询很少的,用哈希表。这个位置上它是另一个量级,跳表的 972 ns 在哈希面前没法看。
跳表的位置在中间。它不赢任何一项,赢的是同时能扛住这三件事:随机位置的写、范围扫描、并发的局部修改。所以它赢的不是单科。