一个 goroutine 只要 604 字节,但这不等于免费
一个 goroutine 只要 604 字节,但这不等于免费
隔壁老康难度 ★★★★☆ · 前置:type switch 的 case 顺序决定走哪条路 | 一句话结论:一个 goroutine 在堆上摊到 604 字节,但它还有一块 2KB 起步、扩容要整块复制的栈,以及调度器里的一份结构体,三笔账要分开算。
2023 年 6 月我刚入行那阵,在一场模拟面试里被问过一个 goroutine 占多少内存,我答得很干脆,两 KB,因为启动的时候会预分配一小块栈。这个答案当时够用,面试官没有追问,我也就把它当成结论收了起来,我记得当时还觉得自己答得挺稳,因为两 KB 这个数在当时的讨论里出现频率最高,谁说出来都像常识,后来写代码偶尔想起它,心里大致有个数,觉得随手开几千个不会出事。开始怀疑是在一个批量任务里,我把循环里的 goroutine 数量从几百提到十几万,程序没有崩,内存却涨得比我预期快得多,那一刻我才发现自己手上其实没有数,只有一句从别处听来的话,而这句话既没说清它量的是哪一部分,也没说清它在什么条件下成立,等于什么都没说。我手上没有数。那之后我补过很多次课,但补的方式不太对。我在各种文章里找答案,数字互相打架,有的说两 KB,有的说四 KB,有的说只要一两百字节,其实它们都没错,只是量的不是同一样东西,有人量的是栈,有人量的是结构体,有人量的是堆上摊下来的那一份。
它们在量不同的东西。
这次重做实验,环境先写清楚。
机器是 i9-14900HX,GOMAXPROCS 设成 32,工具链是 go1.27.2 windows/amd64。
启动这二十万个花了 509 毫秒
每个 goroutine 只做一件事,睡一秒然后退出,一共起二十万个,只量启动这一段。量法很直接,起之前取一次时间,循环结束再取一次,两个时间戳相减。启动这二十万个一共花了 509.203ms,这个数字只覆盖循环把它们建起来并交出去的那一段,不包括它们各自睡的那一秒,也不包括最后的退出。之所以只量这一段,是因为那一秒是业务逻辑,和 goroutine 本身的成本无关,把它算进去,量到的是程序的意图,不是运行时的开销。把 509 毫秒摊到二十万次启动上,每一次不到三微秒,这个均摊值看着漂亮,背后却是从创建结构体、分配栈、挂进本地队列到唤醒工作线程的一整串动作,任何一环都不是零,而且每一环的开销都随机器和调度器当时的状态浮动,换一台机器再量一遍,数字不会一模一样。所以我在这篇里不打算把它当成一个可以搬着走的常数,只当成这台机器在这个时刻的一个读数。半秒其实不算长。这之前还有一轮同样的实验,量到的是 530.97ms 和 602 字节,时间上差了几个百分点,字节数上只差两个。
两次这么接近,说明这套量法本身是稳的,不是某一次运气好。
所以后面谈数的时候,我用的都是这一轮的值,把上一轮留在旁边做对照。
1 | start := time.Now() |
1 | startup 509.203ms previous 530.97ms |
604 字节是堆上的净增量
内存这一头用的是 runtime.ReadMemStats。先主动跑一次 GC 把垃圾清干净,读一次 HeapAlloc 当基线,等二十万个都建起来之后再 GC 一次,再读一次,两个数相减,就是这一段分配留在堆上的净增量。结果是 120914472 字节,除以二十万,平均到每个 goroutine 是 604 字节。这个数我没有取整到 KB,因为我想知道摊到单个对象上到底是多少,而 604 这个量级恰好说明一件事,goroutine 在堆上占的那点东西,比很多人以为的一两百字节要多,比另一些人以为的几 KB 要少,它落在一个很具体的位置上,既不是可以忽略的零头,也不是能吓退人的大头。
另外 604 这个数里不含分配器自己的元数据(比如 span 和 bitmap 这些为管内存而生的结构),它们确实占着常驻内存,只是 ReadMemStats 的 HeapAlloc 不把这一部分算进这一次的增量里,所以真要估一台机器的常驻占用,604 偏乐观。这种不上不下的数值最容易被记错,因为它在两个常见答案的中间,谁引用的时候都容易顺手往自己习惯的那一头靠,两 KB 和六百字节就这么各自流传开了,而中间那段准确的位置反而没人提。
平均数会骗人。
翻回去对上一轮那个数,才发现两处不是一回事。
上一轮量到的是 602,和 604 只差两个字节,这种级别的一致让我愿意把这个数当成准的(至少在同一台机器、同一套工具链上是准的),换一套环境不一定还是这个值,但量级不会跑掉。
604 是把一个总数摊到二十万份上得到的结果,不是每一个 goroutine 都恰好占这么多。
堆上的分配有规格,大小并不整齐,摊出来的只是一个均值,拿它做数量级判断可以,拿它当精确的单个开销就要小心。
结构体那几百字节不在这个数里
先说清楚这个数没算进什么。运行时里表示 goroutine 的那个结构体,内部叫 g,里面装着栈的上下界、当前的调度状态、等待队列、绑定的线程这类信息,它本身就占几百字节。真实的占用是三笔:
| 这一笔 | 量级 | 算在 604 里吗 |
|---|---|---|
| 堆上摊下来的 | 604 字节 | 算,这就是它 |
| 栈 | 2KB 起步,按需长 | 不算 |
g 结构体加调度器里的位置 |
几百字节 | 不算 |
三笔加起来才是要付的钱。三笔加起来才是要付的钱,只报其中一笔,账就是假的,而我在论坛里看到的争论,绝大部分吵的正是这个,两个人报的数不一样,其实是在算不同的东西,谁也没有说谎。
这也是我一开始总是对不上的原因,我记住的那个两 KB 只是其中一笔,而别人嘴里的几百字节是另一笔,两边都只说了自己那半句,剩下的部分要自己去补。所以千万别拿 604 去乘一百万,再把这个乘积当成内存上限。那个算法漏掉了栈,而栈才是真正会随用量浮动的那一笔,调用深一点它就要申请更大的空间,单个 goroutine 的占用可以比 604 大出好几倍。乘法算不出答案。
栈是按需长出来的
栈的起点是 2KB,这个数写死在源码里,stackMin = 2048,位置在 D:\Go\src\runtime\stack.go 第 78 行,不是随手定的。程序起一个 goroutine 的时候并不给它一大块,先给这么一小段,够用就用着,不够用再长。栈是长出来的。这个策略的意义在于数量。如果每个 goroutine 一开始就带着几百 KB 的栈,二十万这个数量级的实验根本跑不起来,而实际上大部分 goroutine 一生只用到那 2KB 里的一小部分,实际把栈撑满的是少数,把它们拉到同一个尺寸去预算,等于替那少数付钱。
它长到多大,取决于这个 goroutine 里最深的那一层调用。浅的函数用不上扩容,深的递归会把栈一层层顶上去,所以谈栈的均值不能只看起点,要看代码底下在干什么。
栈扩容只能整块搬走
栈不够用的时候,运行时不能原地把它接长。栈在内存里必须是连续的一段,而它后面那块地通常已经被别的对象占了,没人能承诺一段更大的连续空间还从同一个地址开始,所以唯一的办法是申请一块更大的新栈,把旧栈上还在用的那些东西整块搬过去,再把所有指向旧栈的指针改成新地址。
一次扩容的代价就是一次内存复制加一次指针修正,复制量是旧栈的全部内容,不是多出来的那一点,栈越大,下一次扩容搬得越狠,这跟切片的 append 在性质上是一回事,都是拿一块新的地换掉旧的地,区别在于栈的搬迁还要改写指针。所以深递归在 Go 里要多留一份心。
指针修正这一步最容易被低估,因为它要把栈里每个可能是指针的位置都重新扫一遍,判断哪些该改、改成什么,这个扫描的成本跟着栈的大小走,和复制是同一个量级。
这段后来还是重写了,因为没说到点上。
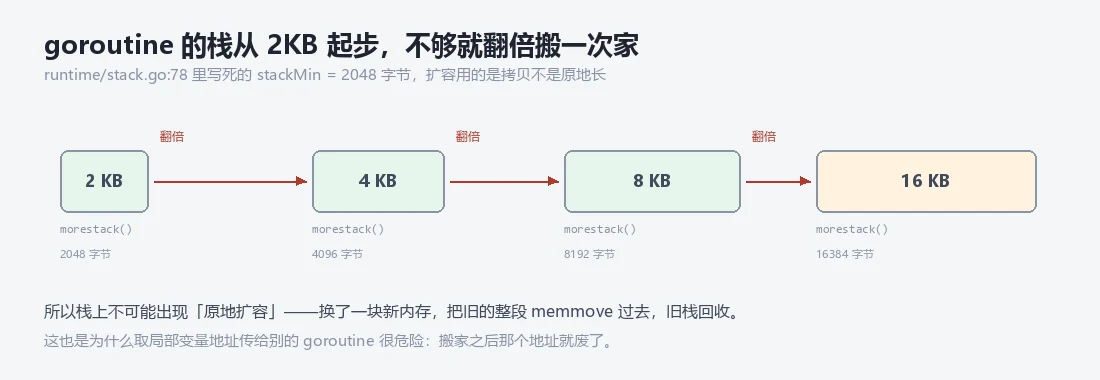
每一层调用都要占栈,栈不够就复制一次,复制的量随着栈变大而变大,一次深调用可能触发好几次扩容,每次都在搬整块内存。
把这件事和前面的 604 放在一起看,两笔账的性质完全不同。
604 是一创建就付的,数额固定,可以按数量线性估算,二十万就是二十万份。栈的开销是随着调用深度长出来的,同一个数量级下,写浅的代码和写深的代码,占用可能差出好几倍,而你从 goroutine 的数量上完全看不出来。
复制比增长更贵。搬走的时候那些指向栈的指针怎么办?
调度器的账记在唤醒上
启动这二十万个的时候,机器上能同时干活的线程只有 32 个,因为 GOMAXPROCS 是 32,二十万个 goroutine 排在这 32 个逻辑处理器上等,谁被叫到谁就跑。每次 go 语句都要新建一个 g,把它挂到当前处理器的本地队列上,本地队列满了还要挪一半去全局队列,同时判断要不要唤醒或者新建一个工作线程。这套动作摊到单个上很便宜,乘上二十万次,就是那 509 毫秒要付的东西,而更贵的一段在后面,它们睡满一秒之后几乎同时醒来,二十万个一起变成可运行状态,32 个线程要去消化这堆活,队列的争抢和线程之间的唤醒会集中爆发,这一段我没有量,但它是数量开始咬人的地方。原因也不难想,睡的时候它们排得整整齐齐,醒的时候却全挤在同一瞬间,本地队列装不下就往别处挪,挪一次就要抢一次锁,越挤越慢。唤醒不是免费的。
所谓的 Ping-Pong,就是一个 goroutine 唤醒另一个然后自己睡下,两个之间来回切换。
单次切换本身很便宜,次数一多,CPU 的时间就被这些切换吃掉,业务代码反而没跑多少。
(这个词我一开始写成 PingPong,翻了下 runtime 的注释才发现中间那个连字符是有人较真的。)
一百万也能起,只是会变慢
把数量加到一百万,程序通常不会崩,Go 的运行时不会因为你开得多就拒绝,但会看到另一种现象,进程还在跑,CPU 也满着,吞吐却不涨。原因不神秘,唤醒和调度本身就是工作量,goroutine 越多,花在找下一个该跑谁、把谁挂起、把谁叫醒上的时间就越多,实际干活的比例被稀释。
这就是数量带来的那一层成本,它不出现在内存曲线里,出现在 CPU 的时间分配里,所以你盯着内存看,永远看不出它已经到顶了,反而会觉得内存还有富余,可以再往上堆。先顶住的是别的东西,是 32 个线程可以分到的时间片,是队列上那把锁被抢的次数,是唤醒一个线程到它真正跑起来之间的那段延迟,这些都不在内存里,你在内存上看不出任何信号,只能看吞吐开始不动了。便宜不等于免费。所以数量不是目标,它只是手段。一个 goroutine 阻塞在 channel 上等结果,和一个阻塞在系统调用上,代价不一样,前者只是调度器里的一次状态切换,后者可能还占着一个线程。
把它们混在一起谈数量,谈不出结论。
泄漏的 goroutine 钉住它引用的一切
泄漏是另一种形态的成本。一个永远不会返回的 goroutine(比如卡在一个再也没人写的 channel 上),它会一直占着自己的栈和结构体,这还只是小头。更麻烦的是它引用的所有对象,那些对象从根上可达,每次 GC 都扫到它们,判定为活着,一个字节都收不走。
我遇到过一次更隐蔽的,一个 goroutine 卡在 select 上,一边等数据一边等超时,超时那一支写的是 time.After,而每一轮循环都会新造一个定时器。循环不退出,定时器就一直挂在运行时的定时堆上,每个都带着自己的回调和一个指针,内存涨得比那条 goroutine 本身快得多。
回到最初那个 604 字节。
后来是把定时器提到循环外面才止住的,涨势当时就停了。
定时器提到循环外面,就这一条。
跑得越久(这种残留越多),内存曲线是一条只涨不落的斜线,而且这类 goroutine 在 pprof 里安安静静,不报错,也不 panic,你只能靠数量对不上来发现它。所谓数量对不上,是把线上看到的 goroutine 数和业务逻辑应该有的数量比一下,差出来的那部分如果只增不减,基本就是它了。
泄漏比慢更麻烦。我现在的做法很朴素。起 goroutine 的地方必须有一个明确的退出路径,要么跟着 context 走,要么有一个一定会被关闭的 channel。写完顺手看一眼这个 goroutine 靠什么结束,答不上来就先别写。
先想清楚它怎么结束。批量任务里最容易漏,一个 for 循环里起出去的 goroutine,只要其中有几个卡住,后面每一轮都会再多几个,问题不是一次爆发的,是慢慢堆出来的,等你发现内存不对,已经翻了几十轮。
堆上摊下来 604 字节,一块 2KB 起步、扩容要整块复制的栈,一份几百字节的结构体,外加调度器里为它保留的位置。这几笔要分开算,合起来才是一次创建的真实成本,而这个数比一句很便宜有用得多,因为它能拿去和你的并发数量相乘,也能在你怀疑内存涨得不正常的时候,给出一个可以对照的起点,而不是让你对着一句从别处听来的话反复猜。
我现在评估一个方案,会先问一句它同时挂着多少个 goroutine,峰值是多少,然后再看每个要付几笔账,这两句话凑起来,比任何一句笼统的结论都可靠。