磁盘上不能用二叉树
磁盘上不能用二叉树
隔壁老康难度 ★★★★☆ · 前置:平衡树在平衡什么 | 一句话结论:B 树不是更宽的二叉树,是把一次寻道当最小单位设计出来的结构。
第一版 B 树的测量表,我贴进了组里的群,一百万个 key,t=128 是三层,旁边一列是同样一百万个 key 的二叉树,十九层。贴完顺手又把 t=250 和 t=500 两行塞了进去,当极端值参照,觉得自己总算把课本上那件事亲手量了一遍,连表头都对齐了。
老周十分钟后回我,那两行,一页装得下吗。
我盯着屏幕看了一会儿,没回。7992 和 15992,这两个数是我自己算出来贴在表里的,当时眼睛只落在树高那一列,没往右边看一眼页大小。
他问的本来不是这个。
他想知道索引为什么不直接学红黑树,查找都是 log n,凭什么换成 B 树。我答得很顺,层数少,十九层和三层差十六次寻道,每次寻道都要等磁头到位、等盘片转对位置。可这个回答只说了 B 树赢在哪,没说明白它为什么非得长成那样,为什么要把几十个几百个 key 塞进同一个节点,为什么扇出大是设计目的而不是顺手写下来的结果。我那天晚上其实还改了一版措辞,把每次寻道相当于跳到磁盘另一头这句加进去,越写越顺,顺到我自己都没再回去问一句,十九层这个数是从哪儿来的,它和节点里装几个 key 有什么必然关系。第二天早上洗漱的时候我自己冒出一句,既然差在层数,那把二叉树加宽不就结了。
加宽到一页装不下为止,它就叫 B 树了。
要看清这件事,得从一页能装几个孩子算起。
一页 4096 先算装几个孩子
一页 4096 字节,这个数是文件系统给我的最小搬运单位,不是我挑的,我能挑的只有往这一页里塞什么。内部节点里一个孩子配一个 key,孩子数比 key 数多一个,估算时按一对一算就够。key 是 int64,占 8 字节。孩子指针在 64 位机上也是 8 字节,一对 16 字节,4096 除下来是 256 个孩子,也就是 255 个 key。这个除法我是在纸上算的,算完才反应过来,整张表里最该先开口问的人是我,一页到底多大,我居然到最后一步才想起来确认,前面几百行代码都是照着先验印象在写。
1 | const pageSize = 4096 |
key 一变宽,孩子数就掉。
| key 字节 | 一对 key 加指针 | 扇出 | 一百万个 key 的层数 |
|---|---|---|---|
| 8 | 16 | 256 | 3 |
| 16 | 24 | 170 | 3 |
| 32 | 40 | 102 | 3 |
256 的三次方是一千六百七十七万,一百万个 key 连零头都用不满。平方只有六万五,装不下,所以根一层、中间一层、叶子一层,三层刚好。表里唯一让我停了一下的是 102 那一行,102 的三次方一百零六万,刚过一百万,多出百分之六,key 再宽四字节,这一列就翻成四层。百分之六的余量意味着这一行站得最不稳,它离掉出去只差一点点,我盯着那个百分比看了半天,才明白表里三行都写三层,余量却完全不是一回事。
三层不是运气,是除出来的:宽是余量,高才是代价。
扇出和树高是同一个数
每加一层,能装下的 key 就乘一次扇出。反过来,给了一定数量的 key,层数就是拿扇出反复除,除到小于一为止。扇出和树高不是两个能随便调的变量,它们是一个。我又把阶当自变量跑了一轮,一百万个 key,节点一律按 2t-1 个 key、2t 个孩子建。
| t | 每节点 key 数 | 孩子数 | 树高 |
|---|---|---|---|
| 8 | 15 | 16 | 6 |
| 25 | 49 | 50 | 4 |
| 50 | 99 | 100 | 4 |
| 100 | 199 | 200 | 3 |
| 128 | 255 | 256 | 3 |
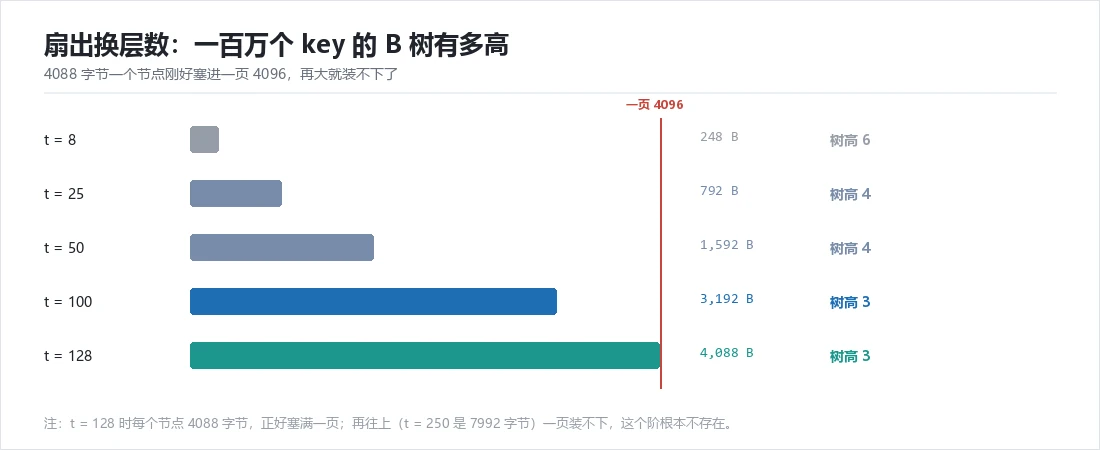
t 从 8 到 128,树高从六层掉到三层。
中间两行有点闷。t=25 和 t=50 的孩子数差一倍,树高都是四层。t=50 到 t=100 又是一倍,这一跳才掉一层。原因在除法的整数部分,五十的四次方六百二十五万,够;三次方十二万五千,不够。扇出涨一倍,只要没顶穿上一个台阶的边界,层数一动不动,节点占的字节却实实在在涨了,寻道次数一次没少,等于花钱买了宽度没买到高度。我原来以为扇出越大树越矮,是条连续的曲线,量完才看清它是台阶,跨不过去的时候,把阶调大一倍也只是让节点多用一点页。
树高是阶梯,不是斜坡。
阶是被页大小逼出来的
写第二版之前我先算了一笔账,一个节点占多少字节。t 阶节点最多 2t-1 个 key、2t 个孩子指针,都按 8 字节算,加起来是 (2t-1)×8 + 2t×8,展开成 32t-8。t=128 是 4088 字节,一页 4096,还剩 24,t=129 是 4120,超了。所以 128 不是我挑的数,是页大小除出来的,换成 16KB 的页,同一个除法会把我推到 512 去。
1 | type bnode struct { |
第一版那两行是这么来的。我想看极端值能不能把曲线拉开,就先定了阶,定在 250 和 500,回头再拿页去凑,一个节点 7992 字节,一个 15992 字节,要连读两页四页才装得下。数字本身没算错,错在这两个节点从来没有存在过,读它得连读四页,那两行的树高好看得毫无意义。这个错是我贴出去让人挑出来的。这和先定结论再找数据是同一类错,约束条件排在了参数前面。页大小是约束,阶是被它算出来的参数。
先把页钉死,阶才有意义。
从中间断开,树才长高
插入总是落在叶子上。叶子塞不下了,就把中间那个 key 顶上去交给父节点,两边各自成节点。父节点可能也满了,同样的动作往上再来一次,一路顶到根,根裂开,树高加一。
1 | if len(n.keys) == 2*b.t-1 { |
这是 B 树唯一长高的方式,高度只在一个地方变,根。所有叶子永远停在同一层,所以顺序插入一百万个 key 是三层,随机插入一百万个还是三层。两种插入的分裂路径完全不一样,落点却一样,因为根以下的分裂只把 key 摊开,不会把树拉长,拉长的动作被锁死在根上,谁也没法在中间偷偷长出一截来。想让它平衡,就别给局部长大的权限,这句我后来在别的地方也用得上,比如内存池的分段,比如任务的并发度,凡是能自己去长的东西,最后都会长歪。
二叉树做不到。
它没有分裂这个动作,长高靠一根一根往下接节点,插进去的顺序直接决定最后长成什么样。同样一百万个递增的 key,它能长成一条链,十万层、百万层都有可能;随机插入时高度才收敛到二十层上下。红黑树把这件事按住了,代价是每次插入删除都要旋转,旋转是常数次操作,可它数的还是节点个数,不是页数。一百万个节点就是一百万个要跳过去的位置,平不平衡都没把这个数降下来。
删除得往回讨一个 key
t 阶节点除了上限 2t-1,还有下限 t-1。删掉一个 key 之后节点掉到下限以下就得处理,否则一页里剩下的 key 越来越少,扇出这个数就名存实亡:页还是那一页,装的 key 只剩几个,树没塌,有效宽度塌了。兄弟有富余就借一个,中间那个分隔 key 从父节点转一圈下去;兄弟也卡在下限,两个并成一个,父节点少一个 key、少一个孩子,于是父节点也可能掉到下限以下,同样的动作再往上走一遍。这条链一路往上走,走过的每一步都得把父节点里那个分隔 key 改对,那是整段代码里最容易漏的一笔,因为它在两个节点之间,写起来不显眼,错了也不立刻报错。
全部并完,根空了,整棵树矮一层。
删和插对着来,高度还是只在根那里变。删除比插入难写,难在触发条件,插入只看当前节点满没满,一个分支。删除要看兄弟还有没有富余,三种情况,每种都得顺手改父节点的分隔 key,改漏一个,那个 key 就再也找不见。我第一版漏了旋转那一步,随机删除跑完对不上,排查到后半夜才发现是父节点那个分隔 key 没跟着改。
三趟寻道,一万二千字节
树高说的是趟数,还得看每趟搬多少。节点字节按 32t-8 算,乘上层数,就是一次查找碰过的字节总量。
| t | 单节点字节 | 层数 | 查找累计字节 | 折合页数 |
|---|---|---|---|---|
| 8 | 248 | 6 | 1488 | 0.4 |
| 25 | 792 | 4 | 3168 | 0.8 |
| 50 | 1592 | 4 | 6368 | 1.6 |
| 100 | 3192 | 3 | 9576 | 2.3 |
| 128 | 4088 | 3 | 12264 | 3.0 |
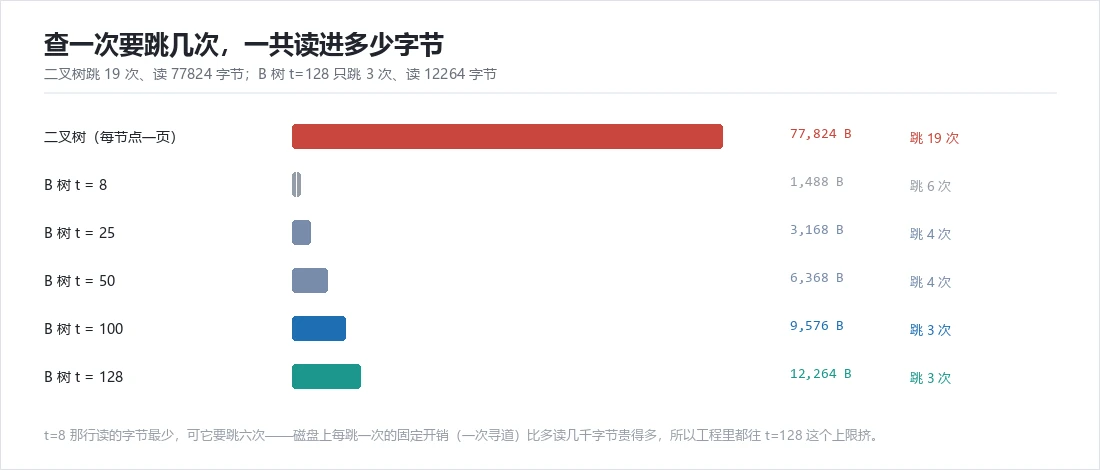
t=8 那一行最有意思,六层,每层只有 248 字节,加起来 1488,是整张表里最小的字节数。t=128 那行一万二千二百六十四字节,按字节算是它的八倍多。按字节算小阶赢,按趟数算大阶三趟、小阶六趟。
磁盘的计价单位是趟。
两个指标给出相反的结论,这时候得停下来问一句,哪个才是真付出去的代价。一页 4096 是最小读单位,248 字节的节点读进来,另外 3848 字节白搬,代价却固定:读一页和读 248 字节花的是同一次往返,都要等磁头到位、等盘片转对位置。多出来的那三次往返才是真金白银。字节数在内存里是个诚实的指标,换到磁盘上就骗人,因为分母换了,内存按字节收费,磁盘按页收费、按次数计时。
字节数在这里骗人。
二叉树那十九页只用了 24 字节
二叉树一个节点一个 key、两个孩子指针,24 字节,我按每个节点独占一页来建。一百万个 key,树高 19,十九层就是十九次读页,十九乘 4096 是 77824 字节。B 树 t=128 三页,12264 字节,字节比 6.3 倍。
那十九页里每一页只用了 24 字节,利用率百分之零点六,剩下 4072 字节全程陪跑,还得跟着一页一页搬进来。磁盘不会因为你只用 24 字节就少搬 4072 字节,它按页收费(这一页读进来之后留在哪、下一次读同一页还要不要等磁头,是页缓存的事,Linux 那条线里单独讲过)。错不在比较次数,在它一个节点占一页:同样一百万个 key,B 树把 255 个 key 挤进一页,二叉树一页只放一个,九成九的空间空着,寻道次数就这么变成了十九次,是 B 树那三页的六倍多。6.3 倍看着像个结论,其实只是副产品,真正被浪费掉的是那十九页里每一页的 4072 字节,它们没参与比较,也没参与判断,纯粹是陪着磁头走了一趟。
所以加宽这个念头,走两步就撞上 B 树。
加宽就是把更多 key 塞进一个节点,塞到一页装不下为止。塞满的那一刻它已经是 B 树了,还得补上分裂,不然一页迟早爆,这两种状态中间没有第三种形态。
一页多大,比树有多高重要
那张表我后来重发了一次,t=250 和 t=500 删掉,三层这个结论一个字没改,改的是我拿到一个新结构时的第一反应。现在我先问设备三件事,一页多大,寻道一次值多少,读一页是不是也按页收费。这三个数定下来,扇出就有上限,层数是除出来的结果,最后才轮到选 t、写分裂、调删除的下限。
参数是从约束里长出来的。
反过来做,量得再准也是白量。2023 年 6 月我刚入职那会儿,看索引只会背定义,知道 B 树矮、红黑树高,说不出矮在哪一步省了钱,也说不出那张表里的数是从哪个约束里长出来的。现在看一个存储结构,我先找它的最小代价单位。B 树让我服气的地方不在平衡,在它把一次寻道当成设计的最小单位:一页装一个节点,一次读一页,一层摊一次寻道,宽度、分裂、半满的下限,全是从这一条推下去的,没有一处拍脑袋。
老周那句话我记到现在。一页装得下吗——他问的时候手里连纸都没有,就站在我工位旁边,等我念完 t=500 才补了半句,说那两页你装给我看看。我当场没答上来,回去改了一晚上表。