链表和哈希表拼起来,就是 LRU

链表和哈希表拼起来,就是 LRU
隔壁老康难度 ★★★★☆ · 前置:数组到底快在哪 | 一句话结论:命中率由访问分布决定,哈希表加双向链表只负责把定位和排序压成 O(1),代价是每次命中写六个指针。
一个容量一千的缓存,一百万个请求打进去,命中率可以是 86%,也可以是 0。两组实现差不到三十行,请求序列换一种形状,数字就翻了面。我把四组数并排贴在一张表上,看了很久:同一台机器、同一版 Go、同一个容量,能决定结果的只有请求是怎么来的。写缓存最容易搞反的地方就在这儿,力气全花在挑结构、调哈希函数、算负载因子上,拍板的是上游那条流量曲线,而它不在你的代码里。机器是 i9-14900HX,go1.27.2 windows/amd64,GOMAXPROCS=32;一百万个请求,容量一千,读不到就回源,回源的结果写回缓存。
先写最像样的那个错法。
第一版是一条切片,0 号放最旧的,末尾放最新的。命中就抽出来塞到末尾,塞不下先砍 0 号。
1 | type item struct { |
这段代码挑不出错。最久没被用过那条规则,它维护得很老实:Get 挪到末尾,Put 满了砍 0 号,重复的 key 就地更新,一个分支都不少。拿它跑 zipf 1.2 的一百万次请求,命中 861640 次,跟后面那版标准实现一模一样,连一次都差不出来。
问题全在代价上。
| 实现 | 耗时 | 每次 | 命中 |
|---|---|---|---|
| 哈希表 + 侵入式双向链表 | 18.748 ms | 19 ns | 861640 |
| 切片 + 线性找 | 239.1913 ms | 239 ns | 861640 |
命中一次,平均要扫半条切片:一千个元素线性找,五百次比较;找到之后还要 copy 一次,把后半段整体往前挪一格。一千个元素、每个 16 字节,一条切片 16 KB,每次命中都在碰这一整段内存。容量小的时候它完全能跑,一千、两千、五千,肉眼看不出来,一次操作也就几百纳秒,业务里那点 QPS 摊不平它;等到每秒几十万次,或者容量上万,这条切片才真的开始疼,而 pprof 只会把时间记在 get 那一行上,不会告诉你是因为你拿一条切片当了索引。这类写法我在别人的项目里见过好几次,第一版就能跑通、能过测试、能上线,所以它活得比很多正确但复杂的实现都久。
命中数一个不差。
哈希表知道 key 在哪,不知道谁该走
map[uint64]int 快,问题是它不存顺序。它能告诉你这个 key 在不在、值是多少,一秒查一千万次都行,但它不记录谁先来谁后到。要淘汰,你得回答最久没被访问的是哪个,map 里翻不出这个答案。能想到的补救是给每个 value 挂一个时间戳,淘汰时扫一遍找最小的:一次淘汰 O(n),比切片版还差,因为连顺序都要现算,每读一次又都得写一次时间戳,本来只读的操作被拖成了写。container/heap 也救不了,堆里按时间排序,可节点被访问之后要改位置,你得先知道它在堆里第几个,那又是一次查找。
时间戳补不出顺序。
双向链表反过来。维护顺序几乎不要钱:命中一个节点,从原位摘下来挂到头部,六次指针写,O(1),跟链表多长没关系。可你得先找到那个节点,链表没有下标,只能从头走,平均 n/2 步。
一个管定位,一个管顺序。
LRU 每次 Get 要同时回答这两件事,两个都得留,两个都得是 O(1)。拼法是让指针互相指:map 的值不放数据,放链表节点的地址。查找在 map 里做,拿到的是节点指针;顺序在链表里维护,拿到指针就能直接摘挂。定位的结果正好是排序结构里的位置,两个 O(1) 接在同一个动作上,中间没有一次额外的查找,也没有一次额外的分配。缺了哪一半都不成立,只有 map,顺序没了;只有链表,定位退化成线性扫。
一次命中写六个指针
实现只有三个动作:摘下来,挂到头部,满了摘尾巴。
1 | type entry struct { |
unlink 两次赋值,pushFront 四次,一次命中六次指针写。头尾各放一个哨兵 entry,摘挂的时候不用判断 nil,少四个分支,代价是两个永远不存数据的节点。
这叫侵入式链表:节点自己带 prev 和 next,map 的值是 *entry,一个 key 在内存里只有一份。Java 的 LinkedHashMap 走了另一条路,它在 HashMap 的 Node 上直接加了 before 和 after,等于在同一批节点上穿两条链,桶链一条、访问链一条,一次分配解决两件事,代价是每个 Node 都多两个指针,不管那个 key 用不用得上访问链。Go 的 container/list 是第三种,Element 是个独立类型,你得自己包一层,或者再存一个 map 从 key 找到 Element,多一次分配、多一次间接。三条路都行,差别就在每命中一次多跳几次指针、多占多少字节。
每次 Get 都在写,这一点最容易被忽略。unlink 改两个指针,pushFront 改四个,六次写落在两处内存上:被摘的节点一处,头部一处,两者不相邻就是两次缓存未命中。单线程下这是几个纳秒,可以忽略;多线程下它就是 LRU 难做并发的原因,命中率越高写越频繁,读操作要么拿写锁,要么上 CAS 重试,怎么绕都绕不开那六次写。1000 个 entry 散在堆上,每个 32 字节,key 8、val 8、两个指针 16,map 的桶还得另外算,一次命中至少碰两处不连续的内存。
命中率从 0 到 86
命中率只跟一件事有关:这次访问的 key,上一次被访问之后,中间插进来过多少个不同的 key。这个数叫重用距离,距离小于容量就命中,大于容量,那个 key 早被挤出去了。它跟用什么结构存没关系,跟哈希函数没关系,跟有没有用哨兵更没关系。
四种分布,同一份实现。
| 分布 | key 空间 | 单实例 | 8 分片 |
|---|---|---|---|
| uniform 均匀随机 | 10000 | 10.05%(100506) | 10.06%(100623) |
| zipf 齐夫 1.2 | 10000 | 86.16%(861640) | 86.16%(861582) |
| loop 循环扫 | 1001 | 0.00%(0) | 87.33%(873251) |
| sequential 一遍过 | 1000000 | 0.00% | 0.00% |
uniform 最好算。key 空间一万,容量一千,理论上限就是一千除以一万,百分之十,实测 10.05%,几乎没有余量,说明这一千格用得极其干净。这条曲线是线性的,容量翻倍命中率翻倍,一千和两千的差别是十和二十。
zipf 1.2 完全另一副样子。头部一两百个 key 吃掉大半访问,容量过了一个点之后再翻倍,只多几个百分点。86.16% 在容量一千的时候就是这个值,加到两千也不会变多少,剩下的 13.84% 是长尾,靠加容量追不回来。
容量只在一种分布上是杠杆。
loop 和 sequential 是两种没有重用的极端。loop 扫 1001 个 key,容量 1000,永远差一个;sequential 一遍过,每个 key 只出现一次,命中率的上限就是零。这种输入下任何容量有限的缓存都是零,跟 LRU、LFU、FIFO 都没关系。
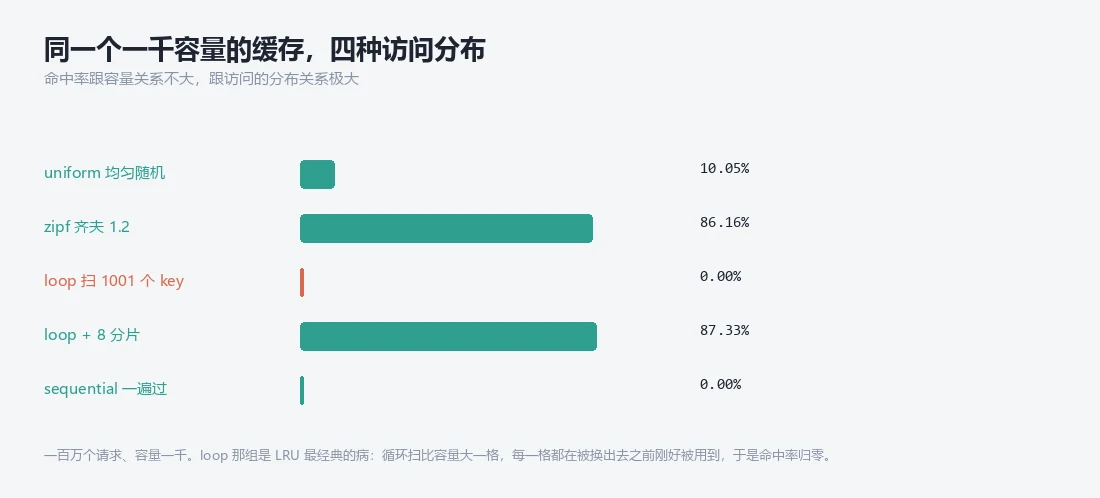
前两组的柱子几乎一样高,第三组差了八十七个点,第四组两根都贴着地。
定结果的是输入。
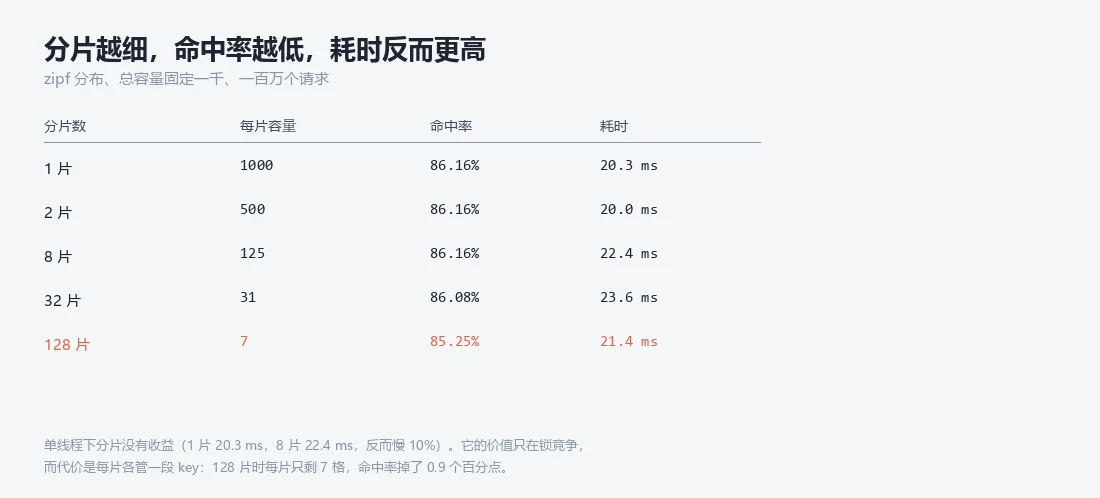
分片之后,慢了百分之十
分片是把 key 路由到 n 个独立 LRU 上,每片有自己的 map、自己的链表、自己的一把锁,容量一千平均分,8 片就是每片 125 格。
| 分片数 | 每片容量 | 命中率 | 耗时 |
|---|---|---|---|
| 1 | 1000 | 86.16% | 20.317 ms |
| 2 | 500 | 86.16% | 19.9772 ms |
| 8 | 125 | 86.16% | 22.4366 ms |
| 32 | 31 | 86.08% | 23.6003 ms |
| 128 | 7 | 85.25% | 21.4295 ms |
命中率几乎不动。1 片到 32 片,86.16 到 86.08,掉在小数点后两位。128 片掉到 85.25,每片只剩 7 格,全局的最久没用被拆成 128 个片内最久没用。耗时倒是涨了,20.317 ms 到 22.4366 ms,8 片比 1 片慢 10.4%。
2 片那次 19.9772 ms 是唯一比 1 片快的,差 0.34 ms,我倾向认为是噪声。
单线程下分片为什么慢,三笔账。第一笔是路由,每个请求先算一次下标,再取片指针,多一次间接寻址。第二笔是局部性,一个 1000 条的连续工作集被拆成 8 份 125 条,每份的 map 头、两个哨兵、桶数组各在各的堆块上,跳转目标从一处变成八处。第三笔是淘汰,全局最旧变成片内最旧,命中率掉的那零点几个点就是账单。三笔加起来,比省下的那点更短链表值钱,而单线程里根本没有锁可省。
有锁可抢,分片才值钱。
分片提升吞吐这句话有边界:有竞争时它才值钱,没竞争时它只是把一次访问拆成两次。表里 8 片的 22.4366 ms 和前面单实例的 18.748 ms 不是同一组实验。分片扫描那组为了让每片独立计数,埋点位置跟单实例那组不一样,基线本来就被抬高了一点。要横着比,看同一张表里的 1 片和 8 片。
循环扫 1001 个 key,一片都没中
loop 那一行最反直觉。
单实例 0.00%,一百万个请求一次都没中;切成 8 片,87.33%,差不多是从没有变成几乎全中。
原因在重用距离的形状。循环访问 1001 个 key、容量 1000,LRU 每次淘汰的正好是下一次要用的那个:最久没被访问的,就是循环里马上要轮到的那一个。顺序扫描和比容量大一点的循环都能触发,跟实现写得好不好没关系。
分片把这个循环打散了。一千格切八份,每份 125 格;1001 个 key 按哈希摊到八片上,大约是七片各 125 个、一片 126 个。前七片的工作集刚好等于容量,扫一圈每个 key 都还在,全中;第八片多一个,永远差一格,全不中。七乘 125 除以 1001,理想值 87.41%,实测 87.33%,差的 0.08 个百分点是冷启动那一两百次。原始那一整条流被切成八条互不相干的短流,每条都装得进自己那格,坏形状就没了。
同一条规则,符号反了。
坏分布得是循环;循环长度得刚好比容量大一点点,大十倍就没救;分片的切法得让每片的工作集刚好装进每片的容量。三条缺一条,分片就退回纯开销:zipf 下 86.16 对 86.16,没涨;uniform 下 10.05 对 10.06,也没涨。
五万次随机操作,两边每一步都一样
LRU 的 bug 不在算法上,都在边界上。我拿朴素版当对照,跑五万次随机操作,每一步都比对返回值和缓存内容,两边逐次一致。边界就那么几个:容量等于一,摘完 head 就轮到 tail,别把哨兵当成真节点;Put 一个已经存在的 key,要更新值并且挪到头部,只更新值不挪位置,顺序就错了,这个错在命中率高的分布下几乎看不出来,因为那个 key 大概率马上又会被用到;淘汰时先把 key 从 entry 里读出来再 delete,unlink 之后指针还在,delete 之后 map 里就没这个 key 了,两句写反就删错;len(m) 才是真实容量,别拿容量字段当计数器。
够随机,才撞得出边界。
自己写,还是直接用
单进程、容量一万以内、没有 TTL、读写比极高,四十行自己写。你要的只是一个按访问顺序排队的 map,引入一个库反而多一层依赖和一次版本升级的风险。
跨进程或者要 TTL,交给 Redis。它的 allkeys-lru 是近似 LRU:淘汰时采样几个 key,挑其中最旧的,不维护全序。精确 LRU 每次读都要写,近似 LRU 只花几次采样。
命中率差多少,上面那些数能回答一半:实现换了,命中数可以一个不差,精确性压根不是决定命中率的那一项。
要并发,先量锁竞争。pprof 的 mutex profile 里没有热点,就别分片;有热点,再按 key 分,并且接受 128 片时每片只剩 7 格的那个代价。
要按权重淘汰、要抗扫描,用现成的。Caffeine 和 ristretto 都把这件事做完了,W-TinyLFU 那套准入过滤器专门对付 loop 这种一次性的扫描流,它比 LRU 多花的是一次频率统计。
我现在的默认选择是:能自己写就自己写,四个函数加两个哨兵,可读、可调、出错好查;一旦要跨进程、要 TTL、要并发,立刻换成现成的。判据只有一条,换实现之后命中率会不会跟着变。这张表说不会。