删中间一个元素要挪多少人

删中间一个元素要挪多少人
隔壁老康难度 ★☆☆☆☆ · 前置:切片扩容为什么要拷贝整块内存 | 一句话结论:中间删除贵在要把后面每个元素往前挪一格,顺序一旦可以不保,把末尾那个换过来就只挪一个。
报表按几个条件把明细筛一遍,筛掉的从切片里删掉,这活我十二月头上接的。我照着以前写脚本的习惯写了一段,外面一层 range,命中就删一次,四行代码,读起来顺得很。本地点了两下,按钮按下去要等一下才出结果,我第一反应是查库慢,把查库换成硬编码的假数据,还是要等一下。那天我前后改了三遍查询,一点用都没有,因为慢的地方不在库里。
(现在回头看,我那会儿连慢在哪一段都说不清,就敢去改 SQL。)
那一下到底是多久,我说不上来,因为我没有量。
删除是这一行:s = append(s[:i], s[i+1:]...)。书上给它标了 O(n),标题是删除第 i 个元素。O(n) 我认得,也背得出为什么是 n,因为后面的元素都要往前挪一格补上这个洞。
可我从没数过那个 n 在我手上是什么量级,也没算过挪一格要花多少秒。十二月我把它拆开量了一遍。
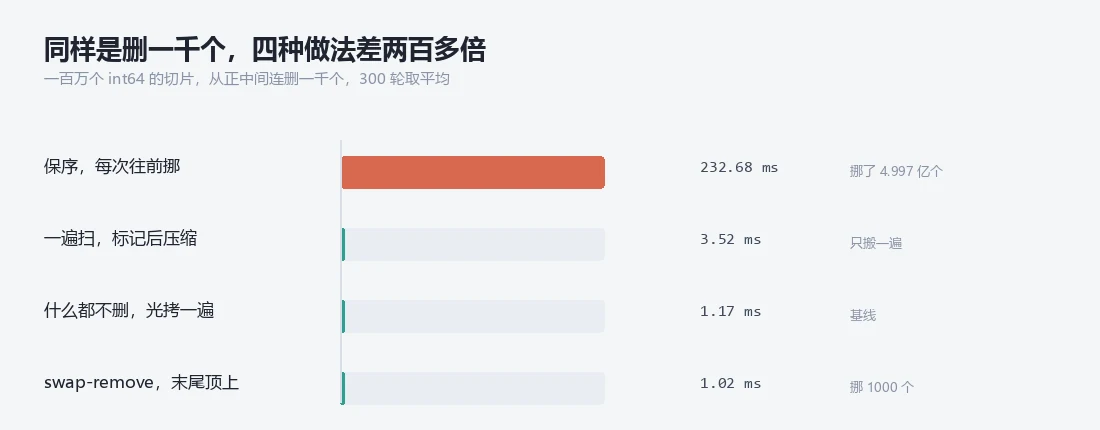
从中间删掉一千个,要两百三十二毫秒
量的是三种删法,数据一样:一百万个 int64 的切片,八兆字节,从正中间开始连删一千个。机器还是这台笔记本,32 个逻辑核,windows/amd64,手工计时,每种删法跑 300 轮取平均。取平均不是偷懒,三百轮里前几轮在给缓存热身,会把平均值抬高一点点,这点偏差比删法之间的差距小得多,不值得为它另写一段排序代码。三种删法都写成普通函数,没上泛型,也没调编译开关,就是最平常的那份代码。
| 删法 | 连删一千个 | 干了什么 |
|---|---|---|
| 保序删,每次都从中间起手 | 232.68 ms | 后面全部往前挪一格 |
| swap-remove | 1.02 ms | 把末尾那个拽到空位 |
| 一遍扫、标记后压缩 | 3.52 ms | out := s[:0] 再 append |
| 只拷一遍的基线 | 1.17 ms | 什么都不删,光 copy 八兆字节 |
第一行和最后一行差 199 倍。
保序那条就是书上那行代码,抄成函数四行,本本分分,单看挑不出毛病。
1 | func deleteAt(s []int64, i int) []int64 { |
最后一行的基线是这台机器搬八兆字节的地板价,删不删都得先付这一笔,保序那条 232.68 ms 等于把地板价重复了两百遍。swap-remove 那一行比基线还快,1.02 对 1.17,删东西比不删还快。原因在基线干的活它没干:swap-remove 从头到尾只改了一个元素、改了一个长度,一次连续的内存拷贝都没发起过,而基线那 1.17 ms 是实打实把八兆字节从一块地址搬到另一块,它不产生任何结果,只是把地板价量出来摆在那儿。
232.68 这个数我拆不干净。里面有多少是搬字节,有多少是一千次调用的开销、边界检查、切片头改写,我没法分开量,所以只写总数。能确定方向的是计数器:这一千次删除累计挪了 499749000 个 int64,乘 8 差不多四 GB,而基线只搬了八兆,前者搬的字节数是后者的将近五百倍,耗时却只差 199 倍。这两个数对不上,我猜是一块一块搬比一个一个赋值省,这条我没验证,先记在这儿。
从中间删一个,要挪一半
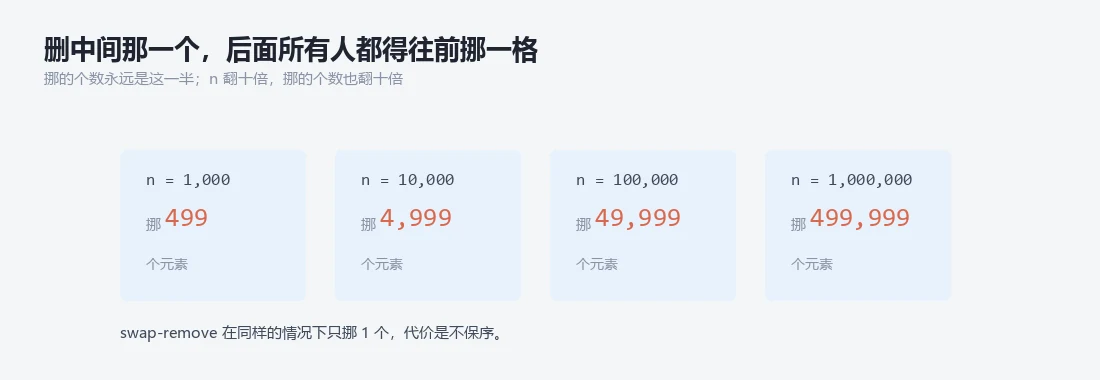
计时只回答贵不贵,计数才回答贵在哪。我给三种删法各挂了一个计数器,每挪一个元素加一,不碰计时器,也就不受风扇转速、编译器版本和缓存的影响。写法很土,赋值拆成先读出来、加一、再写回去,跑完把三个数对着看。这组数字比秒表干净,它不依赖机器,换台笔记本重跑还是这些数。
| 切片长度 | 从中间删一个挪了几个 | 占比 |
|---|---|---|
| 1000 | 499 | 49.9% |
| 10000 | 4999 | 50.0% |
| 100000 | 49999 | 50.0% |
| 1000000 | 499999 | 50.0% |
后三档一个不差,都是 50.0%。
一半。
换算成字节更直观:n 是一百万时删中间一个,往后挪 499999 个 int64,差不多四兆,点一下删除搬四兆。
而尾部删除挪 0 个,swap-remove 挪 1 个。
从中间连删一千个,差距还要再放大一次。保序那条累计挪 499749000 个,swap-remove 累计挪 1000 个,两者差 499749 倍。每删掉一个,切片短一格,下一次起手还在中间,所以每次挪的量几乎没变,一千次加起来就是这个量级。计数器给出五十万倍,秒表给出 199 倍,两个数不矛盾,量的不是同一件事:秒表里混着块搬运的效率、调用开销和内存带宽,计数器只数逻辑上搬了几个元素。要跟别人解释为什么慢,计数器那组更好用,它不需要复现环境,也不需要同一台机器。
换末尾那个过来,只挪一个
swap-remove 的全部内容是两行:把末尾那个元素写到要删的位置上,然后把长度减一。它只碰一个元素,所以挪 1 个。代价也很直接:原来第 i 个位置上,现在躺着的是本来在末尾的那个,末尾那个元素原本的内容,从此没了。位置和内容之间的对应关系被这一次赋值改写了,便宜的全部来源就在这儿。
1 | func swapRemove(s []int64, i int) []int64 { |
顺序在这招里是被牺牲掉的东西。能用它的前提得列清楚:这批元素的位置本身没有业务含义;删除之后没有人再按下标去引用某个元素;调用方接受数组尾部的值会变。三条里有任意一条不成立,这招就不能用,用了就是在别的模块里留下一个更难查的错,报表那种按时间排好、导出去要跟上个月对得上的场景,第一条就不成立。循环里用它还有个小坑:命中之后把末尾换过来,如果接着 i++,换过来那个元素就被跳过了,它一次都没被检查,正确写法是命中后原地不动,用 continue 重新看同一个下标。
第一版我写了 i++,跑完发现留下的条数比预期多,查了半天才发现是换过来的那几个没被看到。
第一版基准把八兆字节的拷贝量了进去
第一版基准是每轮开头重新 make 一块切片,把原始数据 copy 进去,再按下计时器删一个。跑出来三条都在 2 ms 上下,三条挨得那么近,我一开始还挺高兴,以为这说明三种删法差别不大。坐了半分钟才明白那 2 ms 是什么,是拷八兆字节,跟删不删一点关系都没有,我用一块背景噪声把最想量的东西整个盖住了。三条 2 ms,等于什么都没量。
改法看着很自然,把还原那两行用 b.StopTimer() 和 b.StartTimer() 夹出去。
1 | func BenchmarkOrdered(b *testing.B) { |
改完测试直接挂死,连一行输出都没有。
尾部删除的计时区间只有几纳秒,Go 的校准器看到这么小的数就拼命加大 b.N,可每一轮中间还夹着一次八兆字节的拷贝,跑到超时也出不来,它挂死的地方不在代码里,在量法里。最后我换了两条路:单次删除不还原数据,因为 copy(s[mid:], s[mid+1:]) 这个动作重复做结果不变,幂等,第一遍和第一万遍效果一样,我只要挪动的计数,不在乎被覆盖掉的内容;批量删除用固定 300 轮的手工计时,每轮之间还原一次,还原的时间记在账外。量法比被测对象难写,这句话我以前只是听过。
秒表按错了位置,量出来的就不是那个东西。(跟上一篇量单次 append 量出 0 纳秒是同一类错。)
保序这条线一划,便宜就没了
判断顺序要不要保,我一般问三句:这批元素的位置本身是不是信息;删除之后有没有人按下标回取;同一份底层数组会不会被别处共享。报表三句全踩,所以那张表里 232.68 ms 那一行,是我当时唯一能选的一行。保序不是免费,它是按元素收钱的,删掉一个元素,后面的每一个都要替它走一步,n 越大,账单越长。更麻烦的是这笔账不好提前感觉到,代码只有一行,写下去没有提示,只有一千个导出任务排着队进来的时候,你才会发现每个任务都在原地搬半个数组,而搬完之后看上去什么都没有变,页面上的条数少了二十几条,顺序还是那个顺序。
顺序不是白来的。
不过选了保序,不等于只能一次删一个。这是两个问题,我一开始把它们混成了一个,所以第一版改来改去都在两百多毫秒那个量级里打转,还以为是机器不行。
分开看之后,路子就出来了。
一千次删除,不如一遍扫
要一次删很多个,正解是走一遍、把留下来的往前压。开一个长度为零、容量不变的切片头,从头扫,保留的元素 append 进去,扫完截断。整个过程只在原来那块内存上读写,不新分配,也不搬整块。
1 | func keepRows(s []Row) []Row { |
3.52 ms。
这个数跟基线的 1.17 ms 是一个量级,说明它花的钱基本就是走一遍八兆字节,再加一遍把留下来那些写回去,一千次删除变成一次扫描,剩下的成本是读一遍、写一遍,压不下去了。三个细节值得记一下:out := s[:0] 复用底层数组,append 不会触发扩容,除非容量本来就不够;被删掉的元素还留在底层数组的尾巴上,如果元素带指针,那块内存不会被回收,扫完要把尾巴清干净,上面那段代码里那个循环干的就是这件事;还有,调用方如果还握着旧切片,它会看到前面几格被覆盖过,这块内存是借出去还是收回来,得有个说法。
这三条都不是看文档看来的。
在三种删法里,3.52 ms 是保序那一档最便宜的写法。它比 swap-remove 的 1.02 ms 贵三倍多,那三倍就是顺序的价钱,一次都省不掉。
那道一百九十九倍的账
把那 199 倍拆开,只有两笔账。一笔是走了多少步:保序一千次删除挪了 499749000 个元素,swap-remove 挪了 1000 个,尾部删除一个都没挪,这个差距是数出来的,换台机器也一样。另一笔是每一步多贵:保序每次搬的是一段连续内存,按块搬;swap-remove 搬的是一个八字节的值。两笔乘起来才是那张表,第一笔占绝大多数。第一笔在计数器上,第二笔在秒表上,我一开始只有秒表,所以只知道前者很贵很贵,说不清贵在走的路多还是每一步的单价高,直到补了计数器,才看清单价那笔小得可以忽略。
O(n) 和 O(1) 都对,倍数是错的。复杂度说的是 n 变大时时间往哪边走,它不告诉你 n 等于一百万时一步要几纳秒,也不告诉你一块连续内存搬过来要不要等。真要知道,只能挂个计数器数一遍,再把秒表按在正确的区间里跑一遍,两样都得有。少了计数器,你只知道慢;少了秒表,你不知道慢多少。
先问顺序要不要保
现在我写删除之前会先问三句:顺序要不要保;是删一个还是删一批;这块底层数组还有没有别人握着。答案决定写法,写法定下来之后才轮到性能。顺序不保、又只删几个,swap-remove 就是一次赋值加一次截断。要保序、删得多,就走一遍压一遍。只删一个、又要保序,认命,copy 那一行没有更便宜的做法,你可以把它挪到循环外面,一次删完,但挪格子这件事本身省不掉。这三句我现在写在便签上,跟上一篇那三条并排放着,字比上一篇小一号,因为第三句后面还跟着一段没想清楚的话:如果调用方也拿着这块底层数组,压缩算不算把它的数据改坏了,我给不出通用答案,只能每次到现场看谁还握着那块内存。
问完这三句,删法基本就定下来了。
报表那段代码后来改成了压缩写法,函数名从 deleteRow 改成了 keepRows。结果一样,顺序一样,条数一样,只是不再一次挪半个数组。
(改完那天我没敢直接合,先在测试环境把上个月报表重导一遍,逐行比过才提的合并请求。)