数组到底快在哪
数组到底快在哪
隔壁老康难度 ★☆☆☆☆ · 前置:O(1) 是骗人的 | 一句话结论:数组快的不是随机访问,是它把数据摆在了能被整块搬进来的位置上。
一千万个 int64,四种读法
晚上十点,第五遍基准跑完,我盯着终端上那四行数,越看越不对。入职三个月,我天天写 for 循环遍历切片,也天天跟人说数组快,理由背得很顺:下标乘上元素大小就是地址,算完直接读,O(1)。想把这句写进注释的时候卡了一下,O(1) 说的是索引怎么算出来,一个字都没解释为什么算完就快。于是我在自己机器上补了三个基准:一千万个 int64,顺序读一遍,每八个读一个,再随机抽一百万个下标读,另拉一条同样长度的链表做对照。
机器还是这台笔记本,windows/amd64,每个基准跑 -count=5 取中位数。绝对值不用记,换台机器全都变。
四个基准写在一个文件里,数据在 init() 里一次建好,计时从 b.ResetTimer() 之后才开始,每轮的和塞进一个包级变量,免得编译器觉得这段循环没人要。链表是从末尾往前插头接出来的,第 0 个节点建得最晚、地址最小,往后依次变大,遍历的方向跟地址增长的方向一致,等于我一开始就挑了条对它有利的排法。跑 -count=5 是第一次跑完自己不服气:同一条命令连跑,头一次总比后面几次慢一截,取中位数至少能把开头那点抖动按下去。三个基准各自独立跑,互不串味,跑之前把浏览器和编辑器都关了,机器插着电。
数字在这儿。
| 读法 | 碰了多少元素 | 中位耗时 | 相对顺序遍历 |
|---|---|---|---|
| 顺序遍历 | 全部 | 16.9 ms | 1.00× |
| 跨步 8 | 八分之一 | 8.2 ms | 0.48× |
| 随机下标(只做一百万次访问) | 十分之一 | 30.0 ms | 1.77× |
| 链表遍历 | 全部 | 31.9 ms | 1.89× |
第二行最不讲道理。只读八分之一的元素,按理说该快八倍,实测只快了一半。第三行更别扭,它只做了一百万次访问,是别人的十分之一,耗时反倒是人家的 1.77 倍。
我先怀疑的是基准写错了。回去把三段循环抄在纸上逐行看,跨步那个是 j += 8,随机那个的下标用固定种子生成,链表是倒着接出来的,三处都对。
错的不是代码。
并发和 GC 都不在这篇的范围里,量的是单线程的一段循环。
只读八分之一,却只快了一半
跨步的循环本身没什么可看的。
1 | for j := 0; j < n; j += 8 { |
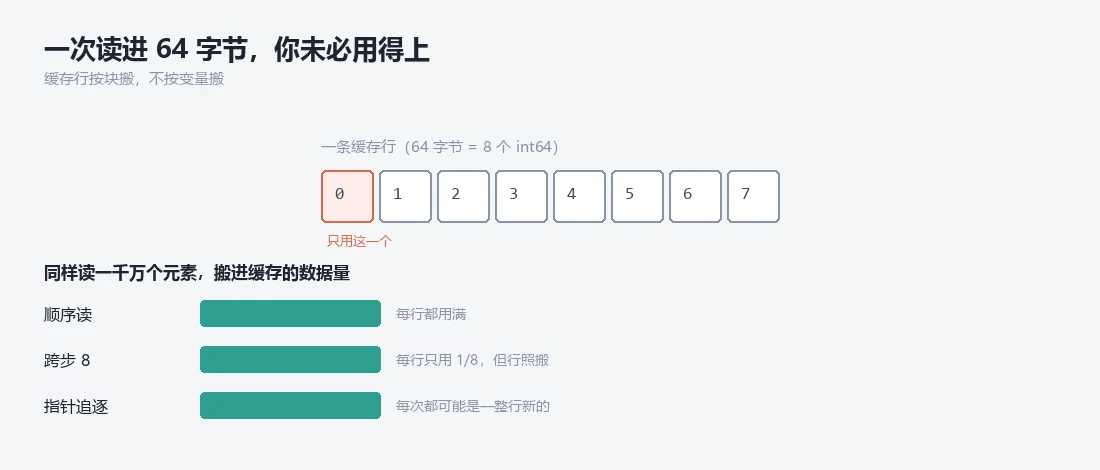
下标每次加 8,int64 是 8 字节,两次访问之间隔着 64 字节。看着像跳着走,其实它一步没少走:一千万个 int64 排成一条线,每 64 字节取一个,整条线还是被从头到尾摸了一遍。省掉的是加法次数,没省掉的是把字节搬过来的次数。一行 64 字节正好装下八个 int64,跨步 8 每跳一次刚好落在下一行上,所以它碰到的缓存行跟顺序遍历一样多,最乐观也只能快两倍,测出来 0.48 已经贴着这条上限了。
一行八个,只拿走一个——算术不要钱,搬运要钱。
随机那一行从反方向把同一件事又证了一遍。一百万个下标撒在 80 MB 里(一千万乘 8 字节,这个数是算的,不用测),前一次读进来的东西下一次几乎用不上,每一次都得重新去把那一块找回来。它只干了一千万次顺序访问十分之一的活,花的时间是 1.77 倍。
时间不跟着访问次数走,它跟着搬进来的字节数走。
内存是按行搬的,一行 64 字节
这一条我在自己机器上测不出来,它属于体系结构的事实:这一档 x86 上,CPU 和内存之间搬东西的单位是缓存行(cache line),64 字节,不是一个变量。你要读一个 int64,硬件会把包住它的那 64 字节整块拖进一级缓存,顺手还能看出你在顺着走,把后面几行也提前搬进来,这一步叫预取(prefetch)。顺序遍历快,是因为每一步都在骑上一步的车:一次搬运带上来八个元素,后面七个几乎不额外花钱。预取器猜得中,搬运的账就摊薄了;猜不中,每一次访问都得从头等一趟。
还有一层,我原来完全没算进去:地址翻译本身也要走缓存。程序里看到的地址是虚的,落到物理内存得先查页表,而页表项也不在内存里现查,它缓存在 TLB(translation lookaside buffer)里。一级 TLB 就那么一百多条,够不着的时候翻出来的代价是往内存里多走几趟。八十兆的数据按四页大小摊开是两万多页,随机走一圈下来,TLB 那一层跟缓存行一样在跟你作对。所以大数组的随机访问比同样字节数的中数组更贵,贵出来的那一份不全在缓存行上。这一项我没有单独拆出来量,只能说方向一致。
猜不中说的是指针追逐。顺着 p.next 走的时候,下一个地址就存在上一跳读到的那块内存里,硬件在你读完这一跳之前不知道下一步去哪儿,预取器没有东西可以猜。
第一张表里链表是 31.9 ms,1.89 倍。这条链表的节点是倒着接出来的,分配顺序和遍历顺序基本重合,等于我已经把最有利的排法给它了。它还是慢将近一倍,原因也简单:节点 16 字节(一个 int64 加一个指针),一千万个就是 160 MB,扁平切片是 80 MB,搬的量翻了一倍,时间跟着翻一倍。
所以问题得换个问法。
该问的是这堆数据在内存里排成什么样,标签上写数组还是写链表,无所谓。
同一份数据,五种摆法
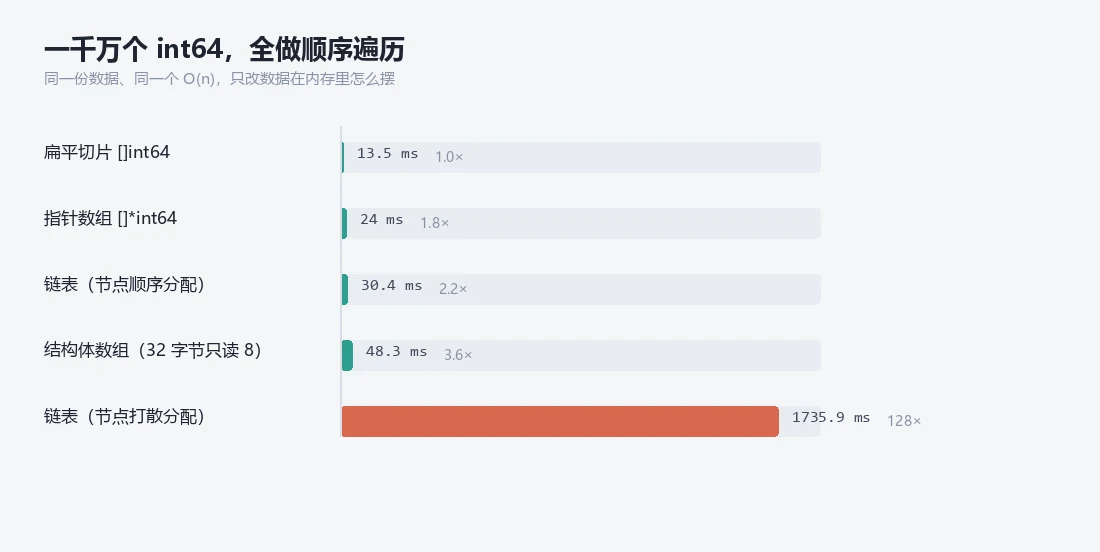
第二组只做一件事:一千万个 int64,装进五种容器,全都做顺序遍历求和,比中位耗时。循环体一模一样,变的只有数据在内存里的落点。
| 容器 | 中位耗时 | 相对扁平切片 |
|---|---|---|
扁平切片 []int64 |
13.5 ms | 1.0× |
指针数组 []*int64 |
24.0 ms | 1.8× |
| 链表(节点按顺序分配) | 30.4 ms | 2.2× |
| 结构体数组(每个 32 字节,只读 8 字节) | 48.3 ms | 3.6× |
| 链表(节点打散分配) | 1735.9 ms | 128× |
从上往下看。最下面那一行先留着。
第二行是 []*int64,指针数组。它自己是一块连续的 80 MB,下标访问一样是 O(1),索引上没有半点劣化。慢到 1.8 倍不是因为它散,我特意把所有指针指向的那一千万个 int64 放在同一个块里挨着排,这是对指针数组最友好的排法。
它还是要慢。指针自己就占一份字节,指针 80 MB 加上数据 80 MB,要搬的量翻倍。测出来 1.8 倍比 2 倍略低,因为这里第二条流也是顺着的:ptrArr[i] 指的就是 ints[i],读指针和读值两条流都在往前走,预取器两边都跟得上。真实业务里指针指向的东西散在各处,第二条流就断了,只会比 1.8 倍更差。
壳是连续的,瓤不一定。
第三行是结构体数组,每个结构体 32 字节,里面只有第一个字段有用,另外三个是占位的。
1 | type padded struct { |
数据完全连续,预取器一样能顺着带,量出来 48.3 ms,比扁平切片慢 3.6 倍。原因不难找:每搬进来 32 字节,只用得着开头 8 字节,四分之三的搬运量搬的是没人看的东西。一千万个这样的结构体占 320 MB,扁平切片只占 80 MB,四倍的账,测出来 3.6 倍。
这一组最容易被误读成缓存没用,缓存挺冤的:它老老实实按行搬,一个字节都没偷懒,代价是每搬进来四份只用得上其中一份,剩下三份纯属陪跑。数据连着,通路没毛病,是每一份里能用的那部分太少了。
被浪费的是空间,不是缓存。
同一条链表,两个数差了 57 倍
现在说留着的那一行。链表按顺序分配 30.4 ms,节点打散 1735.9 ms,2.2 倍和 128 倍。同一份数据,同一个 O(n),遍历代码一个字没改,变的只有一千万个节点落在内存的哪些角落。
打散是这么做的:先把一千万个节点老老实实建出来,再拿固定种子洗一遍牌,按洗过的顺序串成链。这里一个字都没挪,一千万个节点在内存里还是连着的,160 MB 一整片,动的只是遍历的顺序。顺着 p.next 走,每跳一次都落在离上一次很远的一行上,上一次搬进来的那一行半点忙帮不上。16 字节的节点一行刚好装四个,顺着走的时候这四个能被同一趟搬运服务完;顺序一乱,一次搬运只服务一个节点,同一行里另外三个要等到不知多少跳之后才轮得着,那时候它早被挤出去了。128 倍是这么来的。这还是个手下留情的版本:真实业务里的节点压根不在一块儿,一个个 new 出来,中间还夹着别人的对象。
顺序分配那条为什么能跑到 30.4 ms?因为分配器把它们一个挨一个地发下来。倒着接这个动作,恰好把分配顺序和遍历顺序对齐了,内存里就是一条连续的路,预取器工作得挺好。它跟扁平切片差的 2.2 倍,基本就是节点里多出来的那 8 个指针字节,16 字节对 8 字节正好两倍,多出来的一点是每跳一次多走的一步。
链表慢这句话,得加条件。慢在节点散落,不慢在指针本身。指针就 8 个字节,读它一下的代价是固定的;散开以后麻烦的是每跳一次都变成一次独立的、没法预取的内存访问,还得等上一跳的结果才能发出下一跳,延迟一层层叠上去。三十毫秒和一千七百毫秒的差别,主要在这一件事:下一步要去哪儿,能不能提前知道。八十兆的数据在四页大小的页面下是两万多页,地址翻译那层缓存放不下这么多项,翻页表也得等——这笔账我没单独拆出来,但方向跟缓存行是同一边的。
57 倍,跟指针没有关系。
省下的只有搬运那一项
这五组数我后来又对着看了两遍,冒出来的头一个念头是那以后是不是全用切片。想了几天,答案是不全是:压成一整块,省下的只有搬运这一项,别的账它一概不认。
压成一整块是有前提的。遍历次数远多于插入删除,压缩能摊薄的只有搬运,摊不薄增删。结构体里只有一个字段是热的、其余都是搭车的,把热字段抠出来单放一个数组最省事,接口都不用改,改动量比想象中小。元素本身是指针、指向的那块内存也没有别处共用,那就一起搬过来,把那一步跳省掉。三种改法的共同点是热点上只有一堆同类型的字节在往前推,没有第二个方向。
什么时候别压。
数据量小的时候。总共几十 KB,塞得进二级缓存,链表和数组的差距会被摊到看不出来,这时候代码好不好读更要紧。频繁在中间插入删除的时候也别硬压。
还有一种容易忽略:把一个大结构体拆成两个数组并行读,看着像优化,实际等于同时开两条数据流,缓存和地址翻译都要多伺候一份,拆之前得量,不能按着感觉拆。
上面所有绝对值换台机器都会变,缓存大小、内存频率、分配器的实现没有一样是一样的。变的是毫秒,不太变的是倍数。
现在我看一段循环,先想的不是它 O 几,是它能不能顺着走。能顺着走就尽量顺着;非跳不可,就先数数要跳几次、每次跳多远。