一张表,三个我踩过的坑

一张表,三个我踩过的坑
隔壁老康难度 ★★★★☆ · 前置:链表和哈希表拼起来,就是 LRU | 一句话结论:选错结构很少让程序算错,它让程序算对之后,每一次调用多付十几倍到几千倍的钱。
选错数据结构很少让程序算错。缓存还是那个缓存,Top K 还是那 Top K,测试全绿,评审也过了,输出一条不差,耗时连监控都没进过。它只做一件事,把每一次调用的价钱抬上去。这个价钱在开发机上被满屏日志盖住,等它露头,通常是压测报告或者月底账单,那时候结构定下来好几个月了,改它要牵动一圈调用方,改完还得把回归重跑一遍。四十来篇笔记摊在桌上,最扎眼的地方是它们互相打架:链表那篇说插入便宜,数组那篇说随机访问便宜,两句话都对,可同一份数据只能挑一个装法,挑完另一个的便宜就再也拿不到。写代码那一刻没人翻笔记,翻的是一句感觉,感觉是从最近写过的那个结构里借来的,最近写过链表,看什么都像链表。
凭印象挑,十次能对几次。
按操作查,别按名字查
先把印象换成一张按操作查的表。行是动作,列是首选、次选,以及什么时候别用首选。列名我改了两遍,前两遍写的是优点和缺点,写出来全是正确的废话。
谁都看得出链表插入快,问题是快在哪一行需求上。
表只认动作,不认名字。
| 你要做的事 | 首选 | 次选 | 什么时候不选首选 |
|---|---|---|---|
| 纯查找,给 key 取 value | 哈希表 | 排序数组加二分 | 要按 key 顺序遍历、要范围,它给不了;key 是连续小整数,下标更快 |
| 按 key 有序遍历 | B+ 树 | 平衡树、跳表 | 数据在内存、只读,排序切片就够;写并发高,跳表更好写 |
| 范围查询 | B+ 树 | 跳表、排序切片 | 哈希表连相邻的 key 都不挨着,这一行它没资格 |
| 前缀匹配 | 排序切片加二分 | Trie、双数组 Trie | 词表只有十万级,先别上 26 指针的 Trie;要边插边查再考虑树 |
| 只要前 K 个 | 小顶堆,堆里只放 K 个 | 快速选择 | 别全排序;别先去重,Top K 不要求元素互不相同 |
| 定长缓存要淘汰 | 哈希表加双向链表 | 环形缓冲、CLOCK | 别拿切片线性找;访问模式不符 LRU 假设时,FIFO 更省 |
| 去重、计数 | 哈希集合 | 布隆过滤器、HyperLogLog、位图 | 布隆过滤器删不了元素;要精确计数就别用近似 |
| 点与点之间的关系 | 邻接表、CSR | 邻接矩阵 | 点上万又稀疏,矩阵的问题不是慢,是装不下 |
| 先进先出、后进先出 | 环形缓冲、切片 | 链表、双端队列 | 定长队列别用链表,每个节点一次分配 |
| 已知位置反复增删 | 链表 | 双端队列 | 数据小、或者要随机访问,链表不如切片 |
| 把一个 key 分给多台机器 | 一致性哈希 | 取模 | 节点几乎不变就用取模,便宜;频繁变才需要环 |
| 写多读少还要顺序扫 | LSM 树 | B+ 树 | 点查多、延迟敏感,LSM 的读放大会反过来咬你 |
| 只问连不连通 | 并查集 | DFS、BFS 重扫 | 要问具体路径、要中途删边,它答不了 |
我把两行删掉了,一行给字符串,一行给位图。它们归在编码那一层,硬塞进来会把整张表撑歪,真要问字符串为什么不能原地改,表答不了,只有内存布局答得了。剩下的每一行都对着一个具体动作,不对着名字。人最容易犯的错是从结构名开始翻,先决定要用哈希表,再去找一个能用哈希表的理由,找得到,找的过程还很顺。顺完了回头看,这行需求要不要范围、要不要顺序、会不会频繁更新,一个都没问过。表给了人一种查过的踏实,这种踏实比无知更难改,无知的人还会去量一量,查过的人以为自己已经查过了,两种人里后者更难劝。
填不对的表比没表更害人。
每一行都带着没写进表的前提
哈希表在这张表里出现了四次,危险就藏在这个次数里。它确实快,前提是装载因子没失控、哈希函数把 key 摊匀、冲突没退化成一条长链。三件事塌掉任何一件,O(1) 就退成 O(n),退化之后它依然正确,只是慢得让人去怀疑别的地方。堆也占了两行:取前 K 个用的堆,堆里从头到尾只放 K 个;优先队列用的堆,所有元素都在里面。两种用法共用同一段 push 和 pop,代码上只差一行初始化,差的那一行决定了内存里装几个元素,也决定了复杂度里那个 K 是不是常数。
前缀那一行是在两种成本之间挑:排序切片把成本花在建表时那一次排序,之后每次查询只要一次二分;Trie 把成本花在每个节点的指针上,换来一步一字符的下降。B+ 树和 LSM 树各占一行,看着像两个选项,实际是同一个问题的两种答案,写的时候要不要顺手把序排好。要,一次写入落到正确的叶子上,读的时候一条路径走到底;不要,先追加进日志,回头再合并,写快了,读的时候得翻好几层。并查集排在最后,它答不了查找,只回答两个点连不连通,路径长什么样、中间经过谁,一概不知道。我第一版把一千万个元素全塞进堆里,跑完才明白它绕了一圈回到全排序,堆白建了,内存也多占一份。
每行都有前提没写进格子。
三次对比,三次都算对了
做法一样:同一份数据、同一个需求,只把承载它的结构换掉,业务代码一行不动。机器是 i9-14900HX,Go 1.27.2,每轮输出都取出来核过才敢比时间。
第一个是缓存淘汰。容量一千,请求按 zipf 分布生成,一共一百万次,命中率跟结构无关,同一个 key 在不在缓存里是确定的。错的那版拿切片存,每次 Get 从头扫到尾;对的那版是哈希表加双向链表,链表管顺序,哈希表管定位。
1 | // 错:切片线性找,每次 Get 扫一遍 |
两百零二纳秒对七点六纳秒,差二十六倍。这组数是十万次纯查找、容量一千、随机 key,两边都先把一千个位置填满——空表里查不到走的是最快路径,第一版我就那么量的,量出来倍数 0。
第二个是前缀检索,十万个词的词表,给一个前缀把以它开头的词全找出来,错的那版遍历整张 map,对的那版先排序再一次二分,2 142 173 纳秒对 541 纳秒,差 3963 倍,找到的词数都是 168。
两毫秒一次,一秒只服务得了几百次。
第三个是 Top 100,一百万个 int32 取最大的前一百,错的那版先用 map 去重再用 sort.Slice 把整份数据排一遍,对的那版只维护一个一百个元素的小顶堆,进一个挤一个。422 037 733 纳秒对 1 481 215 纳秒,差 285 倍,结果都是那 100 条。map 去重那一步在这里是纯浪费,Top K 根本不要求元素互不相同,去重唯一的效果是白扫一遍数据,还多占一份内存。
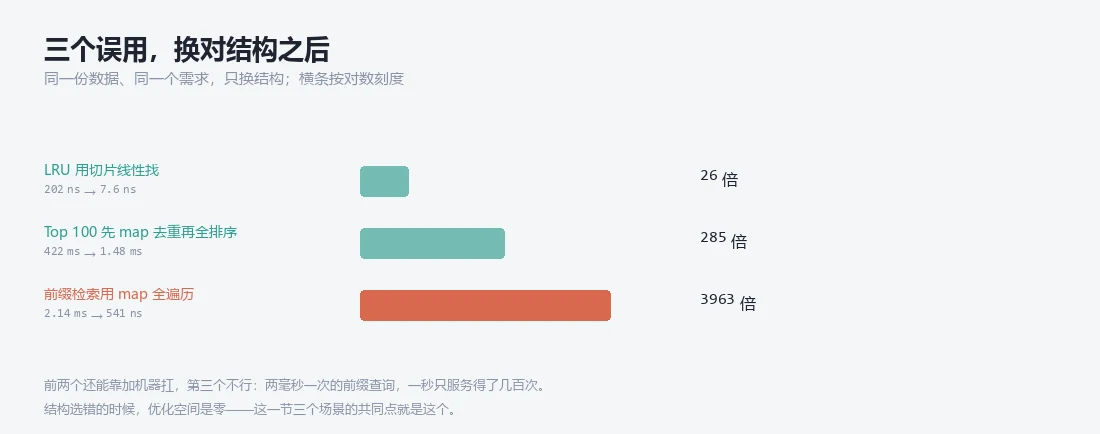
最短的那根,也是二十六倍。
最长的那根反而最先暴露,夹在中间那根最要命。它在一份离线任务里,跑六小时和跑七十秒都叫今天能出结果,没人会盯着它看。
空容器上的 Get 测的不是 LRU
第一个实验的第一版,两边都没预填数据。空切片、空链表,量出来是错的那版 0.3 纳秒,对的那版 1.5 纳秒,倍数 0。
0.3 纳秒比一次函数调用还便宜,我第一反应是编译器把循环优化掉了,翻了汇编,没有;又怀疑计时器精度,换了一种计时方式,还是 0.3。那时候结论已经写了一半,只剩把数字填进去,填的时候自己都觉得那个 0 太整齐,像根本没测。预填一千个 key,数字才变成两百零二和七点六纳秒。
量具歪了,量什么都白搭。
空容器上的 Get 走的是最快那条路径,没有桶、没有比较、没有链表遍历,它测的是查不到有多便宜。这件事跟 LRU 没关系,可它给出的数字比真数字小三个数量级,而且看起来完全合理,因为代码确实跑过,也确实没报错。一个跑得通、不出错、还能重复的实验,照样能给出完全错误的答案。
同样的命中率,不一样的账单
三次实验里最该记住的是另一件事:三边都算对了。LRU 用切片线性找,缓存语义一点没错,该命中的命中,该淘汰的淘汰,861640 一个不差;前缀检索用 map 全遍历,找到的 168 个词连顺序都没乱;Top 100 先 map 去重再全排序,结果就是那 100 条。测试看的是输出,输出是对的。
评审也拦不住,逻辑是对的。它只出现在压测报告和账单上,而这两样通常在结构定下来很久之后才有人翻,翻到了也只是先记一笔,记在某个不常打开的表格里。
慢和错,是两套不同的防线。
202 纳秒乘一百万次是 0.2 秒,一次 2 毫秒的查询乘到每秒几百次就顶到天花板。前者加机器能压住,后者加机器只会让更多请求一起排队。
表外的那一栏
表里没有数据分布这一栏,偏偏它决定了一半的选择。哈希表的装载因子取决于 key 的数量和桶的数量,这个比例只有拿到真实数据才知道;前缀检索走排序切片还是 Trie,取决于词表会不会更新、多久更新一次。
表能指路,数据才定案。
所以这张表不该打印出来贴在显示器边上。它只是一张索引,翻到哪一行还是得自己量,量完自己下结论,答案取决于手里这份数据长什么样。
我的顺序:先问三个问题
我现在拿到一行需求,先问三个问题,顺序不能换。第一,这份数据是按 key 找,还是按范围找,这一问决定哈希和有序结构谁上场,答错后面全错。第二,数据量到哪个量级,装不装得下,要不要落盘,这一问决定内存结构还是磁盘结构,B+ 树、LSM 和排序切片的分岔都在这儿,邻接表还是邻接矩阵那篇算过一笔账,一百万个点的矩阵要 116 GB,装不下的选项根本不在比较范围内。第三,会不会频繁更新,写多还是读多,这一问才轮到堆、跳表、LSM 这些偏门一点的结构。三个问题问完,剩下的候选通常只剩两三个,再拿真实数据量一量就能定下来,剩下的分歧不值得开会。
问题难在答准,不难在答快。
人总愿意相信自己的需求是一串等值查询,直到某个早上产品补了一句要按时间倒序翻页。
真要给个偏向,我会先选最笨的那个结构。切片能解决就不上哈希表,哈希表能解决就不上树,树能解决就不上分布式。笨结构的问题是慢,聪明结构的问题是错得看不出来。
表会过时,判断不会
这张表的每一行都带着我写它那天的机器。数组比链表快,很大一部分是缓存行和预取带来的,换一台缓存很小的机器,链表那几行的劣势就没这么夸张;Trie 输给排序切片,输在指针跳转上,换一种把节点拍平的实现,比分又会变一轮。
我最后悔的一次,是把一次 2 毫秒的前缀查询留在了接口里,理由写在评审记录上:词表只有十万条,遍历一遍能有多慢。这个理由当时听起来很合理,因为它一个数字都没有。
所以这张表能给的全部价值,是让下一次有人问能有多慢的时候,有个地方先翻一眼。翻完还是得自己量,量完还是得自己判断。选型拼到最后,拼的是知道自己不知道什么。