Go 的排序换了三次实现
Go 的排序换了三次实现
隔壁老康难度 ★☆☆☆☆ · 前置:删中间一个元素要挪多少人 | 一句话结论:选排序先看数据会不会重复、比较函数贵不贵,算法名字反而排在最后。
四段基准跑完,终端第一行写着 3.4 ms,是 sort.Ints 排一百万个随机 int 的耗时。我盯着这个数看了两秒,把它连同底下三行一起抄进笔记,还用红笔圈了一下。闭包那版七毫秒出头,算下来慢两倍,正好对上我脑子里的印象:接口和反射贵,能不用就不用。
(那天我还挺高兴,觉得自己终于学会量东西了。)
我是去年六月入的行,到这会儿七个月,写的代码一半跟数据结构打交道,一半跟测试打交道。第一次写基准是八月,为了证明一段 map 遍历比切片慢,结论是对的,过程一塌糊涂:数据建在计时区里,跑五遍取最小值,取到的其实是分配器的脾气。后来写了别猜,量一遍,把那次翻车拆开讲过一遍。我当时以为自己看懂了,其实只记住一句话,计时器要在数据躺好之后按下去。
别的都没记住。
我排的是一百万个零
第二天早上我把这段基准又跑了一遍,想换个随机种子。跑之前顺手点开 cmp_test.go,看见 init() 里那两行:data = make([]int, n),紧接着 copy(data, src)。src 是另一个文件里的包级变量。我第一反应是这行写得挺省事,第二反应才是它可能还没建好。
Go 的 init() 按文件名的字母序执行。cmp_test.go 排在 sort_test.go 前面,拷贝那段 init 先跑,源切片还是 nil,copy 从 nil 里搬了零个元素,data 于是一百万个位置上全是零,一个字节都没动过。基准跑得很认真,计时器按得也对,-count=3 老老实实跑了三轮,每一轮排的都是同一批零。更难受的是它给的结论看起来特别合理:3.4 ms,比闭包快两倍,跟我心里预设的方向一模一样。一个合我心意的数字,比一个离谱的数字危险得多,因为后者我还会回头看一遍。
零个元素被搬过来。
后面这一截是我过了一晚上才想明白的。pdqsort 碰到全等值的输入有一条专门的快路,zsortfunc.go 第 108 行:if a > 0 && !data.Less(a-1, pivot)。上一个 pivot 左边那个元素都不比它小,说明这一段很可能全是重复值,于是改用 partitionEqual_func,把等于 pivot 的一整段一次切出去。切完小的全在左边、大的全在右边、等于的那一整段原地不动,递归只剩一边,宽度直接砍掉一大块。一百万个零就是这么几毫秒排完的,连 limit 的门槛都没碰到。我原先以为快排的常数只跟实现写得好不好有关,这件事让我明白常数跟输入的形状绑得更紧。
数字本身也印证这件事。同样一百万个 int,只有一百个不同值的时候是 63.7 ms,已经比随机的 186.2 ms 快出将近三倍。
全等值比这还极端。
我把数据改到 sync.Once 里懒建,第一次调用时才填,跟文件执行顺序彻底脱钩。重跑,sort.Ints 180.6 ms,sort.Slice 276.9 ms,1.6 倍。
基准测试最贵的一次错误不是量错,是量的东西根本不是你以为的那个。我把它抄在了显示器边上。
同一批数据,四种写法
改完之后重跑的那一版,一百万个随机 int,-count=3,机器是 i9-14900HX,32 个逻辑核,Go 1.27.2 windows/amd64。数据建一次、排十遍,谁也不许碰包级变量:
1 | var ( |
四次调用的结果摆在一起是这样:
| 写法 | 三次 | 相对 sort.Ints |
每次分配 |
|---|---|---|---|
sort.Ints |
180.6 / 188.5 / 180.7 ms | 1.00× | 0 次 |
slices.Sort |
181.9 / 198.4 / 196.3 ms | 1.01× | 0 次 |
sort.Slice + 闭包 |
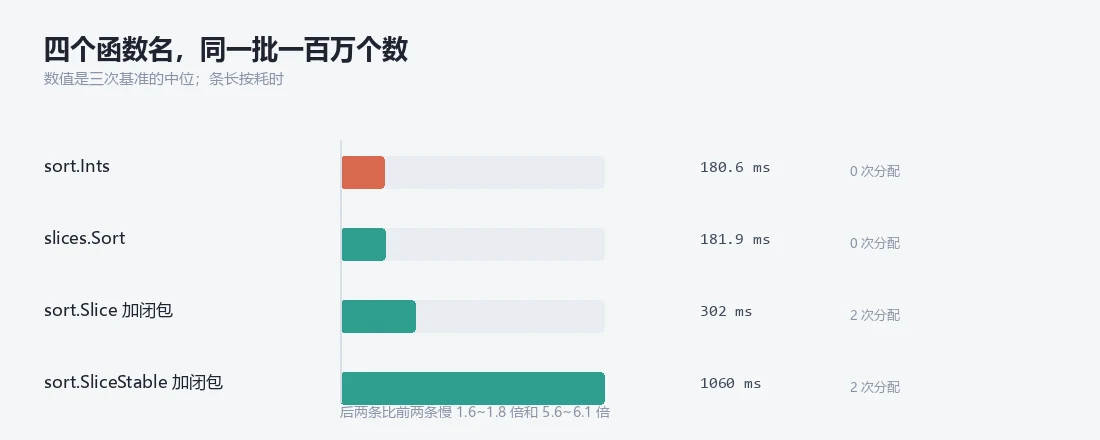
276.9 ~ 328.1 ms | 1.6 ~ 1.8× | 2 次,56 B |
sort.SliceStable + 闭包 |
1011 ~ 1110 ms | 5.6 ~ 6.1× | 2 次,56 B |
第一行和第二行其实是同一个函数。sort.Ints 在 GOROOT 里只有一行,sort.go 第 170 行:func Ints(x []int) { slices.Sort(x) }。180.6 和 181.9 中间那 1.3 毫秒不用解释,slices.Sort 那三次是 181.9、198.4、196.3,同一台机器、同一段代码、同一个二进制,抖动量级就有这么大。这也是我后来非坚持 -count=3 不可的原因,单跑一次太容易把噪声当结论。
真正要解释的是下面两行。
sort.Slice 1.6 到 1.8 倍,sort.SliceStable 5.6 到 6.1 倍,两个都多两次分配、共 56 字节。56 字节这个数看着扎眼,可它跟元素个数无关,排一百万个元素也是这两次。一次分配的价钱在百纳秒量级,两次加起来塞不进 96 毫秒的差距里。
钱不在分配上。
一百万个 int 排一遍大约两千万次比较,1e6 乘 log2(1e6),这个数是算出来的。sort.Slice 比 sort.Ints 多出来的那 96 毫秒,摊到每次比较上是四五纳秒。四五纳秒差不多正是一次不能内联的函数调用的价钱。1.6 倍的全部来源就在这儿。
四五纳秒,也就这么多。
一次比较要多绕两圈
sort.Slice 的签名是 less func(i, j int) bool,你传进去的闭包在编译期只是一个函数值,调用点上看得见指针,看不见函数体,内联断在这儿。更贵的是换位:它先调 reflectlite.Swapper(x),拿到一个 func(i, j int),内部按类型分支决定这一次要挪几个字节、怎么挪。排序里换位的次数跟比较是同一个量级,两千万次比较配几百万次换位,每一次都得走一遍这个分支。这两笔加起来,才是我当初想当然的接口和反射贵的真实位置,贵在每一次调用,不在建对象那一次。
比较一次,换位一次。
slices.Sort 那边不是这样。pdqsortOrdered 是对 []E 的泛型实例化,E 在编译期就定下来了,比较那行是个 <,换位就是两次赋值,元素大小和下标乘法都是常量。两边的算法一模一样,连 12 这个门槛都一样,差的全在每一趟比较和每一次换位上。
所以稳定版那 5.6 到 6.1 倍,也不能全记在闭包头上。SliceStable 走的是另一条路,stable_func,先把每 20 个元素插排一遍,再两两归并,归并十几轮。它一分额外内存都没花,这一点跟我原先的猜测相反,我以为稳定版总得开一块临时数组。
排好的数据比随机的快八十倍
第二组只动输入,不动调用方式,全部是 sort.Ints,一百万个 int。
| 输入 | 中位耗时 |
|---|---|
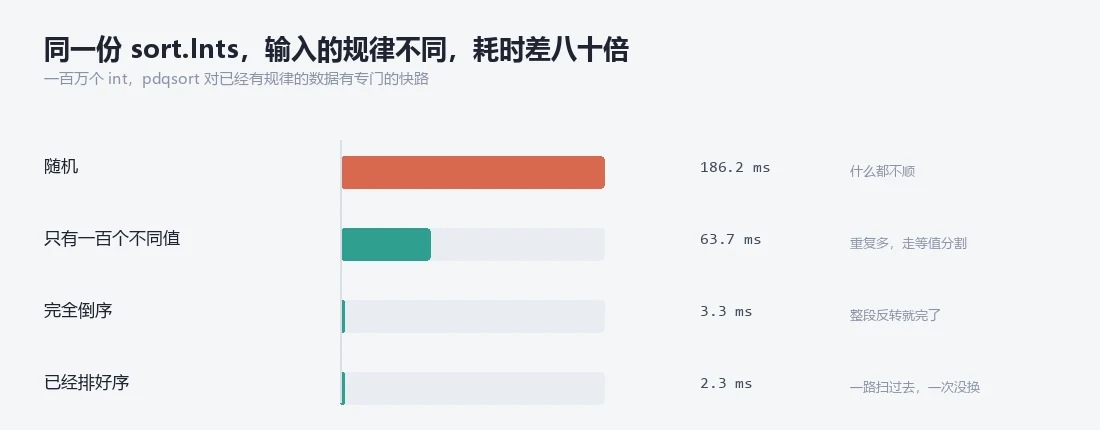
| 一百万个随机 int | 186.2 ms |
| 已经排好序 | 2.3 ms |
| 完全倒序 | 3.3 ms |
| 只有一百个不同值 | 63.7 ms |
第一行是基准,186.2 ms。第二行 2.3 ms,输入本来就有序,partialInsertionSort_func 从头扫一遍,没有一对相邻元素是逆序的,直接 return true,整趟结束。它的 maxSteps 是 5,最多修五次,shortestShifting 是 50,长度短于 50 个元素连修都懒得修。这套东西只对基本有序的段有效,一百万个零那种全等值轮不到它,因为段早被 partitionEqual 切没了。八十倍这个数我第一次看到时以为是跑错了,重跑三次都是两毫秒出头。
扫一遍就完事。
第三行更别扭,完全倒序只要 3.3 ms。choosePivot_func 挑 pivot 的时候顺手数了一下比较里发生了多少次交换,全都得换,就说明这一段是严格递减的,返回 decreasingHint。拿到这个信号,pdqsort_func 直接 reverseRange_func 把整段反过来,再把 pivot 的下标换算成反转之后的位置,接着按升序往下走。反转一百万个 int 是五十万次交换,排好的那次是 2.3 ms,比它多出来的 1 毫秒大概就是这五十万次交换的价钱。倒序比随机快五十多倍,这条规律在教材里几乎没人写。
输入的样子,比调用方式值钱。
这几行放在一起,能看出 pdqsort 的设计取向。它不假设输入是随机的。 教科书写快排总要补一句平均 O(n log n),平均是对随机输入取的,而工程里的数据大多不随机。从库里按主键捞出来的是有序的,从上游有序结果拼出来的还是有序的,倒序更是常见,按时间倒着取回来再塞进要正序显示的地方,这种代码每个项目里都有几处。既然输入不随机,把判断做进算法里就比要求调用方先排序划算得多。
不随机才是常态。
十二个元素以下直接插入排序
主干在这儿,摘自 $(go env GOROOT)/src/sort/zsortfunc.go 第 61 行起,删掉了两路递归那几行。
1 | func pdqsort_func(data lessSwap, a, b, limit int) { |
maxInsertion = 12 是这段代码里第一个常数。递归到长度 12 以下,直接交给 insertionSort_func 然后 return,不再选 pivot、不再分割、不再压栈。理由不复杂:一段十几个元素的区间上,选 pivot 要比较三四次,分割要扫一遍再换几次位,递归还要存返回地址,这些固定开销加起来已经超过把十几个元素插排一遍。插排本身在短区间上也不丢人。内层是相邻比较,比到不该挪的就停,最坏 O(k²),k 最大 12,一百多次封顶。快排递归下去每层都要扫一遍自己那一段,一层一层摊下来,短区间上每层的固定开销比有效工作还多。
这条线划在 12。
五百个元素那次是 66 到 68 微秒,摊到每个元素 0.13 微秒,一百万个那次是 0.18 微秒。五百个 int 是 4000 字节,整个数组装得进一级缓存,递归到最后一层全是十几个元素的小段,插排在这些小段上几乎是线性的。
坏分割用完,退回堆排序
第二个常数不在函数里,是调用方传进来的。slices.Sort 传的是 bits.Len(uint(n)),一百万个元素就是 20。每做一次明显不平衡的分割,limit 减一,减到 0 就调 heapSort_func 把整段排完。这一条不是优化,是保证:快排最坏能退到 O(n²),堆排序最坏 O(n log n),闸门一关,最坏情况就被钉在那儿了,代价只是这类输入上慢一些,不会慢到没法收场。工程里能接受的往往不是最快,而是有个像样的上限。
二十次机会,用完换人。
第三个优化管的是输入里的规律。上一次分割如果不平衡,wasBalanced 就是 false,下一轮开头先跑 breakPatterns_func。它干的事很朴素:长度够 8 的话,用 xorshift 取一个伪随机数,把区间中间那三个位置挨个跟随机位置换一下。只动三个,不多不少,目的是打散那些会让 pivot 每次都挑到最边上的排列。
三个优化各自管一段输入:12 以下省递归的固定开销,breakPatterns 和 partialInsertionSort 管有规律或基本有序的输入,limit 管最坏情况。少任何一个,另外两个的效果都要打折。我一开始以为这是三份独立的补丁,后来才看出来它们在补同一件事:快排默认输入是随机的那个假设。
主干这些年换过三次。最初是朴素快排,中间那版是 introsort 那一路,小切片交给 shell sort,Go 1.19 起换成 pdqsort,改动记在 golang/go#50154。pdqsort 的思路来自 Orson Peters 的论文,arxiv 2106.05123,C++ 实现是 orlp/pdqsort。Go 这一版没有照搬论文里的全部内容,zsortfunc.go 第 56 行的注释写得很直白:without the optimizations from BlockQuicksort。我第一次读这句还以为看错了,翻回论文才发现那部分确实被整段拿掉。
(写这段之前我又打开那个文件看了一眼,行号还停在原处。)
稳定的价格是十二倍
第三组换数据形态,三十万条记录,每条一个 key 加几个字段,按 key 排。
| 写法 | 中位耗时 | 相对不稳定 |
|---|---|---|
sort.Slice |
72.8 ms | 1.00× |
sort.SliceStable |
864.2 ms | 11.87× |
11.87 倍,这个差距跟比较函数没关系,两边传的都是闭包,同一个 less,唯一的区别是 Slice 和 SliceStable。多出来的八百毫秒全是算法本身的账:归并每一轮都要把元素搬来搬去,symMerge 每次合并前得先二分找位置,搬动次数比快排多一个量级。
稳定性到底改了什么,计时说不清楚,计数能说清楚。二十条记录,只有三个不同的 key,排之前给每条记下原始下标,排完扫一遍,同一个 key 的两条如果下标大的跑到了前面,就计一个逆序对。逆序对是定义,跟机器、跟缓存、跟 GC 都没有关系,9 和 0 之间没有噪声。
1 | type rec struct { |
sort.Slice 排出来 9 个,sort.SliceStable 是 0 个。
九个对零个。
业务上稳定常常不是性能选项,是语义要求。同一个用户的两条订单时间一样,先提交的那条该排在前面;分页查询里两条记录的排序键相等,稳不稳定决定了翻到第二页会不会又看见第一条。这类要求写不进比较函数,只能靠算法保证,所以真到这一步,11.87 倍是必须付的。付之前还是值得问一句有没有更便宜的走法。稳定排序要的是相等元素保持原序,把原始下标塞进比较函数当第二关键字,不稳定的排序也能给出同样的结果,key 相等就比下标,小的在前。代价只落在相等的那一对上,多一次比较。这条改法我这篇没量,不敢给数。
(十二倍这个数我一直记着,比 864 毫秒好记。)
三个问题,顺序不能换
顺序反过来了。以前先想用哪个函数,现在先问三个问题。第一个,这批数据里会不会出现相等的键,相等的时候业务有没有要求保持原序,有要求就得上稳定,没要求就别付那十二倍。第二个,比较函数有多贵:能拿到 []int、[]string 这种有序类型的,slices.Sort 一行解决;结构体按字段排,slices.SortFunc,泛型实例化,没有 reflect.Swapper 那层;只有排 []any 或者迁就老接口的时候才轮到 sort.Slice。
第三个,数据从哪儿来。从库里按主键捞的、从上游有序结果拼的、倒序拿回来又要正序用的,这些都不用作任何预处理,pdqsort 自己认得出。代码里要是已经写了 sort.SliceIsSorted 先判一遍再决定排不排,那次扫描是白送的:slices.Sort 进去第一趟干的就是这件事,判完发现有序直接返回,一分钱不多花。
先问稳定,再问比较函数的价钱,最后才轮到算法名字。(那本笔记后来被我翻得起了毛边。)
那个写错的基准我还留着,sort_test.go,sync.Once 没删,数据懒建。每次跑之前先 -count=3,跑完盯着第一行,确认它不是三毫秒。