别猜,量一遍
别猜,量一遍
隔壁老康难度 ★☆☆☆☆ · 前置:数组到底快在哪 | 一句话结论:同一个求和函数,计时范围不同能差 5.5 倍,波动能差 8 倍,量之前得先把量法定死。
同一条命令,两次差了一倍
我在自己机器上试一个求和函数,两百万个 int64,range 从头到尾加一遍,十来行代码,本来只打算花二十分钟,结果第一遍跑出来 1.6 ms,第二遍 8.9 ms,第三遍又回到 4.5 ms,同一条命令,同一个二进制文件,中间只隔了几十秒,我先是怀疑风扇转速,接着怀疑电源管理,把任务管理器开到前台又跑一遍,落在 6.2 ms,三个怀疑一起不成立了,最后剩下一个更难看的可能,我压根不知道自己在测什么,也不知道入职这四个月笔记里抄下来的那些毫秒数,到底有几个是真的。
机器插着电,浏览器也关了。
那天晚上我把同一个 sum() 写了四遍,函数体一个字没改,改的只有计时从哪儿开始、到哪儿结束,每遍跑五轮,跑完把数字抄进表里,抄的时候手有点抖,因为第二遍跑完我就知道,前面那些数有一大半要作废。
环境是这台笔记本,windows/amd64,GOMAXPROCS=32。同一台机器重跑,数字应该落在同一个量级,换台机器绝对值会变,比值不会。
数字在这儿。
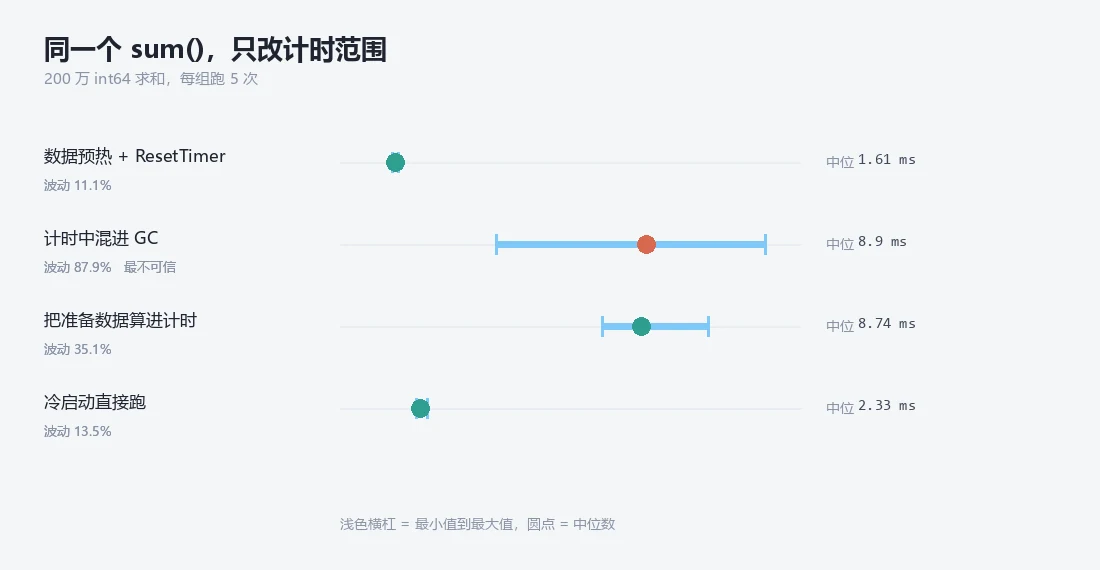
| 量法 | 中位 | min | max | 波动 | 相对干净版 |
|---|---|---|---|---|---|
| 冷启动直接跑 | 2.33 ms | 2.23 | 2.55 | 13.5% | 1.45× |
| 计时中间混进 GC | 8.90 ms | 4.54 | 12.36 | 87.9% | 5.51× |
| 把准备数据算进计时 | 8.74 ms | 7.62 | 10.68 | 35.1% | 5.41× |
数据预热好、b.ResetTimer() 后计时 |
1.61 ms | 1.53 | 1.71 | 11.1% | 1.00× |
波动那一列我按 (max - min) / 中位 算,第二行 (12.36 - 4.54) / 8.90 是 87.9%,拿计算器复核一遍,另外三行也全对得上。
同一个函数,最慢那版比最快那版慢 5.5 倍。
5.5 倍里没有一行代码在算加法以外的事,差别全在计时器什么时候按下、什么时候松开。
波动那一列比中位数值钱
先说第二行。8.90 ms 这个中位数,看着像是我写的求和比谁家的都慢五倍,可它五轮里的最大值 12.36 ms 是最小值 4.54 ms 的 2.7 倍,最好的一轮和最坏的一轮之间隔了差不多 7.8 毫秒,中间没换数组、没改长度、连内存地址都没挪过。
这种数字拿去跟别人比,比出来的全是噪声。
我一开始的判词是这循环不稳。不稳这个说法很诱人,因为它不用改任何东西,把锅甩给硬件、甩给 GC、甩给 Windows 的调度,听着都成立,可 sum() 里只有一次 range、一次加法、一个 int64 累加变量,数组长度是编译期就知道的常量,它没有任何可以不稳的地方,一个连分支都没有的循环,凭什么一轮 4.5 ms、一轮 12.4 ms,差出两倍多。
答案在计时窗口外面。
WithGCNoise 那版每一轮都新开 2000 个 4 KB 的 []byte,也就是每轮 8 MB 垃圾,GC 什么时候来,取决于上一轮攒了多少、堆涨到了哪儿,不取决于我想让它在哪儿,有一轮它正好在计时区间里跑完,那一轮记下 12.36 ms,有一轮它一次都没进来,那一轮 4.54 ms,两轮跑的是同一段循环。
所以波动那一列大,读法得反过来。
它不是被测对象不稳,是量法在测别的东西。最小那一轮也不干净。4.54 ms 比干净版的 1.61 ms 还慢 2.8 倍,那 2000 次分配本身就要花钱,GC 一次没来,分配照付,最小值在这里只是脏得最少,说它干净就过了。
波动是量法的体温计,不是被测对象的体检报告。
计时器按下的那一秒
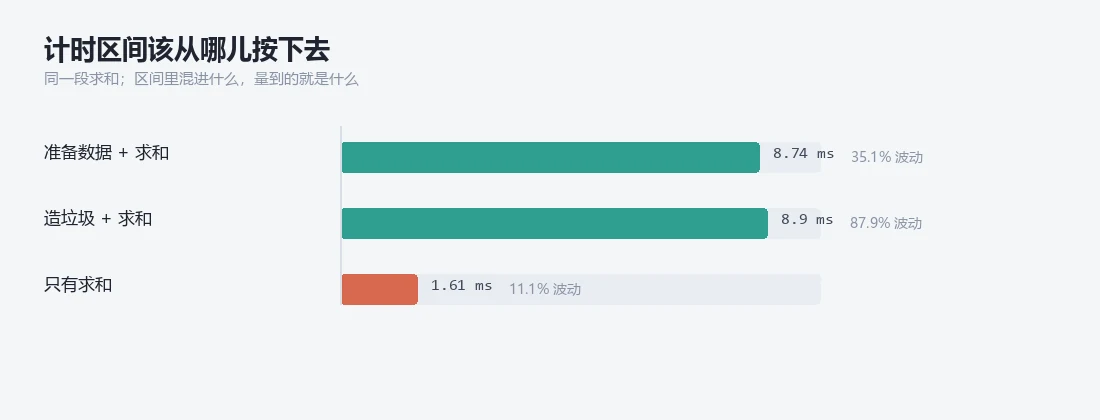
第三行是把准备数据算进了计时,那版每一轮都重新 make([]int64, 2000000),再把两百万个数填一遍,填完才求和,跑出来 8.74 ms,5.41 倍,跟混进 GC 那版的 8.90 ms 几乎撞在一起。
两件完全不同的错事落到同一个数字上,比两个数字都错还坑人,它让你以为自己抓住了一个稳定的结论,其实只是两种不同的脏东西在互相掩护。
求和本身一个字没改。
变的是一轮里除了求和,还顺带建了一块 16 MB 的内存、写了两百万次、再把它丢给回收器,准备数据是准备工作,被测的只有求和这一段。
计时器要在数据躺好、缓存热了、堆也稳了之后再按下去。
1 | var data = make([]int64, benchN) // init() 里填好,不进计时区间 |
b.ResetTimer() 干的事比名字多一点,它把已用的时间清零,顺手把内存分配计数也清零,这一点后面讲 -benchmem 时还会撞见。
反过来说,要是你的准备工作根本挪不出计时区间,比如被测函数必须吃一块每轮现建的数据,那就别硬凑,用 b.StopTimer() 和 b.StartTimer() 把准备那段夹出来也行,可夹子本身有成本,一轮几十纳秒,被测对象到了纳秒级,夹子比被测的东西还贵,那就干脆承认这一版量的是建数据加求和,在正文里写明白,别让读者替你猜。
别让 GC 挑自己进屋的时间
第二行的病根跟 GC 快不快没关系,问题在它挑了个我不认识的时间点出现。Go 的 GC 是并发的,标记和清扫跟你的代码同时跑,什么时候触发跟上一次 GC 之后堆涨了多少有关,基准里每一轮都造 8 MB 垃圾,堆涨得飞快,GC 自然来得勤,它来的时候,你的循环就得跟它抢 CPU、抢内存带宽,抢输了就多出几毫秒,而这多出来的几毫秒,会被记到求和的账上。
办法不是去调 GOGC。调它只会把 GC 往后推,推到哪一轮你更不知道。
办法是别在计时区间里造垃圾。你要量的是求和,不是分配器。
跑之前手动 runtime.GC() 一次能让起点整齐一点,可它治不了区间内新产生的垃圾,所以只是个配角。真需要量分配,就拆成两个基准,一个只量求和、零分配,另一个专门量分配,b.ReportAllocs() 打开,让它脏,脏得明明白白,两个数分开放,别混成一格。
2000 次分配是那条线索
上面这些,光看时间列看不出来。同一张表里还有两列,我第一次跑的时候压根没开,是后来被人问了句你怎么不报分配才补上的。
-benchmem 加在命令后面,输出从两列变四列,把时间列裁掉,只留后两列,我那四轮的原样是这样的:
1 | BenchmarkClean-32 0 B/op 0 allocs/op |
三行并排,谁在计时区间里干了什么,一眼就看出来了。
干净版 0 B/op、0 allocs/op,这是它干净的自证,说明区间里一次分配都没有,准备数据那版每轮 16007168 B/op,差不多 16 MB,正好是两百万个 int64 的账,分配次数只有 1 次,因为 make 一次就要一整块,GC 噪声那版 2000 allocs/op、8192000 B/op,8 MB,摊成两千块 4 KB。
2000 这个数就是线索。
你要测的函数一次分配都没有,-benchmem 却报了两千次,那这两千次是你圈进来的,不在被测范围内。
时间和分配数得一起看,原因也在这儿,只看时间,8.90 ms 和 8.74 ms 长得一模一样,你分不清那是 GC 还是准备数据,加上分配数,一个是 2000 次小分配,一个是 1 次 16 MB 大分配,两种病立刻分开。
-count=5 是下限,不是讲究
我第一遍只跑了一次,就那个 1.6 ms。单次数字的毛病不在准不准,在于它不带误差条,你没法知道它离真值多远。
-count=5 是我现在的最小配置,五轮里取中位数,同时把 min 和 max 一起写上。
四条一起跑的命令是这样的,go test -run XXX -bench 'ColdOneShot|WithGCNoise|IncludesSetup|Clean' -count=5 -benchmem,前面那个 -run XXX 是让单元测试一个都别跑,只留基准,四条乘五轮一共二十次,我这台机器上从头到尾 416 秒,差不多七分钟。七分钟里我把浏览器关了,编辑器也关到只剩一个窗口,因为这两样东西平时都在后台偷偷吃一点 CPU,吃的那一点平时看不出来,落到基准的某一轮上就是几十微秒,落到最后那一轮上就可能把最大值抬高一大截,而最大值一抬,波动那一列就跟着变,你从表里读出来的结论也要跟着变,可你回头去改的往往是 sum() 里那行加法,它压根不在病因上。这一个我暂时没法证明,只能说是我的担心,所以我现在的做法是让机器在跑之前空几分钟,别的什么都不开,宁可慢一点。
为什么不用平均值。平均值会被那轮 12.36 ms 拽走一截,中位数只回答典型的一轮是多少,两个数一起看更有意思,中位数告诉你典型值,min 到 max 的跨度告诉你这个典型值有多可信。
那为什么不挑最好那一轮。
挑 min 的人觉得自己在排除干扰,其实是在排除证据,跑五轮挑最小的当结论,跟跑一轮没区别,只是多花了四倍时间。
benchstat 是官方那个小工具,go install golang.org/x/perf/cmd/benchstat@latest 装上,默认落在 $(go env GOPATH)/bin,我这台机器的 GOBIN 被改过,装完跑到别处去了,go env GOBIN 查一下就知道在哪儿,PATH 里没有就直接写全路径。
把两次 -count=5 的输出各存一个文件,benchstat old.txt new.txt,它给你一张带增减的表,sec/op、B/op、allocs/op 三块,每块都带百分比。
我那份五轮的输出丢进去,它顶了一行提示,说需要至少六个样本才能算 0.95 的置信区间。五轮刚够看波动,不够算区间。
装不上也不影响,把两列 -count=5 的原始输出并排贴在编辑器里,一列五行,哪列数字排得整齐、哪列上蹿下跳,肉眼看得出来,benchstat 是把这件事算得更细,不是替你做这件事。
跑不出稳定结论就写没跑出
第一行那个冷启动,13.5% 的波动比我预想的小。
原因不神秘,在你看到的那一轮之前,go test 自己已经先跑过几轮了,基准框架从 b.N = 1 开始往上翻倍,等你看见屏幕上那行输出,热身早就做完,所以冷启动这三个字,在默认参数下基本是假的。
真要测冷启动,-benchtime=1x 让它每轮只跑一次,还得每轮重启进程。我照这个办法起了两个进程,两轮之间的差比 -count=5 那五轮的差还大。
冷启动比干净版慢 45%,这个 45% 我一直没拆干净,数据第一次进缓存、分支预测还没热身、刚起来的进程页还没落全,三样都可能占一份,我没法把它们分开量,所以这里只写冷启动那版比干净版慢 45%,不写为什么,写不出来就是写不出来。
跑不出稳定结论,就写没跑出稳定结论。
不写大约、基本上、差不多,也不挑一个好看的数交差,挑数字这件事有一次就有第二次,挑到后来,你自己都分不清哪些数是量的、哪些数是凑的。
这套规矩我后面一直用
这篇文章没有一个数字是新的。两百万个 int64、同一个 sum()、四行表,全在我自己机器上跑,代码在 _local/ds-exp/d0/measure_test.go,你拿过去改个路径就能重跑,跑出来的绝对值大概跟我对不上,倍数应该能对上。
它值钱的地方不在数字,在口径。
往后每一篇正文里的毫秒数,都按这四条来,计时区间先掐干净、准备数据留在外面,GC 挡在区间外、挡不住就拆开量,-count 至少 5、中位数和 min 到 max 一起给,跑不稳就写跑不稳。
往后看见一张带 min 和 max 的基准表,那套规矩就是从这里发出去的。
反过来,看见只贴一个中位数、不给波动的表,那是我漏了,说一声我回去补跑。
表里三列一起给,看着啰嗦。
等哪天换了台机器,绝对值全变、比值还在,你就知道那三列是干什么用的。
量之前先把量法定死。定完再按下去,别一边跑一边改参数,那种数据谁也救不回来。我这四篇里的每一个毫秒数,都是先按这四条定完,再动手跑的。