十亿个数里取前一百
十亿个数里取前一百
隔壁老康难度 ★★★☆☆ · 前置:堆为什么只排一半序就够了 | 一句话结论:取 Top K 不需要全排序,小顶堆只花 K 个元素的内存,一千万个数据里取前一百,比全排序快 265 倍。
需求单上只有一行字:导出上季度订单里金额最大的前一百条,带订单号、金额和下单时间。表里九百多万行,金额那一列没建索引,DBA 不肯让这条查询在生产库上跑全表排序,数据只能先捞进内存,用 Go 处理。我拿到的是个两列的文件,订单号一列、金额一列,读进内存就是一千万个 int32 外加一张 ID 对照表。数据不大,随便一台机器都放得下,麻烦的地方只有一处:怎么从这一堆里挑出一百个,还不让人觉得费劲。
第一版三行就写完了。
sort.Slice 从头排到尾,切前一百。跑通了,结果也对,评审的时候没人说话,在九百万行这个量级上,那点耗时肉眼根本看不出来。
可它一直在我脑子里挂着。
我把数据放大到一千万条 int32,用 math/rand 固定种子 42,K 取 100,在同一台机器上把三种写法并排跑了一遍,每种跑完都把输出取出来核一次。条件定死之后,同一份数据可以反复喂给不同的实现,谁快谁慢不用凭感觉,也不用回头怀疑是不是哪里写歪了。种子写 42 只是习惯,随机数在这个实验里唯一的职责是保证三份输入完全一致。
取最大的前一百,堆顶放最小的
堆这种东西,我原先的直觉是对着来的:要最大的 K 个,那就建大顶堆,堆顶是最大的,弹 K 次不就是前 K 大。
弹 K 次确实能拿到排好序的前 K 个。
可它要求先把一千万个数全塞进堆里,建一个一千万大小的堆,时间和内存都跟全排序同一档,省下来的只有收尾那点比较。用它等于绕一圈回到原地。
小顶堆的用法是另一回事。堆里从头到尾只放 K 个元素,堆顶是这 K 个里最小的那个。它不记谁是第一,只回答一个问题:现在这一百个里,谁最该被换掉。
取最大的一百个,守门的偏偏是最小的那一个。
新元素来了先跟堆顶比。比它小或者一样大,直接扔掉,这一次比较就是它全部的代价。比它大,它把堆顶挤下去,自己坐上去,再往下沉,沉到比两个孩子都小为止,七层树高最多七次交换。
1 | func topK(data []int32, k int) []int32 { |
push 和 pop 就是上浮下沉那两段,上一篇里写过,这里只留主干。容量开到 K+1,是因为先 push 再 pop,长度会短暂地到 K+1,多留一格正好省掉那一次扩容拷贝。
一千万个元素,九百九十九万多次循环里只有两件事:读一个 int32,跟 h[0] 比一下。
注释里那句“绝大多数元素走到这儿”不是修辞。
这条不变量容易被当成废话,可它是整个写法能站住的地方。堆塞满的那一刻,里面就是前一百个见过的数,堆顶是这一百个里最小的,也就是当下的第一百名。之后每来一个新数只有两种结果:没赢过第一百名,它一定进不了前一百,扔掉。赢了,原来的第一百名被顶掉,新数进堆,堆顶换成新的第一百名。所以堆顶那个位置一直在替我们筛人,它筛掉的每一个数都不可能出现在答案里,一次比较就完成判决,不需要看数组其余的部分,也不需要在别处记什么账。这跟全排序的处境差得远:排序要确定每一个数该站哪儿,而这里面九百九十九万九千九百个数,我们压根不在乎它们谁大谁小。
判决一次就够了。
三种写法,一秒钟和四毫秒
| 写法 | 一千万条 int32,K = 100 |
|---|---|
sort.Slice 全排 |
1093.9 ms |
小顶堆,手写 []int32 |
4.118 ms |
| quickselect,Lomuto 分区 | 21.15 ms |
三个数摆在一起是 1093.9 毫秒、4.118 毫秒、21.15 毫秒,全排序被甩开 265.7 倍,quickselect 被甩开 51.7 倍。三份输出各自排序之后逐元素比对,结果是 true,一个数都没差。
265 倍这个数,第一次看见会怀疑自己哪里写错了,何况堆那一版比库函数还短。
我核了三遍,核的是输出不是速度:各自取出一百个,按升序排好,从第 0 个比到第 99 个,全等。速度上确实有抖动,可 4 毫秒和 1093 毫秒之间隔着两个数量级,抖动量级再大也填不满这个缝。
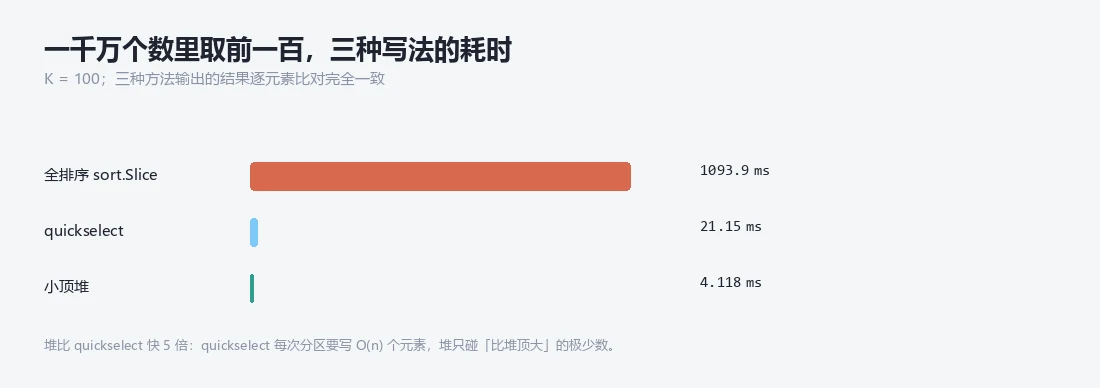
一千万个数里取前一百,三种写法的耗时。
真正需要解释的是中间那一行。
快五倍的地方不在复杂度里
按复杂度表,quickselect 该赢。它平均 O(n),一千万个元素扫两遍就够。小顶堆是 O(n log K),每个进堆的元素还得在七层树高里沉一遍。低一档的输给高一档的,还输了五倍,这个反直觉的地方值得掰开看。
先说 quickselect 在干什么。Lomuto 分区从左往右扫,碰上比 pivot 小的就跟慢指针位置换一下,扫完 pivot 落到最终位置,左边全比它小。第一趟就要扫一千万次,其中大约一半要换位,五百万次交换,每次写两个下标,下标散在整段数组里,前后不挨着,每一下几乎都踩在一个新的缓存行上。分完只往含第 100 名的那一侧递归,区间减半,再扫五百万次、再换两百多万次,一路缩下去,总扫描量是 n 的两倍多一点。这些写全是随机访问,五百万次下来,缓存留不住什么。
小顶堆不是这个形状。它从头到尾顺序读一遍,一个元素一次比较,读的位置连续,CPU 预取器最擅长的就是这种访问。进堆的元素少得可怜,随机数据下的期望次数是 K 乘 ln(n/K),一百乘 ln(十万),大约一千一百多次。这一千多次下沉全发生在容量 101 的切片里,四百来个字节,一直在 L1 里躺着。所以那 4.118 毫秒里,绝大部分时间是在把数据从内存搬进寄存器,不是堆里折腾。一千万条除以 4.118 毫秒,每秒二十四亿个元素上下,这个吞吐跟单核顺序读内存是一档。
顺序读一遍,就这么贵。
把两种写法的动作拆成几个量来看,差别一目了然:quickselect 在整段数组上随机写五百万次、递归四趟,每一趟都重扫。堆只有一千多次下沉,写的地方固定在四百字节以内,其余九百九十九万个元素各挨一次比较就走了。前者的常数项挂在数组长度上,后者的常数项挂在树高上,而这个树高只跟 K 有关,跟 n 一点关系都没有。n 从一千万涨到十亿,堆那边多出来的活只是把这十亿个元素各读一遍,quickselect 那边每一趟分区也跟着变长,两边的差距只会拉大,不会缩小。
常数项,不是复杂度。K 越小,进堆的元素越少,堆越占优。反过来,K 越大,进堆的元素越多,堆就越往全排序那边退,退到某个位置两边换手,换过去之后堆就只剩内存这一条优势了。
堆省下来的是内存
全量摊在内存里,一百万条 int32 是 4 000 000 字节,3.8 MB;只留一百条的堆是 400 字节,0.4 KB。
前者是后者的一万倍。
这个差距跟算法无关,只跟要不要留全量有关。全排序必须先把所有数据装下来,每一趟分区都在整段数组上换位,数据不在内存里它没法工作。quickselect 也一样,它要按下标随机访问整个数组,两头的元素随时可能被交换,一处读不到就断在那儿。
小顶堆不留全量。
它只要 K 个位置,来过的元素处理完就走,不回头。
四百字节的堆一直待在 L1 里,这既是省内存的那部分,也是它快的那部分,两件事其实是同一件事。
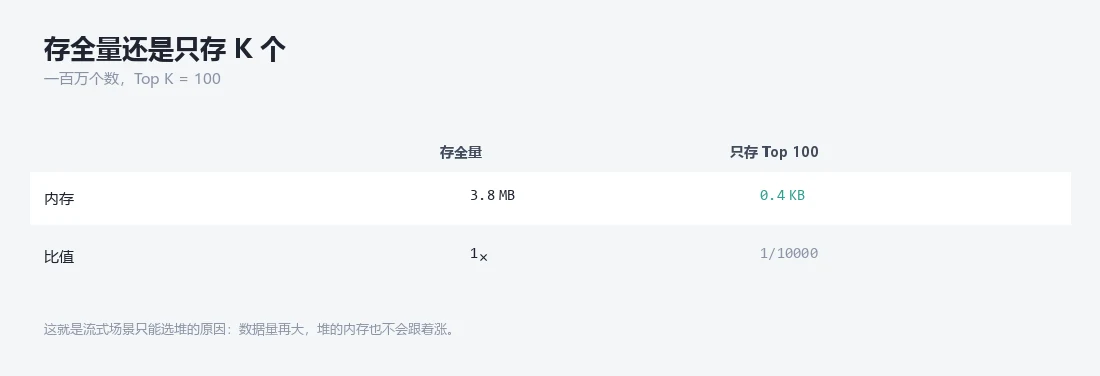
存全量还是只存 K 个,内存差一万倍。
堆赢的理由不止一个,可要只留一个,我留这条:它从没打算把数据全看一遍。
K 涨到 n 的一半,账就反过来了
K 是个可以调的参数,结论跟着它走。判断标准只有一条:算 K 乘 log2(K),再跟 n 比。堆要付的搬运量是元素个数乘树高,全排序是一千万乘二十三,两边差着数量级的时候选堆,差不开的时候选排序。
极端的例子是一千万取前五百万。树深从七层涨到二十二层,五百万个元素每人沉一遍,一亿一千万次换位,跟全排序两亿三千万次比较省不了多少,还要多付一次弹出,内存上也占不到便宜,堆里得留五百万个位置。这种 K 直接排。把两头的账摊开看会更清楚:全排序那两亿三千万次比较代价是稳定的,跟 K 无关。堆那边是 n 次比较加 K 乘 log2(K) 次下沉,K 从一百涨到五百万,第二项涨了五万倍,从可以忽略变成跟第一项同一档,比价就从 265 倍一路收敛到 1 附近,收敛速度取决于 log2(K) 走得多快。K 不到一万时 log2(K) 还压不到十四,堆明显赚。K 上了百万,log2(K) 过二十,下沉的账就跟全排序咬在一起了。
具体在哪个点换手,我给不出准确位置。它跟元素多大、缓存多大、比较函数贵不贵都有关系,我手上也只测了 K 等于 100 这一个点,再往上没跑过。能给的只有那条判据:K 乘树高远小于 n,堆赚。两个数接近了,回去老实排序。
数据装不下的时候没有第二个选项
前面那些比较都建立在一个前提上:数据已经躺在内存里。真到了十亿条,这个前提本身就不成立,一千万条能进内存,十亿条不行,那个量级的数据在磁盘上、在 Kafka 的 topic 里、在一个还没读完的游标里,你没法按下标去取它。quickselect 在这种地方直接出局,它的分区要能随时交换两个位置,要能从数组尾巴上取元素,流式数据两样都给不了。全排序也出局,排序的最后一趟才用得上前一百个,前面全是白干。
小顶堆能吃流。
来一条处理一条,堆里永远只有一百个位置,内存不随数据量涨,单趟就能出结果。
到了这一步,速度的账不重要了。4.118 毫秒和 21.15 毫秒都是内存里的事,流式场景只关心两件事:能不能一趟跑完,内存会不会爆。
(流式这条路我只用文件模拟过,没在真的消息队列上跑,数就不给了。)
先问装不装得下
顺序反过来了。以前是我先挑一个函数再往上套,现在是先问清楚这三件事,函数自己就定下来了。
第一问,数据装不装得下。装不下,后面都不用问,堆是唯一能跑的那一个。装得下再问第二问,K 有多大,K 大到跟 n 一个量级,堆就不划算了。第三问才轮到速度,同样是堆,container/heap 那种写法每个元素要走一次接口,手写 []int32 的版本才是我量到的 4.118 毫秒。
那行需求后来还是换成堆了。上线之后跑得挺快,快多少我没量,也不会拿本地的 4.118 毫秒去冒充线上数字。
我能确定的是,那三行 sort.Slice 不会再出现在我写的导出里。
每次要写它之前,我会先想一遍:这一千万个数里,我到底要的是几个。