三种语言的哈希表,各让了一步
三种语言的哈希表,各让了一步
隔壁老康难度 ★★★☆☆ · 前置:冲突不是意外,是可以被制造出来的 | 一句话结论:三家的哈希表都能做到常数时间,代价各不相同,Go 让掉的是删除,Java 让掉的是每个节点的指针和一个装箱的值,C++ 让掉的是元素必须待在自己的地址上。
我在给一个内部小工具挑容器。它干的事很单调,从导出文件里读一百万个订单号,全部塞进内存里的一张表,之后来一个号就查一次它在不在。订单号长这样,order- 后面跟十六位十六进制,二十二个字节,字符集只有 0 到 9 和 a 到 f,撞车不容易,查得却极频繁。从 2023 年 6 月入职算起,到那个月我还不满两年,手上用过的容器就那么几种,挑的时候凭的其实是手熟,说不出为什么。Go 版是我先写的,map[string]int,值存个 1 表示见过,跑完记了两个数,一百万个键占五十三兆,查一次三十一纳秒。
看着不坏,可我没有第二个数能拿来比。
C++ 那行出来的时候我以为自己写错了。一百零八兆,翻了一倍。我把 reserve 补上,把 -O2 从头核了一遍,又确认键不是每轮重新生成,重跑,还是一百零八。Java 那行贴得更近,五十六兆,跟 Go 差不到哪儿去,可查一次慢了五纳秒,这个差我也说不出缘由。那天晚上我没改代码,把三份测量里各自从哪儿开始算内存抄在了一张纸上,一行一行对,对到第二遍才看明白,这三行数压根不是一回事。
这三行数不是一杆秤称的。
一百万条灌进去,三个数
三份代码共用一个生成器,同样的种子,同样的顺序,一百万个键,字符串一个字节都不许变。每份都跑五轮预热全部丢掉,再跑五轮取最小值。取最小不是讲究,这台机器上偶尔会有半毫秒的抖动,最小值最靠近这段代码自身的耗时。容器是这么建的:
1 | m := make(map[string]int, len(keys)) |
1 | var m = new HashMap<String, Integer>(keys.size() * 2); |
1 | std::unordered_map<std::string, int> m; |
三份代码的差别只在容器这一行。
| 语言 / 实现 | 内存 | 每 key | 命中查找 | 未命中查找 |
|---|---|---|---|---|
Go 1.27 map[string]int(瑞士表) |
堆增长 53.36 MB | 56.0 字节 | 31.5 ns | 28.6 ns |
Java 21 HashMap<String,Integer> |
堆增长 55.81 MB | 58.5 字节 | 36.3 ns | 44.7 ns |
C++20 std::unordered_map<std::string,int>(libstdc++ 15.1) |
RSS 增长 108.48 MB | 113.7 字节 | 68.6 ns | 91.7 ns |
表里的 MB 是 MiB。53.36 乘 1.048576 得 55.95,除以一百万个键,正好是每 key 56.0 字节,另外两行除下来也一样对得上。每 key 那一列是拿总数除出来的,不是另量一遍,三份测量在算术上自洽,这是件小事,可没有它,后面每个字节的账都是白说的。内存那一列,Go 和 Java 差不到百分之五,我原本以为能和 C++ 摆在一起,说贵一倍,补完那张纸之后,这句话我收回去了。
自洽不等于可比。
堆占用和 RSS 不是一杆秤
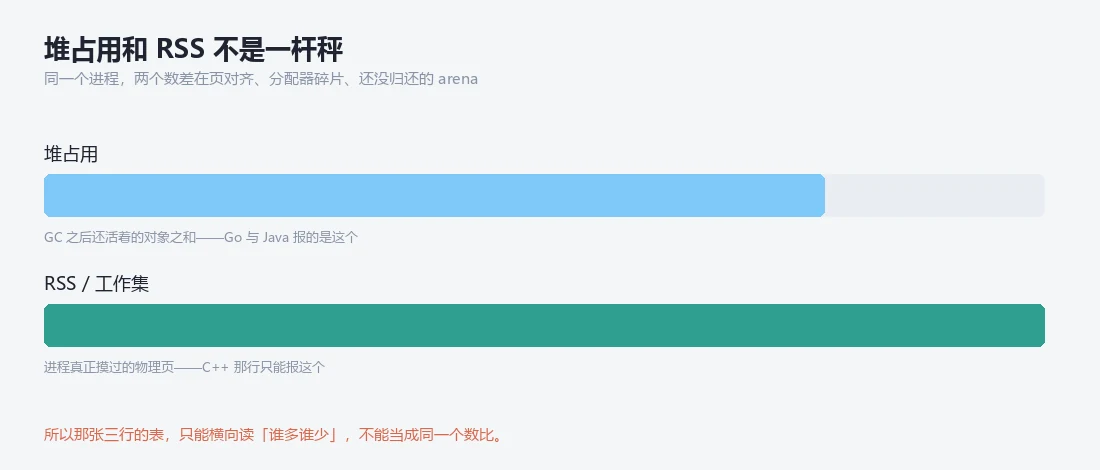
Go 和 Java 那两个数是强制 GC 之后读的。Go 里 runtime.GC() 跑两遍再读 MemStats 的 HeapAlloc,Java 里 System.gc() 之后读 MemoryMXBean 的 used,堆给了 -Xmx4g。两个读的是同一类东西,此刻还活着的对象占了多少字节。C++ 没有 GC,没有这么一本账,只能问操作系统这个进程摸过多少页,退到 GetProcessMemoryInfo 的 WorkingSetSize,也就是 RSS。一个数对象,一个数页。
账本和足迹,两回事。
RSS 里混着页对齐、分配器碎片、还给了分配器却没还给系统的堆段、代码页和栈。一个五十六字节的节点只要落进一页,那一页整页就算被碰过,页里剩下的字节有没有用都跟着计入,节点散在几百页上,页数就上去了。堆占用那边看不见这些,它只数还活着的对象,一个对象跨了几页它不管,页里空着的几百字节它也不管。反过来 RSS 也不分活着和刚死,分配器把空出来的块留在自己手里,进程的足迹一点没小。
所以 C++ 那一行,结构上贵,口径上也贵。
这两半在同一个数里分不开。要知道结构占多少,得对着分配器把每次 malloc 的尺寸类都数一遍,那是另一篇文章的活。可这不影响后面两节,一个节点里放什么、被切成几块,是能按结构算出来的,算出来的数跟 113.7 之间的差就摆在那儿,我不去圆它。
能把差摆出来,比把它抹平有用。
113.7 字节里,两次分配
unordered_map 是链地址,一条桶数组,每个桶挂一条链,链上每个节点单独分配。libstdc++ 的节点里,头一个是指向下一个节点的指针,八字节;接着是缓存的哈希值,八字节,为的是比较时先比哈希再比键;再往后才是键值对本身。键是 std::string,对象本身三十二字节,十五个字符以内直接放里面,超了另开一块堆内存存字符;值是一个 int,四字节,补齐到八。节点五十六字节。
光节点就五十六,还没算字符。
二十二个字符加结尾那个零,装不进十五字节的小串缓冲,于是每个键都多了一次分配。libstdc++ 给这串字符申请三十一个字节,这个块自己也有头、也要对齐,跟五十六的节点一样,两块各自凑整。结构上算到这儿,节点五十六,字符块三十一,桶数组取到一百万出头的桶数,每个桶一个指针,摊到每个键八字节,合计九十五。
九十五和一百一十三点七之间,是分配器的账。
这一截不好算,两块各收八到十六字节头,加起来一百一十一到一百二十七,实测贴着下沿,说明这个分配器收的头不大。再往下抠就是数尺寸类了,抠不出一字节一字节的准数,我不打算硬凑。
两次分配,两次跳转,两处碎片。
为什么非得一个元素一块,不能像开放寻址那样全挤进一个数组。标准里有一条,插入和删除不会让指向已有元素的引用和指针失效,rehash 只废掉迭代器。这一条把整块搬家的路子堵死了,只要元素还要求地址不变,它就不能被挪进一个更大的数组里重新排。链表节点行,树节点行,一整块预先排好的槽位不行。你存一个迭代器、给外部递一个指针,第二天它还在原地,代价就是这个键得自己占一块地方。C++ 让的就是这一步。
瑞士表把指纹单独排了一行
Go 1.24 之前的 map 是另一套,桶数组,一个桶八个槽,槽满了挂溢出桶,一条链串下去。1.24 起换成瑞士表,表按组切,一组八个槽。每个槽除了键和值,还配一字节的控制字节,存的是哈希高位截出来的一段,作用相当于指纹,先拿它判这个槽有没有可能,判过了才去读键。
一条指令问完八个槽。
键和值不在一个结构里。控制字节自己排一片,八个字节连成一个六十四位字;键和值按槽挨在一起,排在后面。查的时候只扫控制字节,一条比较同时问完八个槽,对上的位留下来,再按位去键数组里把那一个槽的十六字节 string header 取出来,比那二十二个字符。
探测碰的是第一片,命中之后才碰后面的。
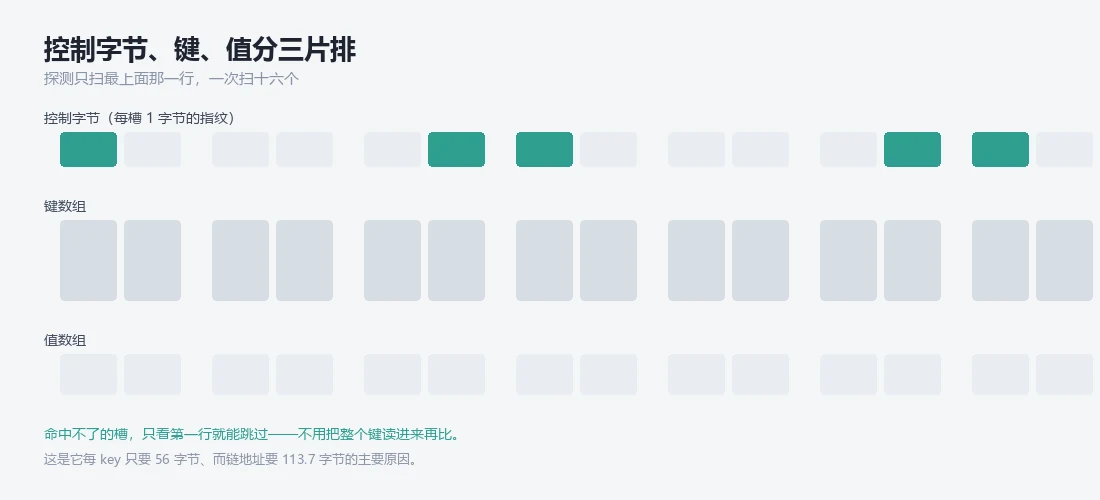
缓存行的账在这儿最清楚。一条六十四字节的缓存行能装六十四个控制字节,等于六十四次有没有可能的判断;键数组那边,同样一条缓存行只装得下四个 string header;值那边八个 int。少碰一片,就少一次可能等不回来的内存访问。按结构记账,每个槽十六字节的 string header 加八字节的 int,二十四;按八分之七的装载率折算,每个 key 摊二十七点四;控制字节一槽一个,再摊一点一四,加起来不到二十九。实测五十六,多了一倍。差的那一半我拆开过一部分,make 给的容量提示会先按装载率折算,再向上取到二的幂,一百万条最后落进两百多万个槽位,槽位本身超配了。
这一半能对上,剩下的一半挂在账上。
树化是给可制造的冲突买保险
Java 的 HashMap 是链地址,一条桶数组,桶里挂链。一个节点的对象头十二字节,哈希四字节,键引用和值引用各四字节,next 指针四字节,二十八字节,对象按八对齐,凑成三十二。装载因子零点七五,链长到八并且桶数组至少六十四个的时候,这条链转成红黑树。这两个数不是拍的:零点七五下桶内节点数近似泊松分布,均值半个,也就是 λ=0.5,一条链长到八的概率算出来大约是六乘十的负八次方——亿分之六。再往长走,概率掉得比线性快得多,所以结构上留到八这一档就够了。树节点的字段比链表节点多五个,parent、left、right、prev 和一个颜色位。
保费付在内存上,保的是最坏情况。
冲突可以被制造,这一点在前一篇里已经量过,一串挑出来的键能让所有键落进同一个桶,链越长,查一次越像线性扫描。树化把最坏情况从 O(n) 拉回 O(log n),代价是每个桶都有可能多背一个五十多字节的 TreeNode。Java 让的一步是每个键值都得是独立对象,值还得装箱。map[string]int 的 int 直接躺在值数组里,HashMap<String,Integer> 的 Integer 是另开的一个对象,十六字节。这笔钱在 58.5 里看得见,节点三十二,桶数组预分配了两百多万个桶,每个桶四字节的引用,摊到每个键八,再加一个十六字节的 Integer,五十六。
两字节半的差,在对象对齐上。
HashMap<>(n*2) 这个预分配也是必要的。不预分配,一百万个键插进去要扩容十几次,每次把旧数组整个扔掉重来,内存曲线会难看很多。这是我后来才改的,第一版按默认容量建,跑出来的堆增长比现在高出一截。
每家让掉的那一步
Go 让的是删除。开放寻址里删一个槽,不能随手把它标成到此为止的空,同一组后面可能还有同指纹的键,探测扫到第一个空槽就停手,提前清空会让后面的键再也找不到。瑞士表看这一组满没满,不满就直接置空并放行探测,满了才留一个墓碑,让后续探测跨过去(墓碑就是“这格曾经有过东西、现在删了,别在这儿停手”的记号)。这笔账藏在实现里,接口上看不见,写代码的人也感觉不到,可它确实付了。
谁都没在接口上为这一步道歉。
Java 让的是节点里的指针和那个装箱的值。链表节点要带 next,转成树之后还要带 parent、left、right、prev 和颜色位;泛型不收基本类型,值只能装箱。这两样都不是实现者偷懒,是语言那层定下来的,HashMap 得有链,Integer 得是对象。C++ 让的是元素必须待在自己的地址上。标准那条引用稳定性把开放寻址整条路封了,节点只能一个个分配,指针跳转和分配器开销都成了固定成本。三家的让步位置不一样,因为绑住它们的东西不一样,一个被 GC 和值语义绑住,一个被对象模型和泛型绑住,一个被标准文本绑住。
谁也没输,只是让掉的东西不同。
未命中比命中快,是结构说的
Go 那两列是反的,命中三十一点五纳秒,未命中二十八点六。Java 和 C++ 是正的,Java 三十六点三对四十四点七,C++ 六十八点六对九十一点七。同一个容器,一个未命中比命中还快,另一个未命中慢两成,差别在结构上。
未命中省下的,正是那一次读键。
Go 命中的最后一步躲不掉,候选槽的指纹对上了,还得把键读出来,二十二个字节逐字节比完,确认是它,再把值从后面取回来。未命中没有这一步,扫控制字节,扫到一个标着到此为止的空槽就收工,一个键都不用读。二十二次字节比较省下来,正好抵掉那不到两纳秒的差。
Java 反过来。未命中要把整条链走完,每个节点先比一遍哈希,哈希相等再调 equals,链尾那个也不中,才知道没有。命中在链上任意一个节点就停。C++ 同理,而且每走一个节点都是一次跳转,节点散在堆上,未命中的那条链往往要跳到靠后才认账,一次跳转的价钱比一次字节比较贵得多。这件事在业务里不轻。查键在不在、判断这个 id 有没有见过、去重、查缓存之前先问一层,手上大多是未命中。拿命中那一列做容量规划,会把最常走的那条路估快。
平均两个字,先问对谁平均。
定输赢的是未命中那一列
回到那个小工具。一百万个键,五十三兆和一百零八兆,在一台三十二 G 的机器上都不算什么,内存那条不足以定输赢。定输赢的是未命中那一列,二十八点六对九十一点七,三倍还多,而工具里九成的查询是这号不在,查到只是少数。我留下 Go 版,理由是这一列。C++ 那边要省,就得换容器,flat_hash_map、robin hood 这一类开放寻址的实现,内存能回到 Go 这个量级。代价是插入会让指向已有元素的引用失效,标准那条稳定性不再成立,代码里所有存着元素地址的地方都得重新审。这句是推断,我没在这台机器上量过,写在这儿当方向,不当数。
Java 那边没什么可挑的,HashMap 就是这样一个东西。
值如果是基本类型,能换 fastutil 一类的原始类型容器,省下的正是那一层装箱;换不了,就认这十六字节。真正要留意的是别让链长起来,键的哈希分布得先看一眼,尤其是键来自外部输入的时候。
选容器这件事,我现在只做一步,把自己最常走的那条路单独量一遍,命中和未命中分开量,然后照着那条路上最贵的那个数做决定。