堆为什么只排一半序就够了
堆为什么只排一半序就够了
隔壁老康难度 ★★★☆☆ · 前置:数组到底快在哪 | 一句话结论:堆只保证“父大于子”,兄弟之间不管顺序,这半有序刚好够用;建堆确实是线性的,但它比逐个插入快多少,取决于输入长什么样。
把一百万条任务记录读进内存,按优先级从高到低处理,我第一反应是建个堆。记录已经在切片里躺着,优先级就是一个 int 字段,原地建堆不需要额外空间,听起来比一条条插进去体面得多。那阵子我把《算法导论》里建堆那几页翻了两遍,纸上写满 O(n) 和 O(n log n) 的对比,心里认定这两者差一个数量级,旧代码里那种逐个插入的写法早该换掉。写完之后我没有立刻跑基准,先拿一千条数据肉眼扫了一遍输出,顺序是对的,就以为这件事结了。
账面差距很大。
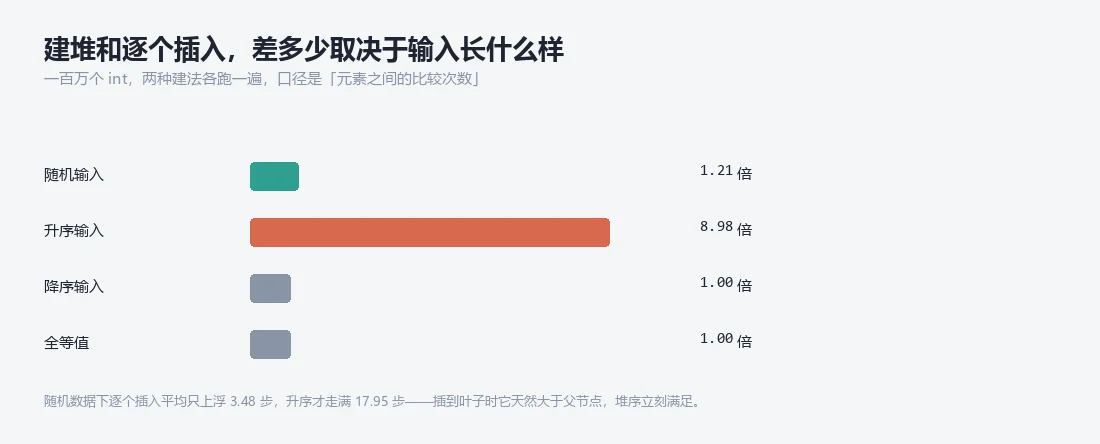
真跑起来,随机输入下建堆只比逐个插入快 1.21 倍。我先怀疑计数器写错了,又换成 testing.Benchmark 量时间,4.84 ms 对 7.99 ms,方向和计数一致。把输入换成升序,数字突然跳到 8.98 倍;换成降序和全等值,两边又几乎贴着。同一份代码,同一台机器,同一组参数,变量只有输入本身。
差别全在输入顺序上。
一百万条任务躺在一个切片里
我 2023 年 6 月刚入行那阵,第一个独立交到手里的工具是日志检索:用户给一个时间范围,返回最新的若干条。几十万到一百万条数据全读进内存完全可行,我最初用 sort.Slice 全排序再截前 k 条,简单,结果也对。后来 k 越来越小、数据量越来越大,排序里那些完全用不上的先后次序让我觉得亏,于是改成维护一个大小为 k 的小顶堆,插入 n 次,成本是 n log k。
全排序确实浪费。
但 Top-K 这个例子救不了我。它的堆只有 k 个元素,跟把一百万个元素原地建成堆根本不是一回事。把我撞上建堆问题的是另一个离线任务:一百万条任务已经在切片里,处理顺序按优先级来,堆要一次建好,之后反复取堆顶、再补新任务进去。
建堆和插入是两件事。
两条路都得到同一个堆,区别只在过程。原地建堆从末尾那个非叶节点往前,对每个节点做一次下沉;逐个插入从空堆开始,每个新元素先放到末尾,再上浮到该去的位置。前者算出来是 O(n),后者是 O(n log n),很多文章写到这里就收尾:数据量大就用建堆。我照做了,然后在随机数据上被 1.21 倍这个数字拦了下来。
数字和结论对不上。
半有序已经够用
堆的定义只有一条:每个节点的值都不小于它的子节点(大顶堆),或者都不大于(小顶堆)。它没有说左右子节点谁大,也没有说同一层从左到右怎么排。数组 [9, 8, 7, 1, 2, 3, 4] 是堆,[9, 7, 8, 4, 2, 3, 1] 也是堆,两棵树的兄弟顺序完全不同,根都是 9。堆在内存里一般直接用数组存,父子关系靠下标算出来,不需要指针,也不需要节点结构体。整棵树的元素挤在一段连续内存里,从根往下走的时候,相邻几层往往落在同一片缓存区域,这是一棵用指针串起来的树做不到的。
兄弟之间不用排队。
这条约束比排序弱得多。排序要求任意两个元素都有确定次序,堆只要求父节点压住子节点。弱约束换来的是便宜的维护:插入一个元素,沿一条从叶到根的路径上浮,最多 log n 次比较;删掉堆顶,把末尾元素提上来,再沿一条从根到叶的路径下沉,也是 log n。有序数组插一个元素要挪动后面所有人,O(n)。
一半的序,一半的维护成本。
对优先队列来说这些序够了。我要的只是“当前最大是谁”,根节点就是答案;取走它,把末尾元素提到根上再下沉一次,第二大的会自己浮到根。整个过程不需要知道剩下元素之间怎么排,只需要每个父节点都能压住自己的孩子。Top-K 同理,堆顶是当前 k 个里最差的那个,新元素只要比它好就有资格挤进来。
堆不回答“第五大是谁”。
上浮与下沉
所有堆操作都能归到两个动作。上浮用在插入:新元素放在数组末尾,也就是完全二叉树的末尾叶子,然后和父节点比,比父节点更优先就交换,直到不满足条件或者顶到根。下沉用在删除堆顶和建堆:元素和两个子节点里更优先的那个比,子节点更优先就交换,直到落到叶子或者已经压住两个孩子。
一个往上,一个往下。
1 | func siftDown(h []int, i, n int) { |
下沉有两个地方容易写错。子节点下标,数组从 0 开始,左孩子是 2i+1,右孩子是 2i+2,写成 2i 和 2i+1 就全塌了。循环终止,交换之后要从新位置继续往下沉,不能只沉一层就返回。上浮反过来,父节点是 (i-1)/2,循环到 i==0 为止。边界写错,Go 不会报错,堆只是悄悄不再满足堆性质,然后在你某次取堆顶时交出一个错的结果。
堆的 bug 通常很安静。
建堆用的就是下沉,不过顺序有讲究。从下标 n/2-1 开始,一路往前到 0,对每个节点调用一次。叶子没有孩子,下沉会立即返回,直接跳过。这个顺序保证每个节点下沉时,它的左右子树已经是堆,交换下去之后两边仍然满足堆性质。
从后往前,子树先成立。
1 | for i := n/2 - 1; i >= 0; i-- { |
为什么从 n/2-1 开始
把节点按层编号,根在第 0 层,第 k 层最多 2^k 个节点。高为 h 的堆里,第 k 层的节点下沉最多能走 h-k 层。节点数乘下沉层数再对 k 求和,工作量落在 n 附近;每次下沉最多两次比较,上界就是 2n。换个从下往上数的写法,第 k 层节点数正好 n/2^(k+1),同样收敛到常数倍。
叶子节点不用动。
另一个记住它的方式:堆里有一半节点是叶子,本来就合格;剩下那一半里又有一半只有一层可沉;再往上,节点数每次减半,能沉的层数只加一。越靠上的节点越少,越靠下的节点越多但越不需要动,两头一夹就把总量压在线性,不会让每个节点都走满 log n 层。
多数节点在底层,几乎不动。
这也解释了实测数字:四种输入下建堆的比较次数都是 1.88 到 2.00 次/元素,离 log n = 20 差着一个数量级。2n 是上界附近的常数,不是“每个节点平均下沉两步”这种朴素的平均,是底层那批不动的节点把均值拉低的。需要走远路的只有根和根附近那少数几个。
常数 2,不是 20。
随机输入和升序输入差七倍
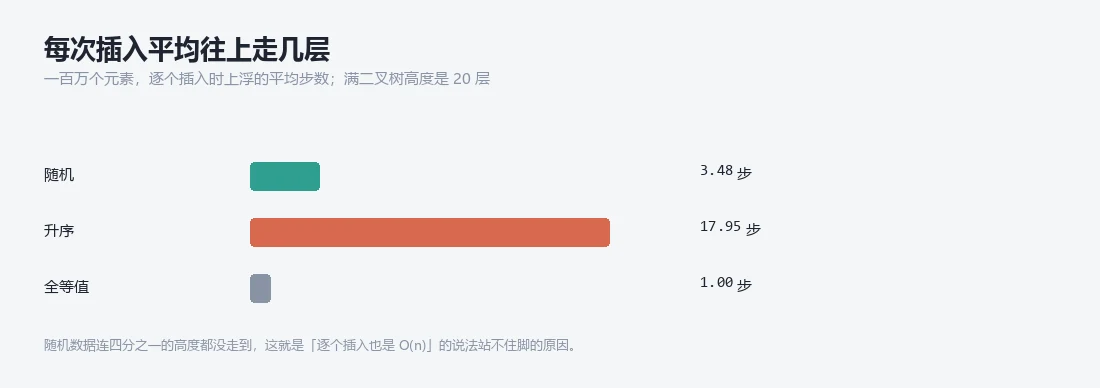
把四种输入放在一起,差距就出来了。随机一百万个 int,建堆 1 882 276 次比较,合 1.88 次/元素,4.84 ms;逐个插入 2 282 305 次,2.28 次/元素,7.99 ms;比较次数比 1.21 倍。升序输入,建堆 1 999 974 次,2.00 次/元素,1.81 ms;逐个插入 17 951 445 次,17.95 次/元素,13.59 ms;比较次数比 8.98 倍。降序输入两边都是 999 999 次,1.00 次/元素,建堆 0.55 ms,插入 1.14 ms。全等值也是两边 999 999 次,1.00 次/元素,建堆 0.51 ms,插入 1.04 ms。
同一组代码,差了七倍多。
差距全部来自插入路径的长度。随机数据下,新元素落到叶子时,它大于父节点的概率并不低,堆序当场满足,上浮走几步就停,平均 3.48 步,离树高 20 层还远。升序数据反过来:每插一个更大的元素,它一定比堆里所有元素都大,必须一路浮到根,平均 17.95 步,几乎把整条路径走满。全等值最省,一次比较就停,平均 1.00 步。
升序输入把最坏情况走满了。
建堆这一侧几乎不看输入:随机 1.88,升序 2.00,降序和全等值 1.00,始终贴着 2n。逐个插入则从 1.00 一路涨到 17.95,log n 的影子只在最坏输入下才完整露出来。很多文章拿 O(n) 和 O(n log n) 做对比时,心里想的是最坏情况,写出来却是“任何情况下建堆都更快”。随机数据只快 1.21 倍,这个量级放进工程里,很容易被一次内存分配或者一次缓存未命中抹平。
最坏情况不是默认情况。
还有一层容易被忽略:比较次数不等于耗时。随机建堆的比较次数比升序少,4.84 ms 却比 1.81 ms 慢;降序和全等值次数一样,0.55 ms 和 0.51 ms 也有小差距。分支预测、交换次数、内存访问模式都掺在里面。我没有把这几毫秒拆到指令级,只能确认一件事:比较次数能当复杂度证据,不能当性能预测。
复杂度是趋势,不是秒表。
container/heap 慢在哪
我最早用的堆来自标准库 container/heap。它要求实现五个方法:Len、Less、Swap、Push、Pop,Push 和 Pop 的参数是 interface{},每次进出都要装箱;堆内部的比较和交换也得先断言回具体类型,每次操作都要过一遍接口。单次 push 加 pop,跑三轮取中位:container/heap 七十二纳秒,手写的 []int 加内联上浮下沉十四纳秒,差五倍出头。
接口是抽象,也是开销。
单次差几十纳秒不起眼,放进百万次的循环就是几十毫秒。标准库的设计目标本来就不是极限性能,它要支持任意类型、任意比较逻辑,还要保持 API 十几年不变,接口和动态派发是这份通用性的代价。Go 1.18 之后可以用泛型写类型安全的堆,但 container/heap 的接口已经铺开了,不会为了几十纳秒去改。
通用和快,经常不能兼得。
手写也不是白拿。下标、边界、扩容都得自己管,还要写一组测试证明它确实是个堆。我的做法是先用标准库把逻辑跑通,确认堆操作真是热点,再换 []int 或者泛型版本,换完把同一组基准重跑一遍。手上没有基准就动手手写,多数时候只是把接口开销换成了自己的 bug。
先测量,再替换。
先确认你真的需要堆
判断标准不复杂。堆操作占总耗时很小,或者元素类型复杂、比较逻辑经常变,用 container/heap 更省事,代码也更容易被同事接手。堆在热路径上、元素是 int 或 float、每秒被调用几百万次,手写更合适。Top-K 只保留 k 个元素,k 通常不大,操作次数是 n,接口开销会被放大,手写收益比较明显。
场景比喜好重要。
还有一条:先确认你真的需要堆。数据一次性到手、只排一次序,sort 往往更快;k 很小,维护一个固定大小的堆才有意义;数据本来就基本有序,插入排序或者一次扫描可能更简单。堆的价值在“反复取最值”,不在“把所有元素排好”。这一层想清楚了,建堆还是逐个插入才是个值得讨论的问题。
别为了用堆而用堆。
那次实验之后,我把日志工具里的 Top-K 换成了手写的 []int 小顶堆,标准库版本留在测试文件里当对照。一百万条随机数据,两种建堆法的差距远没有书上写的那么夸张,升序数据下的 8.98 倍倒是真的。现在再看到“建堆 O(n),所以更快”这种句子,我会先翻到输入那一节看看写没写;没写,就当它没说完。