堆撑得住一万个定时器吗
堆撑得住一万个定时器吗
隔壁老康难度 ★★★☆☆ · 前置:堆为什么只排一半序就够了 | 一句话结论:最小堆撑得住一万个定时器,但一百万个 tick 的稳态负载下,6000 格的时间轮比它快 12 倍;Go 自己用的是每个 P 一个四叉堆。
调度器的第一版只有二十来行:任务塞进一个 map,超时用 time.AfterFunc 挂上,失败就退避重试,三次不过判失败。压测全绿的那天下午,我在周会上说这套结构已经收尾,定时器只是个壳,套在业务外面,不参与任何设计决策。现在回头看,错不在乐观,在于我把定时器当成了一个只会被创建、不会被修改的东西:它只在任务开始那一瞬间露面,之后就再也不出现,所以怎么存都无所谓。这层误解不报错,它只让后面每个新需求都变成一次小返工。
这个判断撑了不到两个需求。
超时变成可配置之后,退避也得跟着变;客户端断连要能立刻取消;优先级高的任务得插队。壳开始往外长东西,每个任务身上挂一个 *time.Timer,改退避要 Stop 再 Reset,取消得从 map 里摘掉,还得防着 Stop 返回 false 的那一刻回调已经跑起来了。定时器从壳变成了这套调度器里最忙的结构,而我写它的那套代码还停在第一版的心智上:以为所有定时器都是走到期就扔,不需要改,不需要找。
接着是数量。
一个任务重试三次就是三个超时点,加上心跳、锁续期、空闲连接回收,队列里同时躺着的定时器很容易到四万的量级。四万个什么结构,直接决定这个调度器能跑多快:每次插入都线性扫一遍的话,四万乘上每秒几十次新增就是纯浪费;堆顶那个判断写错的话,又会变成一次没必要的忙等;要是把定时器散在 map 里靠一个全局 tick 挨个扫,那四万次比较每秒都在烧,还看不见谁在烧。
先写的是最小堆。
定时器要回答的只有两件事:最近那个什么时候响,新来的插到哪儿。给每个定时器记一个绝对时间戳 when,拿它当 key 建最小堆,堆顶天然就是下一个该醒的。看一眼堆顶的 when,没到点就继续睡,到了就弹出来执行,执行完再看新的堆顶。container/heap 只要求实现五个方法,Less 里比较 when 就够了。这个结构的好处是它把两件事合成了一件:找最近的和插入新的,走的是同一棵树,不用额外维护一个有序表。
1 | type timer struct { |
插入是上浮,弹出是下沉,两边都是 O(log n),这段代码没有一处多余到可以删。也正因为它没有一处多余,它适合当基准的起点:常数究竟有多大、n 在真实负载里稳不稳,这两件事在代码里都看不出来。上浮走了几层、下沉走了几层、中间碰了几次缓存,全藏在运行时里,只能靠数。还有个细节容易漏,container/heap 的 Pop 要求先把堆顶和最后一个元素换位、再把末尾截掉,直接 slice = slice[:n-1] 会把堆顶扔了留下一个错的堆,这个错在 n 小的时候根本看不出来。
我一开始以为这两点无关紧要。
灌一万个再全弹完,一天里不会发生
第一件事是往空堆里连塞一万个定时器,再一路弹到空,数比较次数。插入 22 918 次,平均 2.29 次一个;全弹出 216 549 次,平均 21.65 次一个。差了一个数量级,因为建堆和拆堆不是一个动作:建的时候整体近似随机、上浮两层就停,拆的时候每次都要把新的堆顶一直沉到叶子,越接近结束越贵。
假负载给得出常数,给不出行为。
空堆灌满再抽干,等价于把一整天的定时器攒到同一秒全部到期,堆从零长到一万,再从一万掉回零,中途没有任何插入和弹出交错。进程真跑起来不长这样,堆里长期躺着一万来个,每秒进几个出几个,涨落都在几千的量级,这才是需要被解释的形态。两种形态下堆的深度一样,可被访问的节点完全不同:一次灌满只碰堆顶和路径上的那几个,稳态负载会碰到几乎所有叶子。顺手测的另一样更有意思:插入的比较次数不随规模变。n 是一万、十万、一百万,插入一次都是 2.27 到 2.28 次比较,因为随机输入下上浮两层就停,跟堆有多深关系不大;耗时 1.00 ms、1.00 ms、15.37 ms,前两个一样是因为测量精度不够,第三个才开始反映数据量。换时间轮(timing wheel)做同一件事,3600 格,一万个定时器按 when % 3600 落格,插入 538 µs,一次比较都没有。
这一轮两边还站在同一条起跑线上。
一百万个 tick:214.96 ms 对 17.78 ms
真实负载得自己造。始终维持一万个定时器,跑一百万个 tick,每个 tick 新来 3 个,平均寿命 6000 个 tick,到期立刻执行再补新的进来。这样堆的规模在涨落里稳住了,进出频率也接近实际,两边才有可比性:同样的定时器数量,同样的平均寿命,同样的到期总数。
这台机器的数字是 i9-14900HX,Go 是 go1.27.2 windows/amd64,GOMAXPROCS=32,两个结构跑的是同一份输入序列。最小堆跑完 214.96 ms,执行了 3 001 056 次触发;6000 格的时间轮跑 17.78 ms,触发 3 000 964 次,前者慢 12.1 倍。差的 92 次触发得单独交代,时间轮把过期时间取整到格,落在同一格的会在同一刻醒,边界上就会多触发或者少触发几十个,这是结构差异,不是谁的 bug。
可十二倍这个数得先站得住。
堆那边每一百来个 tick 就要为自己重排一批,插入上浮、弹出下沉,一百万个 tick 里到底比过多少次,光看代码估不出来。时间轮那边一次比较都没有,它干的活是往前走一格,把格子里挂着的那串挨个执行,跟里面装了多少个没关系。
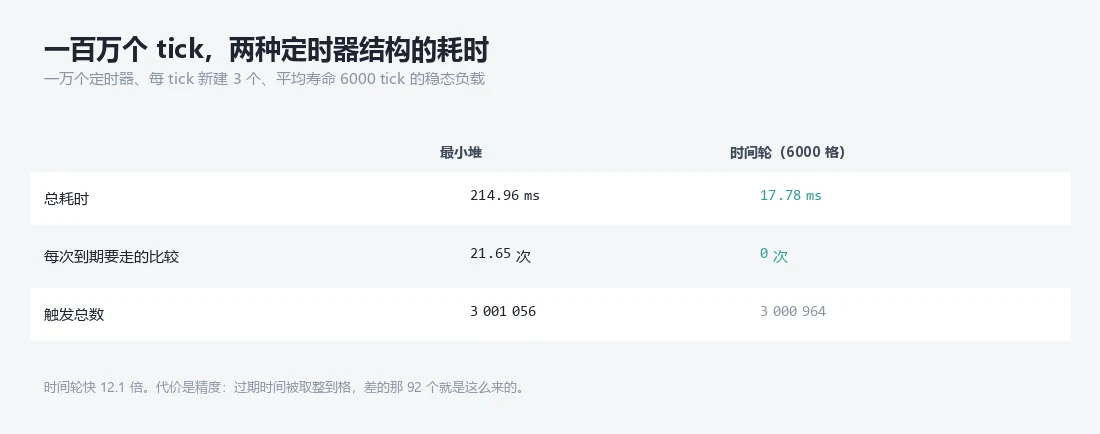
两个数字来自同一台机器、同一版 Go,样本是一百万个 tick,触发数的量级一致到千分之一,剩下的差别只有结构本身。这个差距不是一条曲线的两端,它是两种形状:一边在长,一边不动。堆那边一千个定时器是这么多,一万个也差不多,涨上去的是深度;时间轮那边不管装多少个,推进一步就是走一格,一秒走一千次。
时间轮推进一格,只是走一条链表
时间轮的形状是一圈格子。精度 1 ms、一圈 6000 格,第 i 格管的是 when % 6000 == i 的那些定时器。格子里不排序,挂一条链表就行,同一格本来就在同一刻到期,排序没有意义,也排不出更细的东西来:一格里最久和最急的两个定时器,本来就该在同一毫秒醒。前面测落格分布的那组用的是 3600 格,圈小一点只是想让一万个定时器把格子填满些,格数多少不改变这个结构的形状。
插入 O(1):算落点,挂到链表头,不比较也不挪动别人。推进也简单,指针走一格,把这格里的东西全放出去。
落点算一次,之后再也不碰。
1 | func (w *wheel) advance(now int64) { |
这段 advance 是本文所有数字的来源,没做过任何优化:没有比较,没有 log,也没有任何随规模增长的东西,格子里堆一千个和装一个,走的步数一样。这也解释了它为什么敢把精度放宽:省下来的不是 CPU 时间,是让推进一步的开销跟容量彻底脱钩。
坑不在速度上,在你要为速度付什么。三样东西被同时定死:精度、内存、跨度,而且它们互相拽着,改一样就把另外两样顶歪。想让它更准,格子就得更密;想让它跨得更远,圈就得更粗;想让它更省内存,精度和跨度总得让一个。结构本身没给调参留缝,能调的是这三个数,调完就是一套新参数下的一圈新格子。
格子固定、精度取整、跨度要分层
精度。格子的宽度就是这套结构的时间分辨率,落进同一格的会在同一刻醒,跟实际到期时间差多少全看运气,期望是半格。6000 格配 1 ms,多等不到 1 ms,调度器无所谓;要在几十微秒的粒度上排队,1 ms 就太粗,得把格子改密,圈数跟着涨,内存也跟着涨,绕回来还是同一个取舍。取整这件事没法从结构里拿掉,它写在落点的算法里。
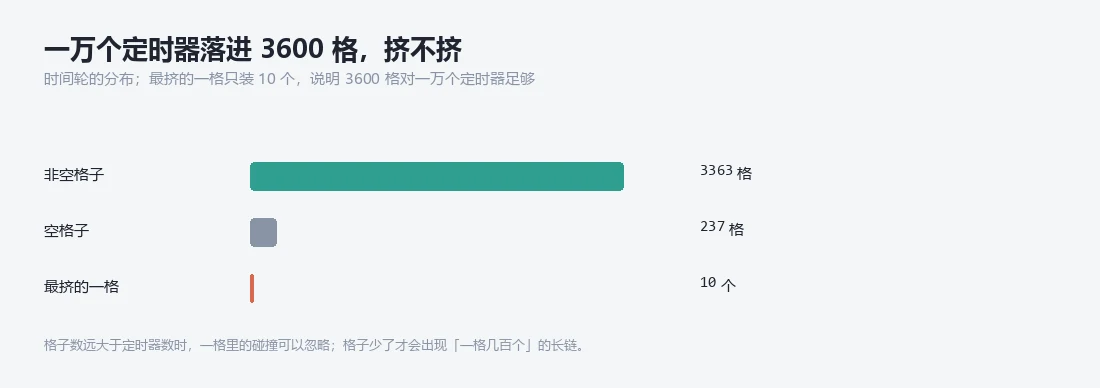
内存。一圈 3600 格就是 3600 个指针,跟里面装了多少定时器无关,一万个定时器不会让这圈变大一格,一百万个也不会。格子是提前买好的地,摊子铺开了就收不回来,哪怕大半时间空着。
一万个定时器落下来,3363 格非空、237 格空着,最挤的一格装了 10 个,平均一格不到三个。
跨度。一圈的总跨度是格子数乘格子宽度,6000 乘 1 ms 只有 6 秒,超过 6 秒的定时器要么绕圈,要么换成多层时间轮,秒针、分针、时针各一圈,到点往下一层降级。一旦分层,插入就不止一步,一次落点要判断落在哪一层,到点降级时还要重新算落点,O(1) 里就开始长出常数。
这三条是绑在一起的,精度粗一点,格子能少一点,跨度能长一点,多等的也更久,任一条想单独变好都得拿另外两条换。
Go 给每个 P 配了一棵四叉堆
那 Go 自己怎么做的。我原以为 runtime 里放着一个全局定时器堆,所有 time.After、time.NewTimer 都在里面排队,理由是高优先级的总该全局看得见。翻到 runtime/time.go:135,注释第一句就把这个想法推翻了:// A timers is a per-P set of timers. 每个 P 一套。P 是 Go 调度器里的处理器,GOMAXPROCS 是几就有几个。每个 P 有自己一棵堆和一把锁,time.AfterFunc 把定时器塞进当前 P 那一棵。理由跟分片一样:一万个定时器争一把锁,不如三十几个 P 各管几千个。更省的是位置:定时器落在哪个 P 就在哪儿被检查,那片内存搞不好还在 L2 里;换成全局堆,三十几个 P 轮流上来戳同一块,每次都是冷的。代价是跟着 goroutine 走,一个 P 堆得多了,另一个闲着也帮不上忙。
第二个意外是这棵树不是二叉的。
runtime/time.go:1305 写着 const timerHeapN = 4,time.go:1243 的注释更直白:// The heap is timerHeapN-ary. See siftupTimer and siftdownTimer. 父节点的算法在 time.go:1327,p := int(uint(i-1) / timerHeapN);有没有孩子在 time.go:1347,if i*timerHeapN+1 >= n;下沉时在四个孩子里挑最小的在 time.go:1361。三个式子拼起来是一棵四叉堆,四个孩子落在连续的一段下标上,父亲在 (i-1)/4,第一胎在 4i+1,中间没有空隙。
还有一层是延迟删除。
time.go:151 的 zombies atomic.Int32、time.go:159 的 minWhenHeap、time.go:164 的 minWhenModified,都为这条路准备。改一个定时器的时间,如果立刻在堆里找出新位置再上浮下沉,代价是 O(log n) 加一次加锁;Go 改成只标一个 timerModified 记下新时间,等它快到期了再收拾,旧的那条路径留给惰性清理。读堆顶时先看 minWhenHeap,发现有改动再看 minWhenModified,两者不一致才真的去修堆。
四叉堆矮。同样节点数,每个节点四个孩子,层数大约只有二叉堆的一半;但每次下沉要在四个孩子里定出最小的那个,比较次数比二叉多。
收益在别处。
heap[leftChild:min(leftChild+timerHeapN, n)] 是连续的一块,一次缓存行抓下来四个都在手里;二叉堆的两个孩子分在两处,隔一层就可能多一次未命中。矮一层加上连续的孩子,省下来的是访存不是比较。再加一条:下沉没法提前退出,得走到叶子才知道对不对;上浮碰上位置刚好对了就能停。
下沉更贵,树矮一半就赚回来了。
十万条连接那头才轮到它
堆的好处是精度不受限,内存只跟定时器数量成正比,跨度想要多长有多长,换个 64 位时间戳就行;坏处是每次操作要 log n 次比较,n 大到某个程度开始疼。时间轮反过来:插入 O(1),推进是常数,代价是精度被格宽定死、内存被格数定死、跨度被圈数定死,三样都焊在结构里,调参救不回来。
我给自己划的线是这样。
定时器几千到几万、精度毫秒级、生命周期几秒到几分钟,堆完全够用,实现还短。
规模上到十万,或者同构的短定时器密到一条链表挂几十个,才值得换时间轮,而且大概率要分层。有分量的实现在这条线的另一侧,Linux 内核的定时器早就不是单个堆,Netty 的 HashedWheelTimer 名字里就写着时间轮,它们面对的是几十万条连接各自的超时,堆顶那个 log n 会变成瓶颈,取整到格带来的那点误差反而比 log n 便宜。
进程调度那一侧的取舍在 进程状态:R、S、D、Z 各自在等什么 里,这里不重复。
还有个问题我没测。Go 的四叉堆是每个 P 一棵加延迟删除,我那个 bench 是单线程一棵二叉堆,两边的数字不能直接对着比。
真要在 Go 里替掉 time.Timer,得先把这两件事对齐。留最小堆这个决定暂时还站得住,因为四万个定时器离那条线远,而时间轮那三个焊死的参数我不敢先定。哪天要改,我会先量每个 tick 的弹出数,再定圈有多大。