图的遍历:递归不溢出,是因为栈藏起来了
图的遍历:递归不溢出,是因为栈藏起来了
隔壁老康难度 ★★★★☆ · 前置:队列为什么会把内存吃光 | 一句话结论:BFS 和 DFS 差的不是遍历顺序,是那个待办队列用先进先出还是后进先出;递归 DFS 不溢出,是 Go 替你把栈涨到了一百多兆。
抓取器在环上打转
一个抓取器从首页出发,顺着链接往下爬。
站内链接几乎一定成环。A 链到 B,B 链回 A,导航栏、页脚、标签页又各指一遍,同一批地址被反复发现。没有访问标记时,程序会在两三个页面之间来回跳,队列永远不空,内存曲线一路向上,人还盯着屏幕等它结束。排查的人容易先怀疑并发,再怀疑超时,回头才想到图上本来就有环。环路不报错,它只是让遍历永远走不完,每一步看起来都合法。
问题出在访问标记上。
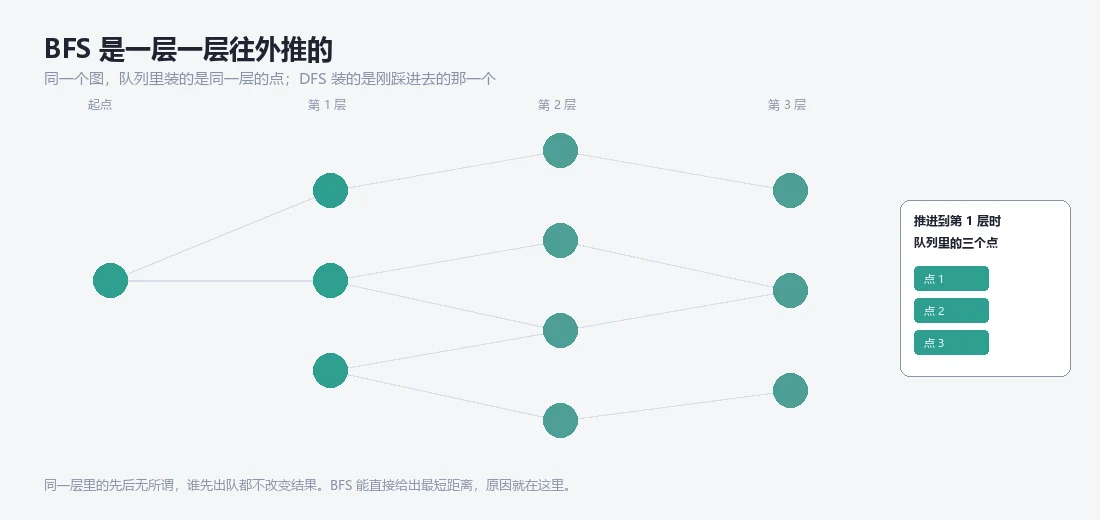
标了 visited 之后,环路被剪断,剩下的问题只有一个:下一个该看谁。把待办放进队列,先发现的先展开,节点按距离一圈圈往外扩;放进栈,刚发现的分支立刻被取出,走法变成一条路扎到底。两种顺序,两种问题:最近的路有多长,这条路通不通。容器不同,答案的形状就不同。
两个容器,两种脾气
队列先进先出。同一张图,先发现的节点先展开,距离为 1 的一层处理完才轮到距离为 2 的,于是节点按层铺开,像水面上的波纹。栈后进先出,刚发现的分支立刻被取出,走法变成一条路扎到底,撞墙再回头。前一种顺序适合问最短距离,后一种适合问连通性、拓扑序、有没有环。教科书把这句话压成 BFS 用队列、DFS 用栈,然后就翻页了。口诀没错,只是省掉了两样东西:容器本身的开销,以及递归写法的栈去了哪里。
翻页翻掉的是代价。
顺序本身不花钱,容器才花钱。队列的长度可以长到与节点数同阶,栈的深度也一样。让人困惑的是另一件事:很多人写 DFS 时根本看不见栈,因为用的是递归,而递归的栈不在代码里。代码里只有函数调用自己,没有 push,没有 pop,于是很容易得出一个错误结论,这个算法不需要栈。等到图变成一条一百万点的链,程序没崩,他们更加确信这个结论。直到某天内存报表上多出一百多兆,才回头找那个看不见的容器。
看不见不等于没有。
队列版 BFS:顺手把距离带出来
先看队列版。
1 | func bfs(g [][]int, s int) []int { |
dist 数组兼做 visited:初值 -1,起点 0,第一次碰到某个邻居时写入 dist[v]+1。队列保证节点按距离非降序出队,所以第一次写入就是最短距离,后面再遇到也不用更新。这行赋值看着随意,其实是 BFS 唯一需要证明的地方,证明的抓手就是队列的先进先出。少了这个性质,写法再像也不是 BFS。另外,图不连通时从起点只能走到一个连通块,剩下的点仍然是 -1,这个 -1 本身也是信息:它说明这些点从起点不可达。
queue = queue[1:] 只是把切片头往后挪,底层数组不会缩。一百万个点全部入队再全部出队,那 8 MB 仍然挂在那里,直到函数返回。图宽的时候队列长度接近节点总数,这份内存在峰值上不算冤,峰值过后就是纯浪费。想省可以换成环形缓冲,或者每一层重建一个切片。队列吃内存这件事,和容器里装什么无关,和怎么取有关。
队列最长的时候,正好是图最宽的地方。
DFS 的两个写法:递归,和用显式栈模拟
递归版只有七行。
1 | func dfs(g [][]int, v int, seen []bool) { |
没有栈,没有显式容器,seen 一标就往下钻。这份代码在 C 里会栈溢出,在 Java 里要看 -Xss 给多大,在 Go 里通常能跑完一百万层。不是因为 Go 没有栈,是因为它的栈会自己长大。同样是递归,同样是深链,三种语言给出三种结局,差别在运行时怎么对待栈。Go 的选择是把栈做成可移动的:不够就换一块更大的,把旧栈整个搬过去。搬的时候还要修正栈上所有指向栈内的指针,这件事只有运行时做得到,编译器配合留好了信息。
把栈摆到明面上。
1 | type frame struct{ v, idx int32 } |
显式栈版本把递归拆成机器能看懂的样子。栈里每一项记录当前节点,以及下一个还没检查的邻居下标。循环每次只看栈顶那一帧:下标还没越界,就取出一个邻居,下标加一,没访问过就压栈;下标越界,说明这个点的邻居看完了,弹栈。整个过程的栈深度就是当前这条路径的长度。和递归相比,它多了一次 append、一次边界检查、一次手动的下标自增,少了一次函数调用和返回。这些开销在总时间里的占比很小,真正变化的是内存形态:从运行时代管的调用栈,变成你自己分配的一块切片。
顺序对不对,全看压栈时机。
一次性把邻居全压进栈,也能遍历完整张图,但顺序和递归版相反。递归先看第一个邻居,一次性压栈后先取出的却是末尾那个邻居,后进先出把顺序翻了过来。存 idx 的版本没有这个问题:邻居是一个一个取的,取一个压一个,和递归里 for 循环的节奏完全一致,出栈顺序自然相同。要让两种写法输出一模一样,idx 不能省。反过来说,如果只关心访问到哪些点、不关心顺序,一次性压栈更短也够用。很多模板代码就停在这一步,然后在需要按字典序输出路径的题上翻车。
那一帧里只有两个数字
frame 的定义是 struct{ v, idx int32 },两个 int32,八个字节,没有指针,没有切片头。v 是节点编号,idx 是这一帧下一个要检查的邻居在邻接表里的位置。递归调用时,这两样东西分别躺在栈帧的参数区和局部变量区,返回地址另算;改成显式栈,它们被捏成一个值,压进 []frame。栈里存的是状态,不是函数。八个字节是这套写法的最小公约数:节点编号在 int32 范围内够用,邻居下标也在 int32 范围内够用,前提是任何一个点的度数都不超过二十一亿。真实图上这个前提几乎总是成立,一百万点的链每点度数最多二。
为什么必须存 idx。
只存节点也能走,但每次回到这一帧,for 循环都要从头再扫一遍邻居:已经看过的、正在看的、还没看的,全部重新判断一次。度数高的图上,这个浪费会累积成平方级的开销。存下 idx,等于把递归里那个隐式的循环变量搬进栈帧,回来时从断点继续。少一个字段,复杂度可能掉一个量级。星型图是最极端的例子:中心点度数一百万,不存下标就要扫一百万遍。这个坑在递归版里不存在,因为 for 循环的变量就在机器栈上,编译器替你存了。
八字节是这么来的:两个 int32,对齐后正好八字节。
| 链长 | 递归最大深度 | 显式栈最大深度 | 显式栈内存 |
|---|---|---|---|
| 1 万 | 9 999 | 10 000 | 78.12 KB |
| 10 万 | 99 999 | 100 000 | 781.25 KB |
| 100 万 | 999 999 | 1 000 000 | 7.63 MB |
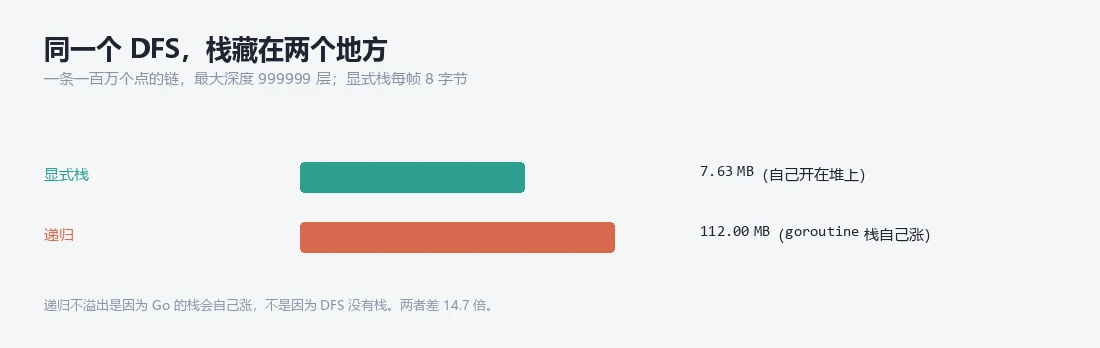
表里的显式栈深度是峰值:一条链上每个点都压过一次,一百万的点就是一百万帧。八字节乘上深度,一万是 78.12 KB,十万是 781.25 KB,一百万是 7.63 MB。数字很干净,因为每帧大小固定,没有额外分配,也没有隐藏的指针要扫描。切片的扩容按倍增走,峰值时多留一份旧数组,量级不变。这也是显式栈好估算的原因:深度上限就是内存上限,乘一下就知道。递归版本做不到这一点,你没法在写代码时算出运行时会给每帧塞多少东西。
递归那边不干净。
递归的栈藏在 goroutine 里
递归版跑完一条一百万个点的链,程序没崩。用 runtime.ReadMemStats 读 StackInuse,前后差了 112.00 MB。除以一百万,每层约 117 字节。这 117 字节不是凭空来的:返回地址、调用者的栈指针、参数、局部变量,以及栈增长和抢占需要的元数据,都在里面。具体数字随函数签名和 Go 版本浮动,量级稳定在百字节上下。同一段代码在 amd64 和 arm64 上可能不一样,开了内联之后也不一样,所以别把 117 当成常数,把它当成一个观测值。观测方法很简单:跑之前读一次,跑完再读一次,两个数相减,再除以链长。
栈没有消失。
它从你的代码里挪到了 goroutine 的栈上。goroutine 的栈一开始只有 2 KB,函数调用链变深、栈快不够时,运行时分配一块更大的栈,把旧栈里的内容整块拷过去,再把所有指向旧栈的指针改到新地址。所以一百万层递归不会像 C 那样在几 MB 处炸掉,它会把栈一路涨到一百多兆,然后安静地返回。代价从崩溃变成内存,付账的时间挪到了运行时。栈翻倍的次数是 O(log n),但每次拷贝的内容是当前栈大小,总拷贝量仍是 O(n),一百万层就是几百兆字节的数据搬来搬去。这部分开销不进 StackInuse,进的是 CPU 时间。
这就是藏起来的意思。
显式栈版本跑同样的一百万点,占用 7.63 MB,和递归版差 14.7 倍。差距不来自递归本身,来自每一帧的形状:goroutine 栈帧要照顾调用约定、栈溢出检查、垃圾回收和栈增长,一帧一百多字节;业务代码需要的只是两个 int32,八字节。剩下那一百多字节,全是运行时的记账。这笔账在浅递归里看不出来,一万层也就一兆出头,随便哪台机器都扛得住。深到一百万层,记账的成本就超过了业务本身。所以问题不是递归能不能写,是这笔账你打不打算付。
顺序也会咬人。
同一批节点、同一个 O(n),切片顺着地址走 3.03.5 ms,链表按节点地址跳 11.615.3 ms,把链表节点打散之后 970 ms。差的不是算法,是缓存行:连续内存一次读一整条,散落内存每次都可能缺页。这条只当旁证,遍历的复杂度相同,实际耗时能差两个数量级。图的邻接表如果也用指针串起来,同样的效应会出现,只是没那么夸张。显式栈用切片而不是链表,顺带也吃到了这个红利。
图也一样。
深度不可控,就得自己管栈
三种情况值得换成显式栈。图大到 goroutine 栈涨不起,比如百万级深链配几百兆内存限额的服务;需要在遍历中途暂停、恢复、把进度存进数据库,递归的栈没法序列化;递归深度由外部输入决定,攻击者构造一条长链就能让进程 OOM。前两种是工程取舍,第三种是安全问题。还有一种不常见但很实用的场景:遍历逻辑要在协程之间切换,显式栈可以把状态放在堆上,递归做不到。判断标准很朴素:深度是不是不可控,状态是不是要持久化。
显式栈不是更快。
它通常还慢一点,多了一次 append、一次边界检查、一次手动的下标自增。换来的是可控:深度、内存、暂停点都摆在明面上,出问题能打印整个栈。要不要换,取决于你能不能接受那个一百多兆的隐式账单,以及栈溢出时进程直接消失、连日志都来不及写。Go 的栈溢出最终是 fatal error,recover 接不住,这一点和在堆上分配失败还不一样。把深度上限算清楚,再决定用哪种写法,比背口诀靠谱。
先量,再换。
容器选对,遍历就对了一半。剩下的一半,是知道自己付了什么。