够用的那十几个标准库

够用的那十几个标准库
隔壁老康难度 ★☆☆☆☆ · 前置:包与模块:一个项目怎么组织 | 一句话结论:标准库不用背,它是一只分四层的抽屉,你手上是什么动作,就翻哪一层。
写第一个真正有用的小工具时,我的需求朴素得不像话:把某个目录里的文件全列出来,按大小排个序,打印成一张表。拆开只有三件事,读目录、排个序、打到屏幕上。我当时的做法是打开搜索框,查一句 Go 怎么读目录,抄一段回来,再查一句 Go 怎么格式化输出,再抄一段。抄到第三段才反应过来,这些答案躺在同一个地方,就是标准库,而那个目录我早就打开过,扫了两眼,一个名字都不认识,于是关掉,又回到浏览器。那会儿我以为标准库是给老手预备的参考书,后来发现它更像厨房里那排抽屉,你不知道里面有什么,就会一直去隔壁借盐,借的次数多了,盐罐子放哪儿反倒比自家调料还熟。入门阶段真会碰到的包,撑死十几个。
抽屉只有四层,先认一遍
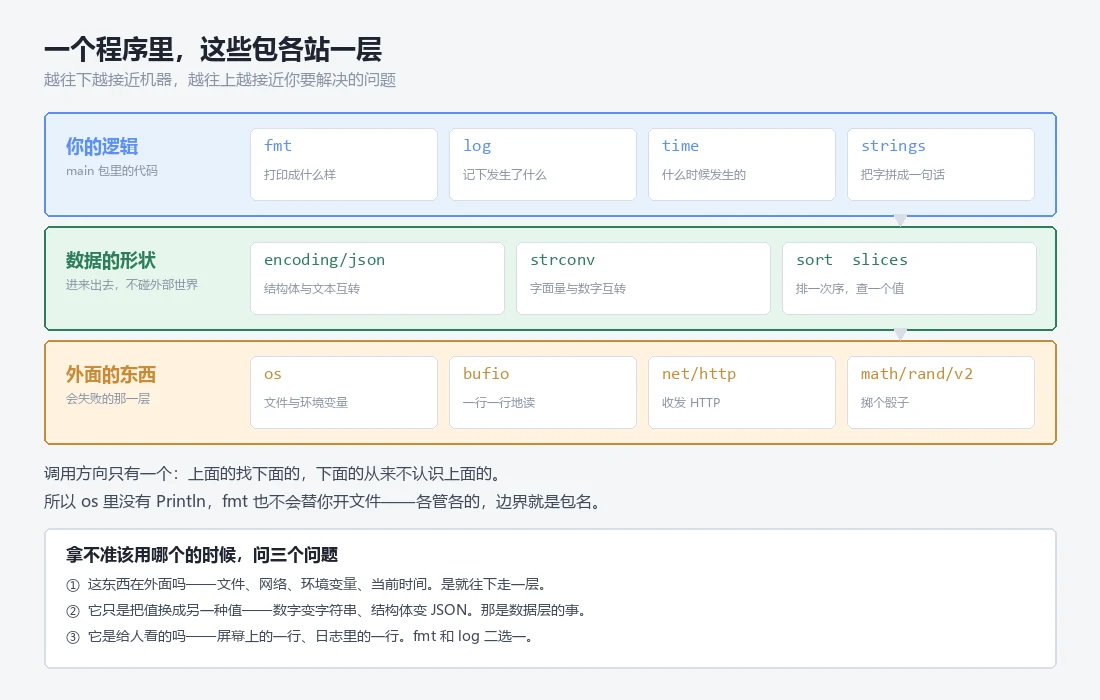
标准库里挂着两百多个包,go doc 不带参数跑一下,列表能刷过三屏。但入门阶段会反复回访的只有十几个,它们也不是按字母排成一列等你背,是叠成四层的。最上面一层是你自己的逻辑,也就是 main 包里的代码,它干的全是给人看的动作,用 fmt 把结果变成字,用 log 把过程记下来,用 time 打个时间戳。中间一层只做值的搬运,strconv 在字面量和数字之间倒手,encoding/json 在结构体和文本之间倒手,sort 和 slices 负责把一堆值排好。底下那层开始碰外部世界,os 摸文件和环境变量,bufio 一行一行地读,net/http 收发请求,math/rand/v2 掷骰子,这一层的函数几乎每个都挂着 error,不是设计者啰嗦,是外面的事本来就不由你定。分层这件事官方文件里没写,是我自己记路用的,你要是觉得别扭,改成按字母排也行,反正真写起来一个函数里四层都在。
| 包 | 一句话它在管什么 | 最先会用到的函数 |
|---|---|---|
fmt |
把值变成给人看的字 | Println Printf |
log |
带时间戳记一行,出事先喊一声 | Println Printf SetFlags |
strings |
在字符串上切、拼、削、查 | Contains Split Join TrimSpace |
strconv |
字面量和数字互相换 | Itoa Atoi ParseFloat |
os |
文件、环境变量、进程参数 | Getenv ReadFile WriteFile |
bufio |
把字节流切成行或者块 | NewScanner Scan Text |
sort |
老一代排序,Go 1.22 起转调 slices | Ints Slice |
slices |
泛型版的切片工具箱 | Sort SortFunc Contains Index |
encoding/json |
结构体和 JSON 文本互转 | Marshal Unmarshal MarshalIndent |
net/http |
起一个服务,或者发一个请求 | NewServeMux HandleFunc ListenAndServe |
math/rand/v2 |
不用先播种的随机数 | IntN Perm |
time |
时刻、时长、格式化 | Now Format Since |
fmt:同一份值,八种打法
fmt 是新手第一个 import 的包,也最容易被当成 println 的替代品,它的核心只有一个函数族,一个格式串加一串值,格式串里的百分号决定这些值怎么变成字。
同一个 point,换着动词看一遍:
1 | type point struct{ X, Y int } |
1 | $ ./fmtp.exe |
%v 是默认样子,%+v 连字段名一起打,%T 打类型而不是值,这三个配着用基本能解决调试时那句这玩意儿到底是什么。%+v 值钱的地方在嵌套结构体,一层层字段名摊开会把整棵树直接印出来,比在调试器里点开三层还快,也比自己写一堆 Printf 拼字符串省事。%q 给字符串套上引号,好处是能看见前后的空格和那些看不见的字符。我调过一个配置文件,就因为某行末尾多了个空格,%s 打出来跟正常行一模一样,换成 %q 立刻现形,那个空格正是键名匹配不上的原因。%d、%s、%t、%f 是最平的四把,%f 默认六位小数,%.2f 收成两位,%05d 里的 5 是位宽,前面的 0 表示不够就补零,%-6s 的负号表示左对齐、不够的地方拿空格垫,%x 打十六进制,调颜色和看协议的时候用得着。
值是死的,呈现是活的。
strings:切、拼、削
strings 里三十多个函数,八成调用落在六个上。Contains 问一句有没有,Split 按分隔符切开,Join 把一段切片拼回字符串,TrimSpace 削掉两头的空白,Fields 按任意空白切,HasPrefix 看开头。
1 | s := " Go,入门,标准库 " |
1 | $ ./strp.exe |
Split 和 Fields 的差别在输出里看得出。strings.Split(s, ",") 切出来的第一段是 " Go",前面那个空格还在,因为它只认逗号。
strings.Fields 切出来只有一段,因为原串里除了两头的空格没有别的空白,它连着把那两个空格削掉了。把 "a b c" 丢给它,会返回三段,中间连续的空格、制表符、换行全被当成同一类分隔符。
这两个切法混着用,结果就是切片长度对不上,所以拿到用户输入先想清楚要不要把空白也算作分隔符。
拼接这件事有坑。我用两种写法各拼一千个字符,各跑一千轮,用 time.Now() 前后掐表,差了一百倍。原因在字符串本身不可变,acc += "x" 每次都新建一个更长的字符串,把旧的整段抄过去再丢掉旧的,拼到第一千次时已经白抄了五十万次。Builder 内部攒的是一块可增长的字节缓冲,只在调用 String() 的那一刻才把那块内存定成字符串,所以那一千次追加都落在同一块内存上,没发生过一次整段搬家。
1 | func plus(n int) { |
1 | $ ./strp.exe |
b.Grow(n) 那行是可选的,不写也能跑,只是内部缓冲会按倍数一次次扩容再拷贝,比写了慢一点,但仍旧远快于 +=。
一百倍,这种便宜没有不占的道理。
strconv:错的那一半也是返回值
名字是 string convert 的缩写,干的活是把一个值的文本形态和值本身互相换。Itoa 是 integer to ASCII,一个参数一个返回值,Atoi 反过来,但它有两个返回值,第二个是 error,这个不对称是有原因的:把一个整数变成字永远不会失败,把一段字变成整数随时可能失败。
1 | fmt.Println(strconv.Itoa(-42)) |
1 | $ ./convp.exe |
注意失败时第一个返回值是 0,不是原来的输入,也不是某种魔法值。这意味着你要是只写 n, _ := strconv.Atoi(s),写错了的那个字符串会安安静静变成 0,程序继续往下跑,然后在别的地方以一种看不懂的方式错掉。我在一个端口号上丢过一个下午,配置里写了 port: 808O,字母 O 混进去,Atoi 返回 0 和一条错误,我把错误丢了,服务照样起来,只是监听在一个随机端口上,客户端的连接全被拒。" 12" 也失败,这点容易踩,Atoi 不替你削空格,要削得先 strings.TrimSpace,ParseFloat 的第二个参数 64 表示用 64 位精度。
能跑通的那一半,fmt.Sprint 也顶得住,就是慢一个数量级。
os 与 bufio:文件是有边界的
os 管的不是操作系统,是程序和操作系统之间那扇门,最常推的三扇是进程参数、环境变量、文件。os.Args 是个字符串切片,第 0 个是程序自己被调起来时用的路径,真正的参数从第 1 个开始,这个设计是照搬 C 的,好处是你能在日志里直接打出自己是哪个可执行文件。os.Getenv 有个陷阱,环境变量不存在时它返回空字符串,不返回 error,也不返回两个值,所以没设置和设成空在它这儿分不出来,要分清得用 os.LookupEnv。
1 | fmt.Println("参数个数", len(os.Args), os.Args[0]) |
1 | $ H10_DEMO=hello ./osp.exe alpha beta |
传了 alpha 和 beta 之后长度是 3,因为第一个位置被程序自己占了。%q 打出来的 \n 是转义后的换行,六个汉字各占三字节,加两个换行正好 20 字节,跟 len 报的数对得上。
读文件失败的样子值得单独看一眼:
1 | $ ./osp.exe |
错误串里带着路径,这不是巧合。os.ReadFile 内部用的是 *os.PathError,它把操作名、路径、底层错误三样裹在一起,所以打出来的东西天然能定位,判断的时候别去比对字符串,用 os.IsNotExist(err),那个函数认的是类型,换台机器换种系统提示它照样对。
文件读进来是一整块字节,要按行处理就得有人替你切,bufio 干的就是这个,它在底下垫一层缓冲,一次从文件里多读一些,再按你的要求一点点吐出来。
1 | f, err := os.Open("poem.txt") |
1 | $ ./bufp.exe |
Scan 返回 bool,跑到末尾就 false,循环自然停,Text 拿当前这一行的内容,换行符已经被切掉了。defer f.Close() 那行你会在每个打开文件的地方看到,它把关闭推迟到函数返回,省得每条提前 return 的分支都写一遍。
那行 token too long 是 Scanner 的默认上限,一行最多 64 KB,超过就报这个错并且停下。这不是 bug,是设计上给的保护,免得有人拿一个没有换行的几百兆文件把它撑爆。真需要读超长行,就把 sc.Buffer 调大,或者干脆别用 Scanner,改用 bufio.Reader 的 ReadString。
time:那个参考时间是人定的
time 最让人懵的是 Format。它不吃 "2006-01-02" 这种占位写法,吃的是一串具体的数字,那串数字是一个真实存在过的时刻,被 Go 定成了模板。那个时刻是 2006 年 1 月 2 日下午 3 点 4 分 5 秒,换算成 24 小时制就是 15 点 4 分 5 秒,年份两位是 06,月份是 01,日期是 02,时区是 MST,星期是 Mon。你把模板里的数字按位置换成想要的样子,它就照着那个位置去填。为什么是 2006 而不是 1970,为什么是 15 点而不是 3 点,这串数字的来历一直没个公认说法,能确认的只有一点,它必须是个具体时刻,不能是占位的符号,否则 Format 和 Parse 就没法用同一套规则。
1 | fmt.Println("完整 ", time.Now().Format("2006-01-02 15:04:05")) |
1 | $ ./timep.exe |
旁边还有 time.Since,它吃一个过去的时刻,返回从那会儿到现在的时长,比自己写两个 Now 相减省事。
我拿它掐了一次循环,也顺手看了几下时长比较和时间零值:
1 | start := time.Now() |
1 | $ ./timep.exe |
70.3657ms 是 Duration,一个 int64 的纳秒数,但它自己带 String 方法,打出来会挑合适的单位,所以 1h30m0s 比 5400s 好读。
比较两个时长直接用大于号,跟数字一样,比较两个时刻别用减完再判正负,用 After 或 Before,语义清楚得多。
零值那行是个提醒。time.Time{} 不是空指针,它是一个具体的时刻,公元 1 年 1 月 1 日,所以 IsZero() 专门用来问这个。结构体里放一个没赋值的 time 字段,JSON 打出来会是 "0001-01-01T00:00:00Z" 而不是 null。
时间不是数字,是数字加上一个你选的口径。
sort 和 slices:后浪推前浪
sort 是标准库里的老人,Go 1.21 加了泛型的 slices 之后它就开始退了。查文档能看到官方注释里明写着,sort.Ints 从 Go 1.22 起只是转调 slices.Sort,而 sort.Slice 因为要吃 any 再反射,比 slices.SortFunc 慢一截,也更容易写错。
1 | a := []int{5, 2, 9, 1, 7} |
1 | $ ./sortp.exe |
两个写法对着看,差别在比较函数。sort.Slice 给你一对下标 i 和 j,你得自己拿着切片去取元素,写成 us[i].Age < us[j].Age,好处是就地改原切片,slices.SortFunc 直接给你两个元素,返回负数表示 x 该排前面,返回正数表示 y 该排前面,所以降序只要把 y.Age - x.Age 换个减法方向。五百万个整数那行是同一台机器上先后跑的,两个数字的差落在误差里,正好印证了文档里那句话。
Contains、Index、Max、Min 这些顺手的小工具也都在 slices 里,配着上表用,比手写循环省事。
json 和 http:值出门的两种方式
encoding/json 的名字靠结构体标签决定,标签是字段后面那对反引号里的内容,json:"name" 的意思是导出成 name 这个键,跟 Go 里的字段名无关。
两处细节值得注意。小写的 private 字段没进 JSON,因为未导出的字段 json 包看不见,这是大小写规则的又一次应用。MarshalIndent 的第二个参数是每行前缀,第三个是缩进串,传空串和两个空格就是常见的两格缩进,只影响好看,不影响解析。
1 | type cfg struct { |
1 | $ ./jsonp.exe |
Unmarshal 遇到类型对不上的字段会报错并且停在那儿,前面已经填好的字段留着,后面没走到的保持零值。
net/http 起一个服务只需要四行。我写了个最小的,监听 18091,后台跑起来,用 python 的 urllib 打了三次,然后让它自己关掉:
1 | mux := http.NewServeMux() |
python 那边打回来的是三行状态码、Content-Type 和响应体:
1 | 200 | application/json; charset=utf-8 | '{"pong":true,"path":"/ping"}' |
服务端自己这边只留了两行:
1 | $ ./httpp.exe |
处理器函数的两个参数一个管写、一个管读,w 是响应,r 是请求。不设 Content-Type 的时候 Go 会自己嗅探,嗅出来是 text/plain,设了就用你给的,第一行那个 json 就是设过的结果。服务停了 那行是 ListenAndServe 的返回值,正常情况下它永远不返回 nil,因为服务只要还在跑这个调用就阻塞着,能被返回就说明有人关了它。
log 与 rand:安静的两件小事
log 跟 fmt 打出来的东西长得像,区别在那串前缀。默认格式是日期加时间,SetFlags 换组合,加 Lshortfile 就把出错的文件和行号也带上,行号是 main.go:13 这种短格式,只有文件名不带目录,比完整路径好读。log 默认往标准错误输出,所以 ./logp.exe > out.txt 重定向不到它,得写 2>,这点跟 fmt 正好相反,也正好说明两个包的定位,fmt 是给用户看的,log 是给排查问题的人看的。
1 | log.Println("默认格式的一行") |
1 | $ ./logp.exe |
math/rand/v2 在 Go 1.22 才落地,最直接的改变是不用再 rand.Seed,全局的那个源现在自动就是随机播种的。IntN(100) 给 0 到 99,想要 1 到 100 就自己加一,掷骰子那行就是这么来的;Perm(5) 返回 0 到 4 的一个乱序排列,做抽奖或者洗牌顺序正好。
1 | $ ./randp.exe |
末行用了 rand.New(rand.NewPCG(1, 2)),只有这种自己造的源才需要给种子,好处是同一对种子每次跑出来的序列完全一样,写测试的时候能拿它复现。
十来个包零零碎碎跑下来,分工其实特别干净。要么在把值变成另一种样子,要么在跟外面换东西,剩下就是往屏幕上写字。下一篇给这些代码补上测试,让它们不靠肉眼看输出也能证明自己是对的。