邻接表还是邻接矩阵
邻接表还是邻接矩阵
隔壁老康难度 ★★★★☆ · 前置:哈希表的 O(1) 有三个前提 | 一句话结论:邻接表的开销跟边数走,矩阵跟点数走;点一多,矩阵的问题不是慢,是装不下。
一句话的需求,一百万个点
需求只有一句话:判断两个用户认不认识。
我第一反应是加索引。关系表四百万行,用户一百万出头,(user_id, friend_id) 上建唯一索引,单次点查压到零点几毫秒。产品听完补一句,推荐页一屏要问二十次。二十乘零点几看着还行,可流量按屏算不按人算,一屏二十次、十屏两百次,缓存没命中的请求全落到一张表上,连接池很快见底。于是换个方向,把整张图搬进进程内存:一百万点、四百万条边,一次装进来,之后每次判断都在内存里完成,不再碰数据库。需求到这一步只剩一个问题,用什么装。
装之前得先算账。
我起先以为 64 GB 绰绰有余。真把点数代进公式才发现,内存这件事跟边的数量关系不大,跟点数关系极大:图里点翻一倍,边的总量可能只涨一点,矩阵的体积却要乘四。日常写业务代码,习惯是估行数、估条数、估请求量,这些量都跟数据量线性挂钩;图的存储是唯一一处点数的平方直接变成字节数的地方,线性直觉在这里一次都没用对。
卡住的地方就在这。
每个点一个 slice 头
Go 里最顺手的写法是 [][]int32。
外层长度 n,每个元素是一个切片头,64 位机器上 24 字节:8 字节数据指针、8 字节长度、8 字节容量。内层只放邻居编号,int32 够用,一百万以内的点编号装得下。无向图一条边写两次,adj[u] 追加 v,adj[v] 追加 u,所以每条边占 8 字节。切片头不存邻居,只是三个机器字,邻居本体在堆上另一块内存——取一个点的邻居,先读头,再跳过去。这个间接层是后面所有差异的源头。
1 | type Graph struct { |
追加的均摊代价是 O(1)。
代价藏在扩容和碎片里。每个内层切片独立扩容,容量按 1、2、4、8 翻倍,装到一半时占用可能比边数多出一截;下面的账只算切片头和边本身,扩容冗余不算在内。一百万个切片头散在堆上,光追指针就够缓存忙的。好在顺序扫邻居很友好,adj[u] 里连续几个 int32 通常落在同一两个缓存行:度 4 一次取指扫完,度 16 跨两个缓存行还能接受,超高度点几十万邻居铺开,扫一遍是一场小型的内存巡航。
矩阵是 n×n 个格子
矩阵的思路更直白:开一块 n×n 的区域,(u, v) 位置为 1 表示有边,0 表示没有。
一个格子可以是一个字节,也可以是一位。
Go 没有原生位数组,得拿 []uint64 拼,第 i 位落在 bits[i>>6] 的第 i&63 位。判断一条边在不在,算一次下标、取一个字、和掩码与一下,三步都是常数时间,跟你这个点有多少邻居没关系。代价是这 n×n 个格子跟边数彻底脱钩:图上只有一条边,矩阵也照样占满。开矩阵之前得先承认,你要为所有可能的点对付钱,不只替真实存在的那几条边付钱。教科书总把矩阵和稠密图绑在一起,因为稠密图里大部分格子是 1,钱花得不冤。
1 | type Bitset struct { |
存进去也快,一次或运算。
矩阵改起来不心疼:加边把位打开,删边把位关掉,没有扩容,没有搬迁,也没有切片头。
内存这笔账,先把单位摊开
先把口径钉死,不然数字对不上。
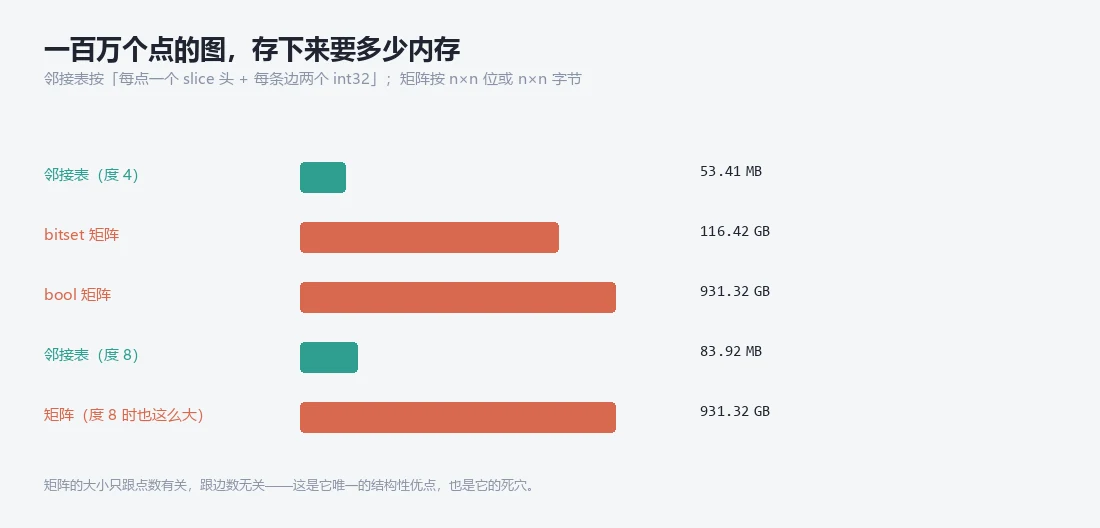
邻接表按每点一个 24 字节 slice 头、每条边两个 int32 算;矩阵按 n×n 位或 n×n 字节算,前者是位图,后者是 []bool。数字都是本机用 Go 按字节统计,再除以 1 048 576 报出来的,所以写作 MB、GB,实际读作 MiB、GiB。数字没上过线上环境,同一台机器、同一个编译器、同一张固定种子的随机图,只换存储结构,这样比出来的差值才有意义。
一百万个点、平均度 4,边数 3 999 987。切片头一百万个,24 字节一个,24 MB;每条边两个 int32,8 字节,四百万条边 32 MB;加起来 56 MB,实测 53.41 MB。同一张图换成位图矩阵,n×n 个位是 10^12 位,除以 8 是 1.25×10^11 字节,116.42 GB。换成 []bool,一格一字节,10^12 字节,931.32 GB。比值 2232.1 倍和 17857.2 倍。这两个矩阵一个字节的边都没存,它们只记点对之间有没有边。
账面 56 MB 和实测 53.41 MB 差的那几个 MB 值得说一句,它正好标出估算的边界在哪。56 是十进制攒出来的,53.41 是二进制摊出来的:56 000 000 字节除以 1 048 576,得 53.4。两个数本来就该这样对不上,跟分配器、跟扩容、跟堆的冷热都没关系。知道这一点,换算时就不会把自己绕进去——写文档报十进制,看监控报二进制,来回换一趟差 4.8%。
倍数已经不用讨论了。
度 8,边数 7 999 930,邻接表涨到 83.92 MB,位图矩阵还是 116.42 GB,比值掉到 1420.5 倍;[]bool 还是 931.32 GB,11363.7 倍。边翻一倍,邻接表跟着涨,矩阵一个字节没动。把点数降一个数量级再看:换成十万个点、平均度 20,边数 1 999 547,邻接表 17.54 MB,位图矩阵 1.16 GB,67.9 倍;[]bool 9.31 GB,543.6 倍。**矩阵的大小只跟点数有关,跟边数无关。**要让矩阵在内存上追平邻接表,平均度得涨到几千,那已经是另一个世界。账算了,数字摆在桌上。
点少一个数量级,矩阵从遥不可及变成勉强能碰。这时候如果图真的很稠、查询真的很密,多花一个 GB 换速度是可以谈的;可十万点、度 20、边数接近两百万的图,邻接表只占 17 MB,矩阵仍然贵六十多倍。
勉强能碰,不等于该碰。
这笔账不写程序也能估。邻接表是点数的 24 倍加边数的 8 倍,n×24 + 2m×4,n 是点数,m 是边数,2m 是无向图一条边存两遍;矩阵是 n×n÷8 或 n×n 字节,前面是位图,后面是 []bool。把自己的 n、m 代进去,两个结果一除就是倍数,误差不超过百分之几,跟实测对得上。我现在的习惯是先手算一遍再动手,手算超过机器内存的八成,后面就不用比纳秒了,先想别的结构,或者把图切小、只装热的那一部分。手算花两分钟,比写完一版再发现分配失败便宜得多。这套算法在评审会上也够用,别人问矩阵多大,我能当场报个数量级,不用背 O(n²) 糊过去。
多数人对矩阵的印象停在 O(1) 查询、O(n²) 空间这句教材话上,真要选的时候,O(n²) 到底多少没人算。n 等于一百万,n² 就是一万亿,位图一位、字节八位,差着八倍。选位图还是 []bool 本身又是一次八倍取舍,跟复杂度没关系,纯粹拿空间换常数。116 GB 还有一层现实问题:多数开发机没有这么大内存,分配本身就失败,测试环境里连压测都跑不起来。
所以矩阵的问题常常不在跑得慢,在第一行分配就过不去。
0.859 纳秒和 13.959 纳秒
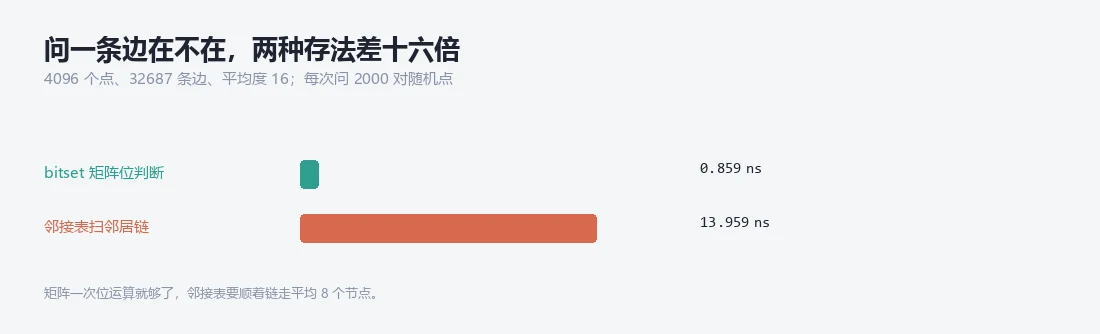
边判定是这么测的:4096 个点,32 687 条边,平均度 16.0,随机抽点对问在不在,一共两千万次,两边命中数对得上。
位图矩阵平均 0.859 纳秒一次;邻接表顺着邻居链扫,平均 13.959 纳秒,16.25 倍。邻接表慢不奇怪,它得把 adj[u] 从头看到尾,平均十六个元素,每个元素一次比较,内存还不一定连续。位图那边只有一次乘加、一次移位、一次与运算,全部在寄存器和一级缓存里完成。命中数一致这个细节很重要,说明两边回答的是同一个问题,差距不是少算了什么换来的。
十六倍听着很吓人。
两千万次是怎么来的,得说清楚,不然这些数字没法复现。做法是把所有待问的点对先打乱,塞进一个 int64 数组,循环从里面往下取,命中时用一个全局计数器累加,最后校验两边的计数器相等。不用随机数生成器,是因为它本身的开销比 0.859 纳秒还大,混进去就把被测对象盖住了;预热也一样,前一百万次丢掉不算,让分支预测器和缓存都进稳态。0.859 纳秒这个量级已经贴近循环本身的开销,再怎么测也只能测到这个精度;13.959 纳秒那边倒是宽裕,主要成本就是十几个不连续的访存。
这套测法只能比出量级差。
放回场景里就没那么吓人。查询密集、图又稠密,矩阵确实能把开销压掉一个数量级,它在稠密图上是正解,这点没什么好争的。前提是装得下。一百万个点,位图 116 GB,还没算跑查询要准备的机器。十六倍只在两边都能跑的时候才有意义,一边连内存都放不下,这个对比就只剩纸面价值。0.859 纳秒和 13.959 纳秒都是单次开销,两千万次换算下来是 17 毫秒和 279 毫秒,塞进一屏二十次调用里,被接口其他开销盖住,根本感觉不到。先问装不装得下,再问快不快。
怎么选,五个问题
第一问点数,五万以下、图又偏稠密,位图可以认真考虑;五十万以上基本别想,除非有几百 GB 内存闲着。第二问平均度,度小于十的图,邻接表空间优势几十倍起步,矩阵再快也补不回来。第三问查询类型,天天问两点连不连、很少枚举邻居,矩阵的常数优势明显;反过来要遍历邻居、跑 BFS、做连通分量,邻接表的顺序访问更顺。第四问图会不会变,插入删除频繁,矩阵改一位就完事,邻接表要 append、要扩容。第五问内存预算,矩阵一次性买断,邻接表按边付费。
五个问题里,前两个筛掉九成场景。
缩成一句话:先算 n×n 要多少内存,算完还有余量,再谈矩阵。
还有 CSR 和边数组
邻接表不是终点。
把一百万个切片头拍平成 offsets 数组加 targets 数组,就是 CSR:省掉每点的 24 字节头和容量浪费,遍历更快,代价是不能动态加点。再省一点,边数组只存 (u, v) 两个 int32,四百万条边 32 MB,适合一遍扫完就扔的场景。两个都是邻接表的变体,思路一样,按边付费。CSR 在数据库和搜索引擎的图索引里很常见,Go 里手写一遍前缀和就能出来。
选型先看内存,再看查询。
这个需求我给了邻接表。一百万点、四百万条边,装进来五十多 MB,一台普通机器就放得下;判一条边要扫十六个邻居,放进推荐页二十次调用里也就几微秒,够用。矩阵的 0.859 纳秒很好看,可它要的 116 GB 我拿不出来,拿不出来的时候,快十六倍跟我没关系。这些代码没上过生产,我只在本机压过两遍,真接进去之后会不会被别的开销盖住,我到现在也没有答案。