前缀检索拿什么换空间
前缀检索拿什么换空间
隔壁老康难度 ★★★☆☆ · 前置:数组到底快在哪 | 一句话结论:十万个词做前缀检索,26 指针的 Trie 内存是 map 的 84 倍、精确查找慢 11 倍,而排序切片加二分比它快 100 多倍——前缀检索不一定非得上树。
搜索框卡在小半秒
内部工具的搜索框,输两个字母就开始往下弹候选,词库十万条,全是从日志里扒出来的域名。同一个父域下面挂着一堆子域,开头的七八个字符常常一模一样。我第一反应是这活该上 Trie,前缀共享,走几步就到,教科书写着的标准答案。那个下午我把第一版敲完,26 个指针的朴素结构,拿一棵七节点的小树手工验过一遍,接上去输两个键,候选框要等小半秒才弹。我当时一口咬定是候选的排序写得笨,或者索引没建全,压根没往结构本身想。
卡住的不是搜索框,是我对这个结构的印象。
同一周还有一件形状相同的事。日志里的域名要归并,同一个父域下的子域合成一条,十万个域名按前缀分桶。分桶也是前缀检索,给定一串字符,把以它开头的 key 全找出来。两件事我用了同一个结构,也踩了同一个坑。
连改法都一模一样。
所以动手之前先量三件事,建起来占多少内存,一千次前缀计数要多久,精确查一个词要多久。
一个节点把一个字符
Trie 的形状简单到一个节点只存一个字符,从根往下走,走过的字符拼成词。词与词共享开头,就共享开头那段路径,一个节点被很多个词借道。十万个词,平均 10.0 个字符,字符总量 1 001 093 字节,展开成一棵字符树,节点数是 708 681。共享只替我省掉三成节点,比我预期的少。十万个随机词,开头撞车的没那么密,指望几个字符就把七成路径合并掉,是想多了。
节点长这样。
1 | type node struct { |
26 个指针,一个 8 字节,208,再挂一个 bool 记这个词到这儿结束。209 不是 8 的倍数,对齐之后是 216,落到分配器那块就是 224 这个尺寸档。单看不算大,乘上 708 681 就变了。光节点本身就奔着一百五十多兆,实测堆增长 151.45 MB,摊到每个词 1588.1 字节。同样十万个词,map[string]bool 只花 1.80 MB,每词 18.9 字节。
空间是按字母表买的,跟数据有多少没关系。这笔账跟实现写得糙不糙无关。26 个槽里绝大多数只用一个,剩下 25 个是 nil,可每个 nil 都老老实实占着 8 字节,那是给将来可能有的孩子预留的位置。
字母表多大,空槽就有多少。换成中文,26 得变成几万,这个结构连编译都过不了,只能退回 map。
| 结构 | 堆增长 | 每词字节 | 节点数 |
|---|---|---|---|
map[string]bool |
1.80 MB | 18.9 | — |
| 排序切片 + 二分 | 1.53 MB | 16.1 | — |
| 稀疏 Trie | 32.95 MB | 345.5 | 708 681 |
| 26 指针 Trie | 151.45 MB | 1588.1 | 708 681 |
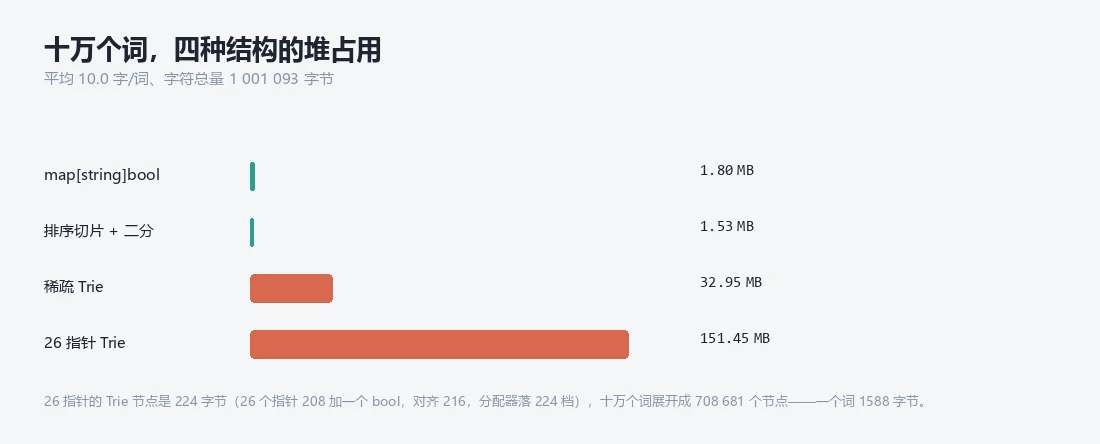
84 倍。
走十步就到,为什么还慢
前缀查询在 Trie 上的复杂度是 O(前缀长度),这条没错。走三个字符三步,顺着指针过去,底下整棵子树就是答案。拿它对比 map 的全遍历,十万个词挨个比一遍,听起来是碾压。一千次前缀计数,每次取一个词的前一到三个字符,四种结构数出来的命中数一模一样,1 300 444,说明大家找的是同一批词,没有谁少算。排序切片 2.51 ms 最快,map 全遍历 803.4 ms 垫底,26 指针 Trie 385.5 ms,只比全遍历快 2.08 倍。
| 一千次前缀计数 | 耗时 |
|---|---|
| 排序切片 + 二分 | 2.51 ms |
| 稀疏 Trie | 121.0 ms |
| 26 指针 Trie | 385.5 ms |
| map 全遍历 | 803.4 ms |
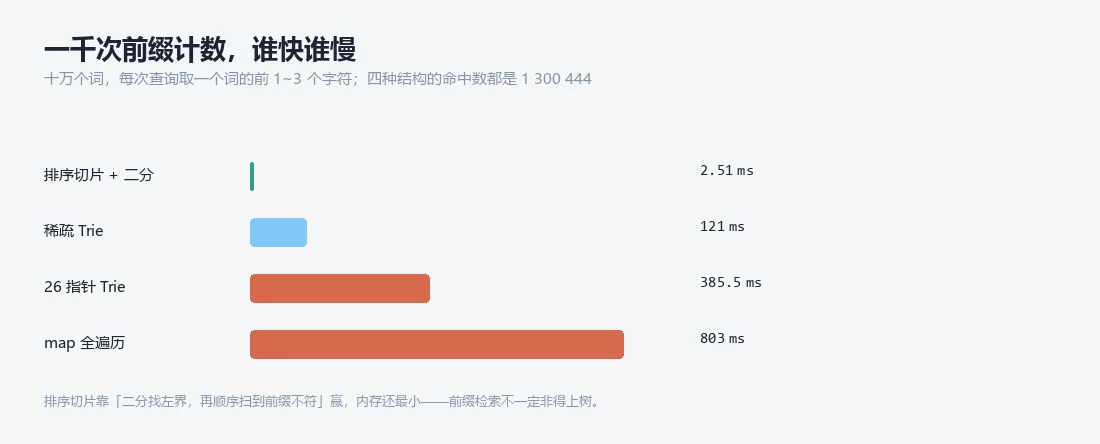
2 倍。
理论省掉的是比较次数,一次都没省掉访存。一个三字符的前缀底下平均挂着一千三百个词,要把它们数出来,就得把那一千三百个节点全走一遍,每个节点都得先从父节点里取出指针再跳过去。151 MB 的堆,节点按插入顺序散在各处,跳一次大概率落在还没进过缓存的一页上。复杂度写的是 O(前缀长度),漏掉了后面那个 O(子树大小),而子树大小通常就是命中数,两项相加,谁大还真不一定。精确查找是另一回事,它不进子树,走十步就该出结果。三百万次,testing.B 跑三轮,Trie 每次 117.1 / 123.8 / 119.6 纳秒,map 是 11.21 / 10.90 / 10.90 纳秒。
| 三百万次精确查找 | 每次耗时 |
|---|---|
| Trie | 117.1 / 123.8 / 119.6 ns |
| map | 11.21 / 10.90 / 10.90 ns |
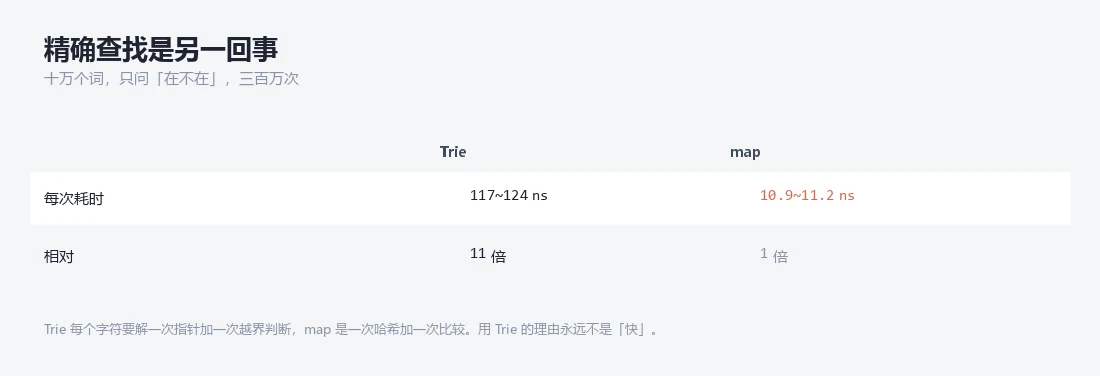
慢 11 倍。
一个 10 字符的词,Trie 要做 10 次指针跳转,每次跳到一个独立的 224 字节节点上。map 是一次哈希、一次桶定位、一次比较。比 10 个字符本来不贵,贵的是把这 10 个字符拆成 10 次互相不挨着的访存。
每一次都要等内存把那一行搬回来,而搬回来的那一行里,只有 8 个字节是下次要用的。
把空槽压掉,内存降到五分之一
第一版改法很自然:26 个槽里 25 个空着,就别用定长数组,每个节点的孩子存成一个按字母排好序的小切片。
1 | type node struct { |
效果跟账对得上。堆增长从 151.45 MB 掉到 32.95 MB,每词 345.5 字节,节点数一个没变,还是 708 681,摊到每个节点约 49 字节,不到原来的四分之一。前缀计数从 385.5 ms 掉到 121.0 ms,比 map 全遍历快 6.6 倍。方向对了,没到终点:121.0 ms 跟排序切片的 2.51 ms 比还差 48 倍,精确查找一点没救回来。慢的根子不在空指针,在节点本身是散的,七十万个节点在堆上撒开,走一步换一页这件事,换成什么子节点表示都一样。
内存这一关过了,速度没有。
再往下压,是把只有一个孩子的节点链合并成一段。Radix 树就这么干,一条没有分叉的路径压成一个节点,节点数从跟字符数一个量级掉到跟词数一个量级,224 那个数就不再是乘数。代价是插入和删除要拆点、合点,代码量翻几倍,边界条件多到容易写错。httprouter 的路由树是这一路的亲戚,它按路径段切而不是按字符切,/user/:id/profile 一整段挂在一个节点上。
排序数组加二分,快一百五十三倍
换个方向想。前缀检索要的其实是顺序,不是树。十万个词排好序,以某个前缀开头的词在数组里必定是一段连续区间:二分找到第一个不小于它的位置,从这里往后扫,扫到不再以这个前缀开头为止。
1 | func countPrefix(words []string, p string) int { |
二十行不到,量出来 2.51 ms,比 26 指针 Trie 快 153 倍;内存 1.53 MB,四种结构里最小,每词 16.1 字节。快的地方能数出来。二分找左界 17 次比较,十七次全落在同一段 1.53 MB 的数组里,缓存从头到尾都是热的。找到之后那一千三百个命中挨着排,往后扫是一条直线读下去,预取器闭着眼都能猜对下一个在哪。2.51 毫秒除一千,一次查询 2.5 微秒,再摊到平均一千三百个命中,每个命中不到 2 纳秒。
另一边是 296 纳秒。
差的是两次访存之间的距离。
排序切片赢的原因不是它聪明,而是它什么都没做:不建索引,不跳转,只把数据摆在一块连续内存里,然后从头读到尾。代价写在插入上。插一个词要挪,最坏挪十万次,append 一次再 sort 一次是 O(n log n)。十万个词全静态,这代价是零,边跑边加词,它就成了主要开销。所以它适合集合基本不动的场合:日志归并、词典、静态路由表、配置里的白名单,共同点是先有一份全集,然后才开始查。
手写秒表,两次差三倍
中间有个插曲。Trie 的精确查找我一开始是手写计时的,time.Now 前后各取一次,跑完打印总耗时。第一次 230.92 ms,第二次 707.80 ms,同一份代码、同一个二进制文件,中间只动了几行打印。
差三倍。
我盯着这两个数看了很久,先怀疑循环没跑满,又怀疑 defer 忘了写。后来用的办法很土:把这段搬进 testing.B 让它自己定轮数,三轮下来 117.1、123.8、119.6,波动 5% 出头。手写计时的问题不在 time.Now 准不准,在它把几百万次操作捆成一坨,中间夹着 GC、夹着缓存被挤出去、夹着别的进程抢核。这台机器上 time.Now 走一格是半毫秒上下,捆的那一坨要是只有几十微秒,量出来的就是噪声,捆得够长,GC 又会跑进来搅一遍。一个数跑两遍差三倍,它就不能拿来下结论。
那棵树值钱的地方在别处
到这里结论已经很不客气:十万个词做前缀检索,Trie 的内存是 map 的 84 倍,精确查找慢 11 倍,前缀计数打不过一个排好序的切片,还得再赔上二十倍内存。
但它没有白活。
先说插入。排序切片插一个词,后面所有元素整体后移一格,最坏十万次,Trie 插一个词走十步,挂一个节点,别的一个都不动。查询的代价只跟词的长度有关,跟集合里装了几万还是几百万个词无关,这条性质在集合一直长的时候才显出价值。再说共享。这一次只省了三成,因为十万个随机词的开头撞得不多,换成 IP 前缀、URL 路径这类数据,共享的那一段长得多,节点数会明显掉下来,224 字节的乘数变小,账就翻过来了。
还有一件是流。数据一条一条流进来,没有全集可排,二分那套起不了手,Trie 来一个挂一个,随时能查。httprouter 要的正是这个,路由边注册边匹配,注册的路径本来就共享前缀,两件事凑在一起,树是划算的。它真正换来的,是插入和查询不再互相牵扯。快是顺带的,有时候还顺带不上。
集合动不动,是第一句
现在选之前我会问三句。集合动不动?很少动,排序切片加二分,内存最小,查询最快,没有理由不用。动得多还要边插边查,才轮到树。第三句问共享率高不高:高,节点数掉得下来,账能算平,不高,比如随机串、哈希值、UUID,每个词自己开一条链,节点数逼近字符总数,224 字节一个都省不掉。还有一句藏在后面:查的是个数,还是要拿到那批词。要拿词,排序切片扫那段连续内存还是最优,只问在不在,map 就够了。
| 场景 | 用什么 |
|---|---|
| 集合静态,只做前缀检索 | 排序切片 + 二分 |
| 频繁插入,边插边查 | Trie 或压缩后的 Trie |
| 只问在不在 | map |
| 前缀共享极深的分层数据 | Radix 树 |
那个搜索框最终换成了排序切片,加了一个写时重排:词库变动攒够一批就重排一次,重建 1.5 MB 的数组用不了几毫秒,代码从一百多行掉到三十行。
树没输在实现上,输在它的节点是散的,而散的东西在今天这台机器上很贵。