一个 bit 当六十四个 bool 用
一个 bit 当六十四个 bool 用
隔壁老康难度 ★☆☆☆☆ · 前置:字符串为什么不能随便改 | 一句话结论:位图把六十四份状态压进一个机器字,省的是地址不是操作,数 1 和装不下的时候它赢,以置位为主的循环里它反而慢十倍。
同一件事我在自己机器上写了两遍。一遍用 []uint64 拼位图,一遍用 []bool,都是一千万个标记,都往里置一千万个位。位图那版 13.17 毫秒,[]bool 那版 1.22 毫秒。
我把两个数抄在便签上,又对着终端核了一遍。
没抄反。
2023 年 6 月我入职,到这会儿写 Go 九个月。这九个月里我对位图的认识一直停在半句话上:一个 bit 存一个状态,六十四份挤进一个 uint64,所以又快又省。前半句是真的,后半句是我自己脑补的。那个晚上量出来的东西只说明一件事,省是真的,快得看它干什么(我先怀疑的是编译器,不是我自己)。
一亿个 bool 是九十五兆
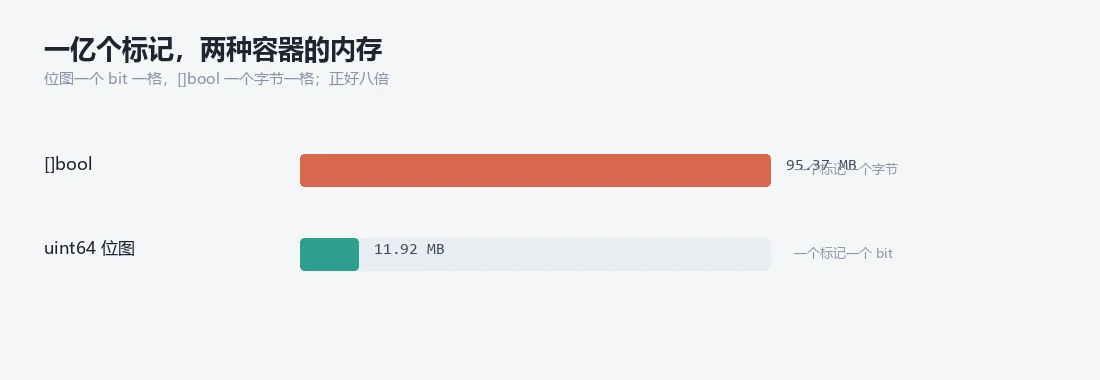
先把内存算清楚。一亿个标记,位图这边是 1562500 个 uint64,一个八字节,加起来 11.92 MB。[]bool 那边是一亿个字节,95.37 MB。
八倍。
这个倍数不是优化出来的,是定义逼出来的。Go 里最小的可寻址单位是字节,bool 占一个字节,你没法让它只占八分之一。位图干脆不承认元素这回事,它只有一块 uint64 数组和一套换算,第 i 位落在哪个字、那个字的哪一位,全靠算。省下来的地方就是从这儿来的。
| 存法 | 一亿个标记占多少 | 里面是什么 |
|---|---|---|
位图 []uint64 |
11.92 MB | 1562500 个机器字 |
[]bool |
95.37 MB | 一亿个字节 |
代价也在这儿。[]bool 取一个元素是一次地址加法,编译器算完直接 load 一个字节;位图取一位要先右移六位拿到字下标,再和六十三做与拿到位偏移,然后移位、掩码,最后才落在那一位上。这几步都是纯算术,算术在今天的 CPU 上几乎不要钱,可它换掉了一次访问这个说法,位图的每一次读写都得先把位置算出来。省八倍内存的账好算,多算几步的账平时看不见,因为单看一行代码,它跟一句 flags[i] = true 差不多长。
看不见的账,得跑起来才看得见。
第 i 位在第几个字里
代码比解释短。
1 | type Bitmap struct { |
i>>6 就是除以六十四,i&63 就是模六十四。1 << (i&63) 造出一个只有那一位是 1 的掩码,|= 把它或进去,& 把它筛出来。没有循环,没有分支,也没有分配。
一句话,Set 是四步,Has 是三步。
Set 那四步里,最贵的是最后一步。前两步是算术,第三步是移位,都只碰寄存器;第四步是写回内存,而写回之前得先把那个字读进来,读完才能或。一条 load、一条 or、一条 store,中间还夹着一次移位,编译器排得再紧,这三条也是有先后的。Has 只有 load 和 and,没有写,所以它比 Set 便宜一截,这也是为什么去重的时候先问一句 Has 再决定要不要 Set,不只是逻辑上更清楚,是它真的少一次写。同一个字里的六十四个位,写哪一位都得动整个字,读的时候也一样,你没法只把一位捞出来,硬件最小的搬运单位是缓存行,语言能给你最小的写单位是字节。
置一千万个位,它慢十倍
| 置一千万个位 | 耗时 |
|---|---|
| 位图 | 13.17 ms |
[]bool |
1.22 ms |
10.8 倍,位图慢的那一边。
这个数摆出来的时候我先怀疑是自己写笨了。把 Set 摊开看,它确实只有那四步,没有函数调用,没有分配,也没有边界检查拖后腿。慢的地方不在写法上。
[]bool 的一次写是一条 store,写一个字节,写完就走,CPU 不用等它落地。位图的一次写是 load-modify-store,读回来的字要等,掩码算完要等,写回去还要占一个 store 端口。更麻烦的是连着置位的时候,前后两次改的常常是同一个字,第二次的读要等第一次的写完成,一条依赖链就这么串起来了。置一千万个位,摊到每一次上是十几纳秒里的一小截,乘上一千万次就是十倍。这个结构决定了它不是为写设计的。
省内存和省写入,在同一个结构上是一件事的两面。这不是实现写得烂。只要它是几个 bit 挤一个机器字,写一位就得读改写,换哪个语言、哪个库都一样。你在教科书上看到的那句位运算快,说的是它不占地方、能整块搬,不是每一次 Set 都比一次字节写好写。
省下来的地方,是从写入速度里抠出来的。
数一亿个位里有多少个 1
反过来量,数字换了个方向。一亿个位,每三个置一个,数里面有多少个 1。
| 数一亿个位 | 耗时 |
|---|---|
| 位图 | 51.2 µs |
[]bool |
1.94 ms |
37.9 倍,这回是位图快。
快在一条指令上。
1 | func (b *Bitmap) Count() int { |
bits.OnesCount64 在 amd64 上直接编译成一条 POPCNT,一个机器字里有多少个 1,一条指令数完。一亿个位是 156 万个字,Count 走一遍就是 156 万次这样的数数。[]bool 那边没有这种指令可用,它得一个字节一个字节看,每个字节判一次真假,真就加一。搬的字节数差八倍,指令条数差得更多。
这里有个反过来的道理。位图不是把每个操作都变快,它是把整个集合当一个东西处理这件事变便宜了。Count 快,原因不在它比 []bool 更懂怎么数,在它能一次处理六十四个状态,而 []bool 只能一次处理一个。置位属于必须一位一位改的那一类,数 1 属于能整块处理的那一类,同一个结构在两边站的位置正好相反。后来我复盘这次的数字,发现判断一个结构快不快,先得看清楚手上这段代码在它身上是整块的活还是一位的活:整块的活它赢,一位的活它陪跑,而同一个结构身上这两种活往往是一半一半。
凡是能整块处理的场合,位图都占便宜。同一个结构,两个方向。
三百秒,基准被自己跑死了
数字出来之后我想给一亿个位全部置一补一个基准,写的是最直白的那版,循环体里一次 Set。跑 go test -bench,屏幕上迟迟不出数,五分钟之后进程被杀掉。
我以为是死循环,加了几行打印,第二次跑还是一样。
原因在 testing 的校准。它从 b.N = 1 开始,跑一轮,看这一轮用了多久,不够长就把 b.N 往上翻,翻到一轮能填满它要的时间窗为止。单次 Set 只有几纳秒,它就得把 b.N 翻到上亿。麻烦在于这份基准每跑一轮都要从头来一遍,位图清空,一亿个位重新置。b.N 每翻一倍,这一轮的实际工作量就多一截,校准器拿上一轮的耗时算出来的下一个 b.N 又偏大,于是下一轮更慢,它越调越远,永远够不着那个一秒。校准器假设的是每轮的活固定、只有轮数在变,而这份基准里两样一起变,那个假设一破,收敛就没了指望。
它到底翻到了第几轮,我没看见。我看见的只有最后那行超时(现在看,那五分钟不算白等)。
改成手工计时,固定轮数。
1 | func timeSetAll(bm *Bitmap, total, rounds int) time.Duration { |
二十轮取平均,再跑两百轮取平均,两个数落在同一个量级,几秒钟出结果。
切片扩容那篇量单次 append,屏幕上打出 0 纳秒,那是秒表分辨率不够,事做完了指针还没动。这一篇是另一头,操作太便宜,校准器为了凑够时长把轮数往上翻,翻到自己都收不住。两个错误看着相反,根子是同一个:基准框架假设一轮能跑出个像样的时长,而这个假设在太短和太便宜两头都不成立。
秒表不是万能的,轮数也不是。
一千万个 id,十一兆装得下
真正让我决定用它的是另一个场景。一千万个 id 要去重,值域是 0 到一亿。位图按值域铺开,一亿个位,11 MB,一千万个 id 全部装得下。
换成 map,账按 key 的个数算,一千万个 key 就是一千万份键值对,跟值域多宽没关系。位图反过来,账按值域算,跟里面装了多少个 id 没关系。值域窄、key 稠密的时候,这笔账划得来。
去重的代码就两句:先问 Has,不在就 Set,在就跳过。没有哈希,没有链地址,也没有扩容。一千万个 id 打进去,最后 Count 一下就是去重后的个数,而这一步只有位图能白拿,map 还得遍历一遍数 key。位图把存和数合成了一件事,你数它的时候,数的是结构本身,不是另建的一份索引。这个好处在我第一版里完全没看出来,那版我另外维护了一个计数器,每次 Set 成功就加一,后来才发现根本没有必要。
前提是 id 能直接当偏移用。非负整数最好,负数先加个偏移;要是字符串或者六十四位的哈希值,得先哈希到一段位上,几个哈希函数一起看,那就是布隆过滤器了。位图是它的地基,误判率那套东西到时候再说。
能直接当地址用的 key,才有这个福气。
该换回 []bool 的时候
第一种,写多读少。程序里九成操作是置位,数 1 一年跑不了几回,那 10.8 倍的慢是净亏,省下的那部分内存未必值这个钱。
第二种,值域太宽。id 是雪花算法出来的六十四位整数,最大值能到十的十八次方,你不可能按值域铺位图。这种时候要么先哈希,那就进了布隆过滤器的地盘;要么老老实实排序去重,或者用 map。位图的大小跟着值域走这件事,在窄区间里是优点,在宽区间里就是致命的,你的 key 只要有一个碰到十的十八次方,那块内存就得铺到十的十八次方位,而实际上你可能只存了一百万个。
第三种,你要存的不止是在不在。一位只有两个状态,你还想记次数、记时间、记来源,一位装不下,往上加位宽,那就不是位图了,是一个压缩过的数组。我最早拿它记过每篇文章有没有被读过,后来又想在旁边记一个阅读次数,才发现这条路走不通:次数得另开一块内存,读的时候还要把两块对齐着看,绕了一圈比直接用 map 还啰嗦。
第四种,集合本来就小。几万个元素,[]bool 也就几十 KB,塞进二级缓存还有富余,位图省的那点地方换不来什么,多出来的移位和掩码倒是实打实的(这话我跟人说过一次,被笑了半天)。
我现在选它之前会先问三个问题:这个 key 能不能直接当地址用,值域铺开要多少内存,这段代码是写得多还是数得多。三个里有一个答不上来,我就先用 map 或者 []bool,等量出来再说。这三个问题是我把三月那天晚上的数字抄在便签上之后自己攒出来的,顺序也是改过的:一开始我把内存排在第一位,后来发现值域宽度才是真正决定它能不能用的那条线,内存只要够就够,值域一旦铺不开,后面怎么调都没救。所以现在先问地址,再问值域,最后才轮到读写比例,前两条过不了,第三条问不问都一样。位图换来的不是速度,而是地方。