函数:多返回值是常态
函数:多返回值是常态
隔壁老康难度 ★☆☆☆☆ · 前置:三个控制结构:if、for、switch | 一句话结论:Go 的函数把返回几个值、每个值叫什么、出错算不算正常返回,全都写进签名那一行里,读完那一行你就知道该怎么调它,少接一个值编译器会当场拦住你。
我写 Go 交的第一笔学费,交在一个返回值上。那时候我在写一个小工具,要从一份名单文件里读名字,os.Open 敲下去,编辑器一口气补出 f 和 err 两个变量,我照着补全把它们都接住了,下一行写 f.Read(buf),回头一编译,红字来了,declared and not used: err。我盯着那行字看了很久,心里想的是,我不想要这个错误还不行吗,我明明知道它不会出事。后来才明白,Go 压根没打算给你忽略它的机会,它只是留了一个不出声的办法,那个办法是一个下划线。它从一开始就把可能出错当成返回值的一部分,摆在你面前让你自己分拣。我把这段经历搁在最前面,是想让你先接受一个别扭的设定,剩下的九节全都在拆同一件事,签名那一行到底写了什么。
函数签名,从右往左读
先看最短的那个。func add(a, b int) int 这一行,我起初是从左往右读的,读到 a 以为它自带类型,看到 b 后面那个 int 才反应过来,两个名字共用一个类型,中间那个逗号把它们绑成一串,这种写法在 Go 里遍地都是,省下来的字母是习惯。会错这一处是因为别的语言大多把类型写在名字前面,眼睛扫过去,第一个词后面没跟着东西,就以为漏了什么。倒过来读反而更顺,末尾那个 int 是它交回来的东西,括号里的 a, b int 是它要的东西,开头的 add 是它叫什么,三块信息位置固定,顺序不变,看多了扫一眼就知道该怎么调它。反过来说,Go 的签名里不写类型以外的修饰,没有 const、throws、async 这些词,好处是一行读完,代价是它会不会阻塞、会不会改你的值,得看实现。我后来养成一个习惯,看一个陌生函数先看括号后面那半截,判断它值不值得调,再看括号里面,判断要准备些什么。这个习惯在翻标准库源码时特别管用,光看签名就能把九成的函数划掉。
1 | func add(a, b int) int { |
1 | $ go run . |
return 后面算出来的 7,直接落到末尾那个 int 的位置上。函数体只有一个出口,你走到那儿就得交得出东西,这一点比那种悄悄返回一个空值的设计省心得多。括号也能加在返回类型上,写成 func add(a, b int) (int),编译能过,可这对括号 gofmt 不认,它会动手删掉,我试过一次,输出是这样的:
1 | $ gofmt -d main.go |
签名那一行看懂,调用那边的写法就定死了。
多返回值不是一个东西
(int, int) 这个括号,我当初以为它是个元组,一个整体被搬来搬去。不是。Go 里没有元组类型,(int, int) 只说明这个函数往外递两样东西,两样各自有类型,谁在前谁在后是约定,不是包装。这句话听着像咬文嚼字,可它决定了不少事,比如为什么你不能把 (int, int) 存进一个变量。除法和取余是最好的例子,一次计算给出两个结果,拆成两个函数等于白算一遍,多返回值就是为这种场面准备的。
这就是它存在的全部理由。
1 | func divmod(a, b int) (int, int) { |
接的时候有三种办法,都塞进一个 main 里能一起看清。两个都要就写 q, r := divmod(17, 5)。只要商,另一个位置填下划线,q2, _ := divmod(17, 5)。一个都不留,也可以把调用整个当成参数递给下一个函数。
1 | func main() { |
1 | $ go run . |
第三种值得多说一句,因为它打破了一条你可能会自己总结出来的规矩。把调用塞进一个已经有别的参数的位置,编译就过不去,红字的意思是那个位置只收一个值,你塞了两个。可 fmt.Println(divmod(17, 5)) 不报,因为它后面没有别的参数,两个值正好按顺序填进两个位置,打出来是 3 2,中间一个空格。看着像一次打了两样东西,其实是两个值各打各的,那个空格是 fmt.Println 自己加的。
1 | .\main.go:10:24: multiple-value divmod(17, 5) (value of type (int, int)) in single-value context |
只有左边一个坑的时候,报的是另一句,左边一个坑右边两个萝卜,编译器数给你看。补一个逗号,或者补一个下划线,二选一。
1 | .\main.go:10:7: assignment mismatch: 1 variable but divmod returns 2 values |
下划线不是扔垃圾的地方,它写在那儿等于告诉后来读代码的人,这里我确认过是不要的。返回值也可以直接丢掉,add(3, 4) 单独写一行不赋值,编译照过,Go 不吭声。只是留着一个没人接的返回值是有代价的,后面改这个函数时,你得自己想清楚还有没有别的地方依赖它。
值可以不要,签名还得照写。
命名返回值,和那个裸 return
返回值的类型前面可以给名字。func split(sum int) (x, y int) 等于在签名里先声明了两个变量,函数一进来它们就存在,值是零,你可以直接往里面赋值,return 后面什么都不写,Go 把这两个变量当时的值交出去,这种写法叫裸 return。它有它的好处,函数里几个分支都能流到末尾的时候,不用每个分支重复写一遍返回什么。麻烦在于别人读你的函数,得翻回第一行看返回值到底叫什么名字。我在一个长函数里吃过亏,中途加了个 if,里面顺手写了 x := 111,跑出来数不对,查了半天才发现那个 x 是个新变量,把返回值的 x 盖住了。:= 在同一个作用域里重复声明会直接报错,可它一旦落在更内层的大括号里,就是一个全新的变量,编译器也觉得你没做错什么。后来我养成了两个习惯,一是函数一长就把命名返回值换成显式的,二是写完 := 就顺手看一眼左边那个名字是不是已经在外层出现过了。
1 | func split(sum int) (x, y int) { |
1 | $ go run . |
那个被遮蔽的 x 单跑一次看得更清楚,if 块里改了,块外面还是老样子:
1 | func split(sum int) (x, y int) { |
1 | $ go run . |
error 也是返回值
错误在 Go 里不是意外,是返回值。half 这个函数把奇数当成一种失败,签名写成 (int, error),前一个位置放结果,后一个位置放错误,nil 表示这一回合没出事。注意出错那一支里第一个位置并没有被跳过,你还是得往里塞点什么,我塞的是 0,塞别的也行。这个约定不是编译器强制的,是所有人一起守出来的,守到后来连 go vet 都开始替你查。
位置排好,套路就统一了。
1 | func half(n int) (int, error) { |
1 | $ go run . |
调用方那段是模板。h, err := half(10) 之后紧跟 if err == nil。换成 half(7),err 里有话,打出来就是 fmt.Errorf 里那串字,同一个分支里再打 h,拿到的是 0,这个 0 不是我特意设的,是 return 0, ... 里那个 0 原样传出来。
error 永远排在尾部,这条不成文的规矩全 Go 都在用。位置固定以后,if err != nil 就长在每一处调用的正下方,扫一眼能数出这个函数还有几处没处理。造错误有两个常用工具,errors.New("名字不能是空的") 给一句死话,fmt.Errorf 能把变量塞进句子里。
错误不是意外,是那个位置本来就得填。
传进去的是一份复印
Go 的参数是值传递,这四个字的意思很直白,调用的时候实参被复制一份递进去,函数里改的是那份复印件,改不到外面。这条规则我在整数上从没搞错过,因为函数里改一个 int 本来也没什么可改的。真正让我栽跟头的是切片,s[0] = 99 外面看得见,s = append(s, 100) 外面看不见,两行函数体,两种结果,我当初盯着这段输出看了半天,以为自己发现了 Go 的一个设计缺陷。我拿两个函数并排跑过一遍,一个收切片,一个收整数,输出上下摆着。
1 | func modify(s []int) { |
1 | $ go run . |
复印这个说法得说清楚一点。切片本身是个小结构,一个指针、一个长度、一个容量,递进去的是这个小结构的复印件,可它里面那个指针指向的底层数组,跟你手上用的是同一块,所以改元素改的是同一块内存。append 一旦要扩容,会在别处要一块新地方,把指针换成新的,复印件上的指针变了,外面那个还是旧的。真要改外面的东西,把地址递进去,func bump(p *int) 里写 *p = *p + 1,调用时写 bump(&n),n 就变了。
改不到外面不是 bug,是这份复印件。
三点省略号,收起来和摊开
参数类型前面加三个点,这个参数就变成了收件箱。这一步的意义在于你不用预先知道会有几个东西递进来,调用方想给一个给一个,想给一百个给一百个,函数里拿到的就是 []T,取长度、遍历、传给别人都不需要特殊处理。func sum(nums ...int) int 里的 nums 在函数体内就是一个 []int,长度看你外面塞了几个。三种调法的差别全在 len(nums) 上,sum() 一个都不给,nums 是空的,而且它连 nil 都成立,sum(1, 2, 3) 给三个,长度就是 3,手上已经有一个切片的时候写成 sum(s...),三个点挪到调用这一侧,意思是把这个切片摊开,一个一个塞进去。打印的时候我特意把 len 和 nil 一起打出来,因为这俩在空的时候表现不一样,光看长度是 0 会以为它们是一回事。还有一处容易忽略,s... 不复制那个底层数组,函数里改 nums[0],外面那个切片的第一个元素跟着变,改成逐个元素传进去就改不到了,那样递的是三个副本。
1 | func sum(nums ...int) int { |
1 | $ go run . |
刚才说不复制那处,我单独验过一次:
1 | func poke(nums ...int) { |
1 | $ go run . |
defer 是记账,不是收尾
defer 后面那句话,不会当场执行。
它只是被记下来。
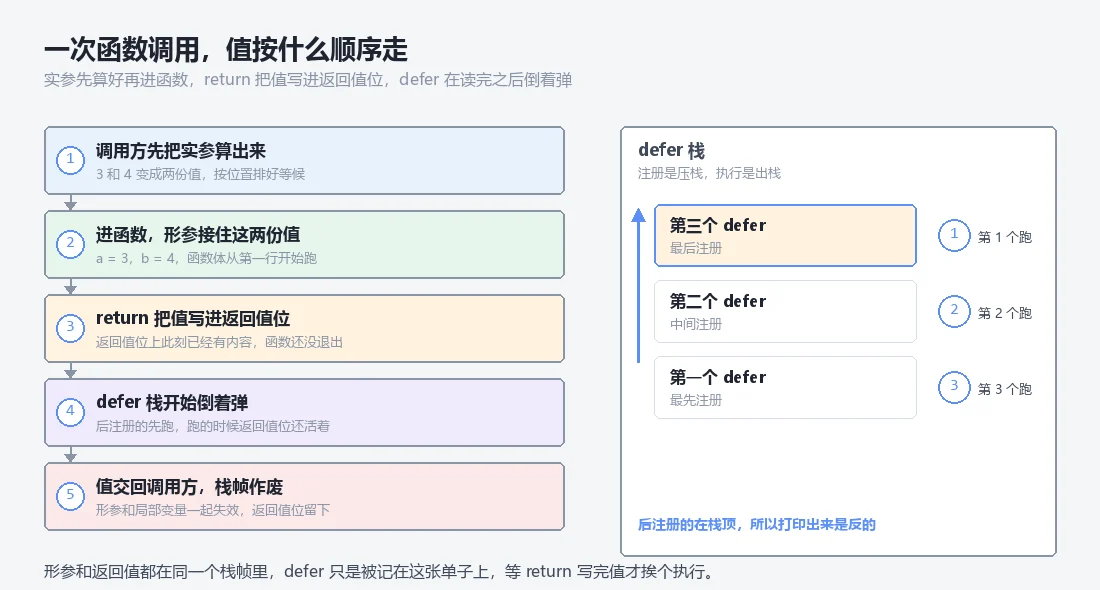
它被记在一张单子上,等函数要退出了才挨个跑。我起初把它当成把代码挪到函数末尾的另一种写法,用了一阵才发现顺序是反的,而且这个反不是偶尔反,是必然反。defer 是往栈上压,退出的时候从栈顶往下拆,压得晚的先出来,你写第一行的那句反而排在最末尾。这个反序有个实际后果,如果两条 defer 之间有依赖,后注册的那条先跑,那先注册的就得写得晚一点。
1 | func order() { |
1 | $ go run . |
输出里名字叫第一个的那句排在了尾巴上。天天有人被这个反序绊一下,记住一句话就够,压得晚的拆得早。
真正好用的是跟资源配对。打开一个文件,下一行就写 defer f.Close(),中间无论你写多少行、在哪一行提前 return、甚至哪一行 panic 了,关闭这一步都会跑到。这比在函数尾巴上补一行 Close 可靠,那一行会被提前的 return 跳过,defer 不会。
有个细节我踩过一次,defer 那行的参数是在注册的那一刻就算好值的,不是执行的时候。x := 1 之后写 defer fmt.Println(x),再把 x 改成 2,打印出来是 1。想让它读到改变之后的值,得包一层匿名函数,让取值推迟到执行那一刻。
1 | func argSnap() { |
1 | $ go run . |
命名返回值上还有一处更绕的。func f() (n int) 把返回值变成了一个有名字的变量,return 先把值写进这个变量,写完才轮到 defer 跑,所以 defer 里改 n,改的是已经写好的那个返回值本身。
1 | func f() (n int) { |
1 | $ go run . |
同样的写法换个地方,力道就没了。h() 返回的是普通 int,局部变量 n 在 return n 那一刻已经被复制出去,defer 再 n++,动的是那个马上要消失的局部变量。
它改的到底是谁,值得多问一句。
函数可以当参数传
函数类型也能写在参数位置上。func apply(f func(int) int, v int) int 里,f 的类型是 func(int) int,一个吃整数吐整数的东西,具体干什么,调用的时候再定。这种参数在标准库里到处都是,排序、过滤、遍历都是这个形状,你给它一段逻辑,它替你套在每一个元素上跑。
1 | func apply(f func(int) int, v int) int { |
1 | $ go run . |
函数还能当场写一个,写完直接调用,func() { ... }() 末尾那对括号就是调用,匿名函数不落名字,定义完立刻执行。它拿到的是外面那个 n,改的也是同一份,所以出了大括号再看,n 已经变成 21。
递归,自己调自己
递归就是函数体里再叫一次自己,前提是得有个出口,否则它会一直叫下去,直到把栈撑爆,报错里那个词是 stack overflow。阶乘是最省事的例子,fact(5) 等于 5 乘 fact(4),一路乘到 fact(1) 交回 1,回来的时候再一层层乘上去,去程压栈,回程出栈。写递归的时候我习惯先把出口那一条写掉,再写递归那一行,顺序反过来的话很容易忘了出口,然后对着一个跑不完的程序发半天呆。
1 | func fact(n int) int { |
1 | $ go run . |
斐波那契更直白,每一项都是前两项的和,写成两行就完事。不过这个版本慢得离谱,每次调用都把自己劈成两个,重复计算堆成指数,我在自己机器上掐过表,fib(40) 用了三百多毫秒。下一篇是数组、切片、map,函数这边的事先讲到这里,那三样东西装的是函数要处理的数据,两边凑齐了,日常的代码基本就能写下来。
1 | func fib(n int) int { |
1 | $ go run . |