GMP 是三个字母,也是 Go 为什么能扛住并发
GMP 是三个字母,也是 Go 为什么能扛住并发
隔壁老康难度 ★★★★☆ · 前置:一个 goroutine 只要 604 字节,但这不等于免费 | 一句话结论:G 是装着栈和待执行函数的任务,M 是真正在物理核上干活的系统线程,P 是 M 必须先拿到的那张票,三者一旦错位,goroutine 就不再便宜。
1 | SCHED 0ms: gomaxprocs=32 idleprocs=27 threads=7 spinningthreads=1 needspinning=0 idlethreads=0 runqueue=0 [ 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 ] schedticks=[ 3 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 2 3 ] |
1 | GODEBUG=schedtrace=1000 go run main.go |
这份输出是我写了个最朴素的程序跑出来的,一个 main 函数里什么都不干,跑的时候把调度器追踪打开,就是上面那条命令,让运行时每秒打一行快照。同时打印三个数,这三个数回答的是三个不同的问题:
| 打印的东西 | 值 | 回答什么 |
|---|---|---|
GOMAXPROCS(0) |
32 | 同一时刻最多几个 M 在跑 G |
runtime.NumCPU() |
32 | 这台机器有几个逻辑核 |
runtime.NumGoroutine() |
1 | 现在有几个人在等活干 |
NumGoroutine 在启动那一刻是 1,程序刚起来只有一个主 goroutine,这一点和快照里那一片零对得上。一上来就是一堆字段,第一次看大概只认得 gomaxprocs 这个词。这行字其实分两半,左边那一小段是身份,回答这个进程手里有多少额度,右边那一大片是分布,回答额度此刻被用得怎么样。这行快照我第一次认真看,是因为一个批量转码的小工具跑起来比我预想的慢,CPU 又没吃满。我把它挂上调度器追踪盯着看了很久,眼睛一直钉在头一个字段上,看 gomaxprocs 那个数在不在动,后面方括号里那三十二个零一次都没看过(现在想想,那三十二个零才是当天最该看的地方)。最后发现毛病不在 goroutine 多,在我把 GOMAXPROCS 当成了线程池的大小,在启动脚本里把它写死成了一个远小于核数的值。后来反过头去看这台机器,三十二核,P 只有几个的意思就是同一时刻最多几个 M 在跑 G,剩下的核在边上看。改回默认值以后同一份输入快了不止一点,快多少我没有量过。
那是我第一次意识到,调度器那几个参数管的是额度,跟调优偏好没什么关系。
这篇讲三个字母,以及它们怎么配合。
三个东西各自不难记,难的是把一行快照里的数字和它们对上号,所以我先讲怎么读那行字,再讲它们为什么这么排,先看形状,再认名字。
一行快照,左边那半是身份
SCHED 0ms 是程序启动到这一刻的毫秒数,零就是第一行,还没跑满一秒,gomaxprocs=32 是 P 的数量,和 GOMAXPROCS(0) 打出来的 32 是同一个数,也和 NumCPU 一致,说明这台机器上没有设过环境变量,运行时按核数取了默认值。
idleprocs=27 是当下空闲的 P,二十七个 P 手上没有活,跟 gomaxprocs 差着的 5 就是正在用的那几份。这一格我盯过一阵,程序闲着的时候它总差那么一点,不会贴满,因为主 goroutine 自己就占着一个 P。
左边那串名字我对着文档一个个认。
threads=7 是此时此刻操作系统线程的总数(也就是 M 的数量),它不等于 P 的数量,也不受 GOMAXPROCS 限制,程序刚起来只有主 goroutine 要跑,运行时没有必要把三十二个线程一次开齐。
spinningthreads 是正在自旋找活干的线程数,这里是 1,needspinning=0 说的是运行时觉得还不需要再加一个来转,idlethreads=0 是闲着没事干的线程数,两个 0 摆在一起不是巧合,有人在转,没有人在闲。runqueue=0 是全局队列里的 goroutine 数,空的。
threads=7 这个数为什么正好是 7,我没弄明白。运行时按什么条件决定多开一个线程,我翻了两处文档没找到直接的说法,快照又只给结果不给理由,这一条先挂着。
我把两行输出并排贴在一起看,方括号里那三十二个数字是每个 P 的本地队列长度,一个 P 一个数,从左往右按编号排,此刻全是零,说明没有任何一个 P 手里压着待跑的 G,程序刚起来,活还没造出来。
最后那个 schedticks 也是三十二个数,记的是每个 P 被调度的次数,头一个 P 是 3,最后一个也是 3,中间那些全是 0,看着像三十二个位置里只有两头在动。
这些字段跑起来以后只有两处会剧烈变化,一处是 runqueue 加上后面那对方括号,另一处就是 schedticks。队列长说明活多,调度次数偏说明活不匀,量大了可以加机器,分布歪了只能改代码。
G 是任务,M 是线程,P 是那张票
G 是 goroutine,是运行时眼里一件待办的事。它里面装着一小段要执行的函数,装着一个从高地址往低地址长的栈,装着一个指示当前指令走到哪里的位置,还装着一个状态,说明自己此刻是可运行、正在跑、还是在等锁等 channel。
你看不见它,只能通过 go 关键字造一个出来,造出来之后它自己不会动,必须有人把它捡起来跑,跑的时候它占着一个 M,而 M 又必须手里有 P,这条链子少一环都动不了。这就是为什么 goroutine 的便宜是有前提的,前提是有人愿意为它付出一个线程的位置。
(这个栈什么时候会挪到堆上去,是逃逸分析管的事,我在变量到底在栈上还是堆上那篇里记过,这里不岔过去。)
我那次是为了搞清楚一个 goroutine 迟迟不跑的问题,才把这三个结构体的定义从 runtime2.go 里翻出来对着看。g 里的字段大部分我都不认识,只认得出栈和状态两块,p 里的字段分成三大团,一团讲队列,一团讲内存分配用的缓存,还有一团讲状态。
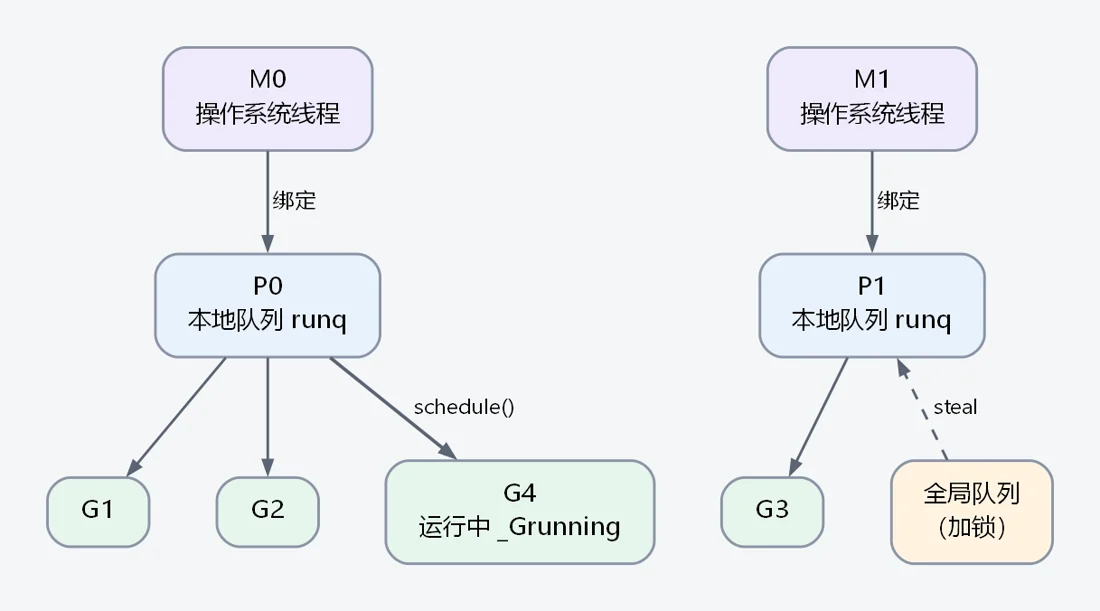
M 是操作系统线程,是真正干活的东西,运行时的代码最终都要落在某个 M 上执行,线程本身归内核管,谁先拿到 CPU 是内核说了算,Go 只能顺着这股力量走。我后来在 ps 里看过一次,线程那一栏能对上的名字没几个,其余的长得都一样,那一串才是 M 的真身。
P 是处理器上下文,三个里最不直观的一个。它不是 CPU,也不是线程,它是一张许可证,里面装着本地可运行队列、内存分配用的高速缓存、以及各种调度相关的状态,M 必须先拿到一个 P 才有资格执行 G,没有 P 的 M 只能挂在那里等,等的时候它不干活,也不占核(这一点我当时死活没转过弯,一直以为线程多了就该快)。上面那张图里三个框从左到右就是 G、M、P 的顺序(我一开始以为这三个框是随便排的,后来跑了几次快照才发现顺序不是随手排的),左边那些是被派出去的任务,中间是执行任务的线程,右边那张票决定谁有资格动。
所以三个东西的关系可以压成一句话,M 绑上 P,P 的本地队列里排着 G,M 从自己那个 P 的队列里取 G 来跑。线程贵,协程便宜。
这句话解释了三个数量的差别。G 可以几十万个一起存在,M 通常只有几十个到几百个,P 默认等于 CPU 核数,三者差着好几个数量级(我头一回看到几十万个 G 那个数,还以为打印了两次)。贵在哪儿也就清楚了,G 的栈按需才长,M 背后是真的内核线程,P 的数量是核数给的,一样比一样重,谁稀缺谁就决定数量。
把 G 和 M 比是最容易比明白的,一个 G 初始栈很小,一个 M 背后是一整块内核栈和一次上下文切换的开销,两者的代价不在一个量级上,所以运行时敢让你随手 go 一下,却不敢随手开一个线程。
本地队列排在 P 身上,满了才往全局扔
P 的本地队列是一个定长的环形数组,绝大多数新造出来的 G 都先落在这里,因为这个位置不用加锁。一个 M 要从队列里取 G 的时候,先看自己绑的那个 P,从队头取走一个,整个动作没有锁也没有原子操作,快得像从数组里拿一个元素出来,取完只要把队头的位置往后挪一格。本地队列满了以后,新来的 G 会被整个搬到全局队列去,全局队列由所有的 P 共享,进出都要拿同一把锁,锁这个东西,四个 P 抢和三十个 P 抢,代价完全不一样。为了看清这一下,我写了个只会造 G 的死循环,把快照挂在旁边一行一行地看,本地队列那一格涨到某个高度就不再涨了,再往后是 runqueue 那一格开始跳,队列确实是从本地溢到全局的,并没有在本地一直堆下去(那会儿我还担心过那一格是无上限的,怕它把内存吃光,看了几行才放心)。全局队列是兜底用的,它保证活不会丢,也保证在没有哪个 P 愿意接的时候还有一个地方能排队,代价是进出都要抢同一把锁。我一开始以为 P 就是线程,因为两者经常一对一,看久了就以为是一个东西,后来把快照里 threads 和 gomaxprocs 摆在一起才发现,threads=7 和 gomaxprocs=32 是两个独立的数,程序刚启动只有主 goroutine 在跑,运行时没必要开三十二个线程,P 是逻辑上的并行额度,M 是物理上的执行资源,额度和资源不要求相等。队列是有方向的,从尾巴进,从头上出,先进先出在这里不只是公平,还让排在后面的活少等一会儿,这个顺序本身就是内容,谁先进来谁先被捡走,改一下方向,整个调度的脾气都会变。
偷一半,不偷一个
一个 P 的本地队列空了,M 不会立刻睡着,它会去别的 P 那里偷。这件事叫 work stealing,偷法有讲究,不是拿走一个,而是拿走一半。假设对方的队列里有八个 G,偷完之后对方剩四个,自己拿四个。
偷一个的话下次空了还得再偷一次,而每次偷都要付出访问别人队列的代价,偷一半把这份代价摊薄了,也顺手把负载往均衡的方向推了一步。这个策略在队列很长的时候特别划算,偷一次能撑很久,队列很短的时候也不会因为只拿一个而反复跑腿。
(那阵子我一直以为偷得越多越快)
spinningthreads 转着找活,不是浪费。
先偷本地,再偷全局,最后才去看网络轮询器里有没有活,这个顺序是固定的,按代价从低到高排。自旋的那几个线程就是在做这件事,它们空转着找活(而不是立刻交出 CPU),空转费电,省下的是一次唤醒的延迟。
  flowchart TD
    A["M 想拿一个 G"] --> B{"自己的 P 本地队列有吗"}
    B -->|"有"| C["从队头取一个,不加锁"]
    B -->|"没有"| D{"全局队列有吗"}
    D -->|"有"| E["从全局拿,要加锁"]
    D -->|"没有"| F{"别的 P 那里有吗"}
    F -->|"有"| G["偷走一半"]
    F -->|"没有"| H{"网络轮询器有活吗"}
    H -->|"有"| I["捞回来跑"]
    H -->|"没有"| J["自旋一会儿,再不行就交还 P 睡下"]
系统调用一堵,P 先从 M 上下来
G 里如果有文件读写、cgo 调用这类会掉进内核的动作,跑它的 M 会被卡住。M 卡住本身没关系,麻烦的是它手里还攥着一个 P,运行时在这里做了一次交接,把这个 M 上的 P 摘下来,交给别的 M 或者新开一个 M 去用,这个动作叫 handoff。被摘了 P 的那个 M 就那么等着,等系统调用返回,它再想办法去拿一个新的 P 继续干活,这一手让并行的额度不会被一次阻塞拖住,堵住的是一个线程,不是整条流水线。这一手是 Go 能在阻塞式写法下撑住并发的关键,代码写起来是同步的,一行一行往下等,底下已经被拆成了一段一段可以搬走的任务。代价藏在 threads 这个字段里,被系统调用堵住的线程不会被回收,它就在那里占着一个内核线程的位置,所以一个满屏都是阻塞调用的程序,threads 可能会远超 gomaxprocs,这也是为什么看快照时 threads 比 gomaxprocs 大不一定是异常,小才是。我在小工具里加了一段阻塞调用试了试,把读文件那一句塞进一个会反复触发的循环里,再看快照,threads 那一格往上走了,idleprocs 那一格掉了,runqueue 还是零,多出来的线程都排在内核里,不在可运行队列里,那会儿我才把这四个字和屏幕上的数字接上(改之前我一直以为系统调用会把 G 一起搬走)。
被摘下来的是 P,不是 G,G 跟着 M 一起堵在内核里,等它回来,那个 P 早就在别处干活了。
回头看 idleprocs=27 和 gomaxprocs=32,两者差着 5,可 NumGoroutine 只有 1,为什么不干脆把 P 减到一个。因为 P 的数量是给程序最忙的时候准备的,不是给此刻准备的,一个 Web 服务半夜可能只有几条连接,白天几千条并发一起压上来,P 跟着核数走,就是为了让高峰期的并行度不被启动时的状态限制住。
空闲的 P 不占 CPU,它只占一点内存,花掉 CPU 的是自旋的 M,这两件事太容易被混成一件。idleprocs 是空闲的 P,不是空闲的核,一个 P 忙代表它手上有队列有活要跑,不代表它此刻一定占着一个核。所以这一行快照正确的读法是,这台机器有三十二份并行额度,此刻用掉了五份,还有二十七份没动。
GOMAXPROCS 调的不是线程数
GOMAXPROCS 是 P 的上限,仅此而已。它不改 M 的数量,也不限制你能起多少个 goroutine。调到 1 的时候,所有 G 排进同一个 P 的队列,一次只有一个 M 在跑,程序照样能起十万个 goroutine,只是它们的执行被串成了一行。调到大于核数(比如在八核机器上设成三十二),运行时给你三十二个 P,可同一时刻物理上只有八个核在并行,多出来的 P 只是让队列更分散,争抢更多。
1 | func main() { |
所以我后来改回去的其实是并行额度这一项,同一份活,一个核跑多久还是多久,把值调回默认,变的只是同时能有几份活一起跑,单份活的速度一点没动。容器里还要多看一眼,读到的核数和容器配额不一定是同一个数,最稳的办法是把值打出来。
排成一队之后,总时间该按哪个数算?
几十万个 G,几十个 M,32 个 P
把三个数量级摆在一起才看得清这套设计。G 可以几十万个同时存在,因为每个只占一小块栈,初始栈很小,按需才长。M 一般几十个到几百个,因为它背后是操作系统线程,每个都有内核侧的开销。P 默认等于核数,因为再多也没有核去跑。
三个数字都不是随手定的,它们分别对着内存、内核和物理核这三样稀缺资源,便宜的是 G,贵的是 M,受物理限制的是 P。
我现在的习惯是遇到并发程序跑不快,先打一行 schedtrace 看形状,再决定动哪里,看 runqueue 有没有积压,看 schedticks 是不是全挤在一个 P 上,看 threads 是不是被阻塞调用撑大了。三个字母分别管着三件事,谁排队,谁干活,谁发许可证,分清楚之后,快慢这件事才算有了下手的地方。