链表不是数组的替代品
链表不是数组的替代品
隔壁老康难度 ★★☆☆☆ · 前置:数组到底快在哪 | 一句话结论:链表省的是搬运,付的是每一次跳转,工程里它多半站在哈希表旁边,替数组干那件干不了的事。
第二周接到一个改任务队列的活。队列里跑的是运营排的推送,一单要等半分钟才发出去,中途有人撤单,得把那条从队列中间摘掉。带我的同事说用链表,删起来便宜,改两个指针就行。我照做,四十分钟写完,还挺得意,想在周报里把便宜这两个字量化一下,就在中间插入、头部插入、尾部追加、中间删除的头尾各按了一次 time.Now,然后跑了一百轮。
量出来是 0。
六个操作,六张表,六个零。我把数字重新排了一遍,怀疑起止时间写反了,改过来还是零。那天下午我一直在想是不是机器太好,快到这个尺子看不见。第二天我把表贴到组里的周报,附一句链表快到时钟追不上。带我的同事看了半天,回我说你先把尺子校准,再来跟我讲它有多快。他说这话时没抬头,我站在旁边把表又看了一遍,还是六个零。
六个零不是链表的成绩
那六个 0 一个都不假,它们只是没有信息量。time.Now 在 Windows 上读的不是 QueryPerformanceCounter,而是 KUSER_SHARED_DATA 里那个由系统时钟中断更新的字段,源码里 time·now 开头两条指令是 MOVQ $_INTERRUPT_TIME, DI 和 MOVQ time_lo(DI), AX,拿到的是上一次中断打进来的时间。我写了个循环验证,一百毫秒里连读一千两百多万次,读到的值只变了 133 次。相邻两次读数的最小间隔 441600 纳秒,中位 555500,最大 1735300。这个数跟我脑子里那台机器的样子对不上,我一直以为时间是随时能精确到纳秒的东西,实际上它隔一阵才被中断打一次点,两次打点之间读到的全是旧值。我把这个循环又跑了两遍,还是同一批数字,才承认问题不在我写的负载上,在那只表上。
九万多遍。
一千两百多万次读数摊到 133 个不同的值上,平均一个值被抄了这么多遍。
几微秒到几百微秒的操作被它整个吞掉,吐回来一个 0,看上去像没花钱。量不出来和不存在,在我当时脑子里是一回事。拿 QPC 对着量同一个循环,一 tick 一百纳秒,每次走一到十一个 tick,time.Now 那边一直报 0。这只表没有坏,它只是不管我这件事。在 Windows 上用它掐一次操作,量到的是时钟的步子,不是代码的步子。
把两百次拷贝塞进一个循环
绕开粒度只有一个笨办法:让被测的东西跑得够久。单次短到看不见,就重复两百次,总时长除回去。
我把从中间插入一个元素的那次拷贝写进两百轮的循环,掐头尾,56925 微秒,除两百是 284627 纳秒。
二百八十五微秒。
这个数把我前面的判断整个翻过来了。我原来以为数组中间插入是理论上 O(n)、实际上很快,实际它一次要搬半个数组:一百万个 int64 是八兆字节,起手在正中间,就得往后挪四兆。四兆字节在内存里搬一趟,二百八十五微秒,这个价钱一点都不冤。更刺人的是它跟我那六个 0 的关系,六个 0 里有一个正是数组的中间插入。同一行代码,用循环量 285 微秒,用秒表量是 0,差别不在代码里,在尺子上。我后来把这条经验搬到别处:量 GC 停顿之前先看一眼停顿长不长,量一次系统调用之前先想一下它会不会比时钟的一格还短;量网络往返反而不用操心,那件事本来就比半毫秒大得多。
量不出来的东西,先问尺子够不够长。
链表省的是搬运,不是插入
把两件事拆开看,链表的定位就清楚了。数组插入的 O(n) 花在搬运上,n 个元素换位置,按字节付钱,一次搬一大段连续内存,硬件能帮上忙;链表插入的 O(1) 花在两个指针赋值上,可它前面还有一步,先走到那个位置,那一步是 n 次跳转,按次付钱。两条路都是 O(n),谁也不比谁便宜,付的却是两种钱。所以链表插入比数组快这句话,在真跑起来的时候多半不成立,它只在一种情况下成立,就是那个位置你已经拿着了。
这两种钱在硬件的账本上不是一回事。搬运是连续的读写,一次搬几百个字节,内存控制器能摊到好几个通道上并行做完,CPU 还能提前把下一段取进去,每字节的价格低得离谱;跳转是单发的读,读回来的东西要等一整个内存往返,中间那几百个周期 CPU 什么也做不了。我后来想明白,所谓链表插入快,是把改指针便宜和走到那个位置便宜搅在了一起。前半句是真的,后半句在数组上一个指令都省不掉,在链表上还要更贵:数组走到第 i 个元素是一次乘法加一次加法,编译完就两个指令,链表的第 i 个元素要走 i 次访存。这笔账我入职那年完全没算过,只觉得 O(1) 比 O(n) 好听。
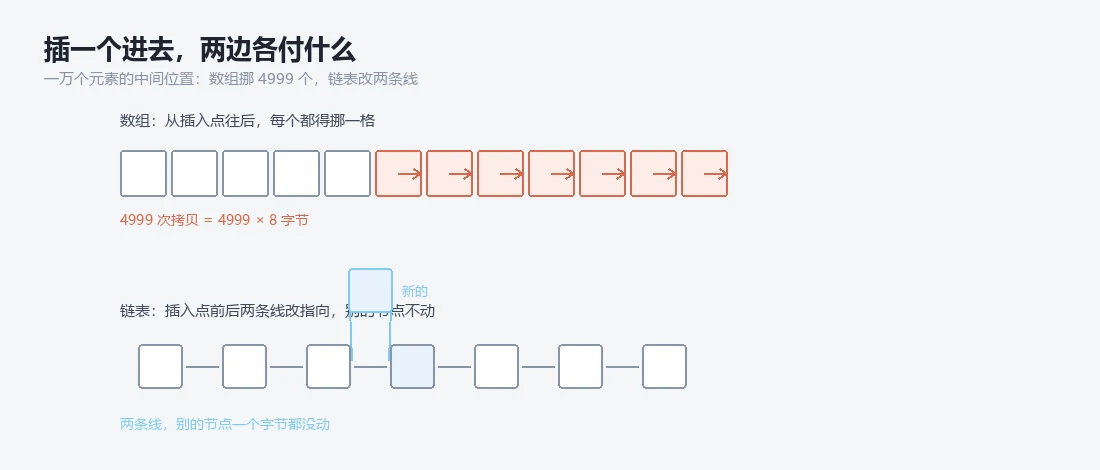
工程里选链表,理由通常是另一件事。数组插入一个元素,从 i 往后每个元素的下标都变了、地址都变了,外面握着的切片头、下标、指针全部失效;链表插入一个节点,已有的节点一个都不动,外面握着那个节点的人,只知道它的前驱换了一个。
这是一个所有权问题,跟秒表没关系。
谁还握着这个节点,谁的心智模型里它还在不在。代码一长出分支,这一条就比几个微秒值钱。链表值钱的地方,是它让你把东西挂在那儿,然后忘掉它。
每一步都得先读指针
我也想知道跳转要多少钱,就量了找不存在的。十万节点的链表,找一千次一定不存在的值,每次都走到底,100655 微秒;同一批数据摊成一个连续数组挨个扫,39505 微秒。两倍半。方向是对的,幅度比我预期的温和。链表每走一步要读一个指针,再跳到那个地址,它没有后面这个概念,硬件预取不知道下一个在哪儿;数组扫是一路走到底,预取能提前把后面的缓存行取上来。我以为会慢十倍二十倍,实测只有两倍半,原因我猜是这批节点按顺序 new 出来,地址挨得近,跳转没跳远。同样的量法换成随机顺序 new 出来的节点,差距会不会散开,我没量,先记着。硬件预取器不认指针,它只是盯着你最近走过的地址,猜你下一步还在这附近。节点按顺序 new 出来的时候,下一个多半就在附近那条缓存行里,赌对了,跳转就被降级成一次顺路。想验这一点不用写代码,只要把节点做得更大,让一条缓存行只装得下一个节点,赌中的概率立刻掉下去。这条我没有单独验证过,眼下也只是一句猜测。
跳转的价钱,取决于你跳到哪儿。
一百万个节点长什么样
分配形状是另一笔账,比查找那笔大。我 new 了一百万个十六字节的节点,逐个 &node16{},12 毫秒,最小地址到最大地址跨 25 兆。节点自己只占 15 兆,多出来的 10 兆是分配器的元数据和碎片。同一件事换成一整块 make 再自己切:2 毫秒,15 兆,地址连成一片。
十二毫秒对两毫秒。
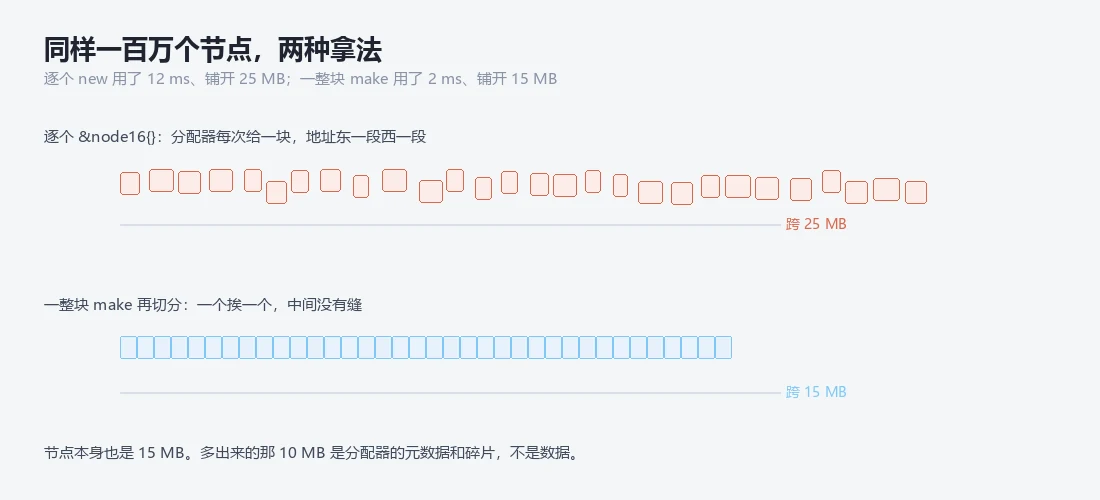
这六倍不全怪分配器。它得在随时能单独释放任意一个节点这个前提下工作。一整块 make 之所以快,是因为它连想都不用想,长度一算,从 spans 里挑一个够大的页切一块给你,回收也只回收整块。逐个 new 就不行:每个节点都可能被单独还回来,还回来的位置又不能挪动,外面可能正握着它。于是它只能在一堆大小各异的空洞里找位置,找到一个够用的,多出来一截还不能用,就切下来挂回空闲链。
那十兆不只是浪费。遍历时走过的地址区间比数据本身大出六成多,每一步都可能踩进一个没用过的页。后来我把节点改成从一整块里切,用完挂回空闲链,分配从一次系统调用变成一次搬运。
哨兵节点买的是分支数
写链表最烦的地方不在指针,在头部。空表插第一个、插在头上、删掉头节点,这三种情况都得单独判,因为 head 这个变量本身要被改写。
1 | func (l *List) remove(v int) { |
四个判断,每一个都对应一句这是特殊情况。顶上挂一个什么都不存的哨兵,head 永远指着它,头节点退化成哨兵的 next,不再是特例。
1 | func (l *List) remove(v int) { |
只剩两个判断。
它没有让代码变快,它让边界变成了普通情况。少写两个 if 听上去是省事,实际省的是另一件东西:每个 if 都是一条只有你知道的分支,后来的人改这段代码,得先在你没写的那条路上试一遍。哨兵占十六字节,换回来的是这个,不是速度。
单链和双链,差的是那一个 prev
单链表要删一个已知节点,得先有它的前驱。拿不到前驱只剩一个脏办法:把后继的值抄过来,再把后继删掉。节点被外面握着的时候这招会出事,被删掉的是后继,外面那个指针指的东西换了人。双链表每个节点多一个 prev,删除变成改四个指针,O(1),不用回头找。代价是每个节点八字节,每次插入要维护两边,写错一边就是一条断链,要等到下次遍历才炸。
八字节换一次回退。
这个账在节点少的时候完全不用算,一百万个节点是八兆,对现在的机器不算什么。真正要算的是它带来的写法差别:双链的每个修改都要同时维护前驱和后继两条线,插入漏改 prev 不会当场报错,要等到某次反向遍历才炸,那时候栈里已经看不到当初那一行了。我后来在评审里养成一个习惯,看到双链操作先问一句这两个方向是不是都动过。
LRU 缓存几乎没有悬念地选双链,就是这条决定的。命中一个节点,要把它从当前位置摘下来挂到表头,这一步必须 O(1),否则缓存还没命中,先慢了一次搬运。单链摘不掉自己,它不知道前驱是谁。
桶和 LRU 都长成链表的样子
链表的两个经典岗位,一个是哈希表的桶,一个是 LRU 的顺序表。链地址法里桶里挂一条链,扩容时桶数组整个换一遍,原来挂在桶里的节点不用搬,把 next 改到新桶上就行,节点地址一个都不变,rehash 的代价从搬所有元素降到改所有 next。这一条解释了我很久以前的一个困惑:课本上讲哈希表冲突处理,讲完链地址法就说它实现简单、删除方便,听起来全是工程上的好处,一句复杂度都没多给。
它值钱的地方确实不在复杂度上。开放寻址的查找也是 O(1),账面甚至更好看,探测次数少,内存连续。差别在扩容那一刻:开放寻址没有元素和槽位的分离,元素就住在槽里,槽一换位置,元素跟着换位置,那一瞬间整张表都不能读;链地址法里桶数组只是目录,元素在目录外面,目录换一本,元素不动。Redis 的哈希表扩容走的也是这条路,它甚至更进一步,把新旧两张表同时挂着慢慢搬,查找时查两张,搬完一张删掉一张,中间任何时刻都能读。
两个岗位的共同前提是同一件事:容器负责告诉你东西在哪,链表负责让东西留在原地。
哈希表给 O(1) 找到它,链表给找到之后不用搬。两个各缺一半。
那个任务队列最后没留在链表上。我把节点池化了,从一整块里切,空闲的串成一条链,撤单还是改指针,但分配从一次系统调用变成了一次搬运。
留下的只有一个我还没想清楚的问题:如果这个队列要序列化进 Redis,节点地址不变这件事就一点用都没有,那我还该不该为每次跳转付钱。这个我到现在也没量出让自己信服的答案。