分配器内部也是一串链表
分配器内部也是一串链表
隔壁老康难度 ★★☆☆☆ · 前置:链表慢在每一次跳转 | 一句话结论:分配器把空闲块串成链表,链表的节点就存在空闲块自己身上,取和还都只动头上一格,代价是这些块在地址上永远拼不成一整片。
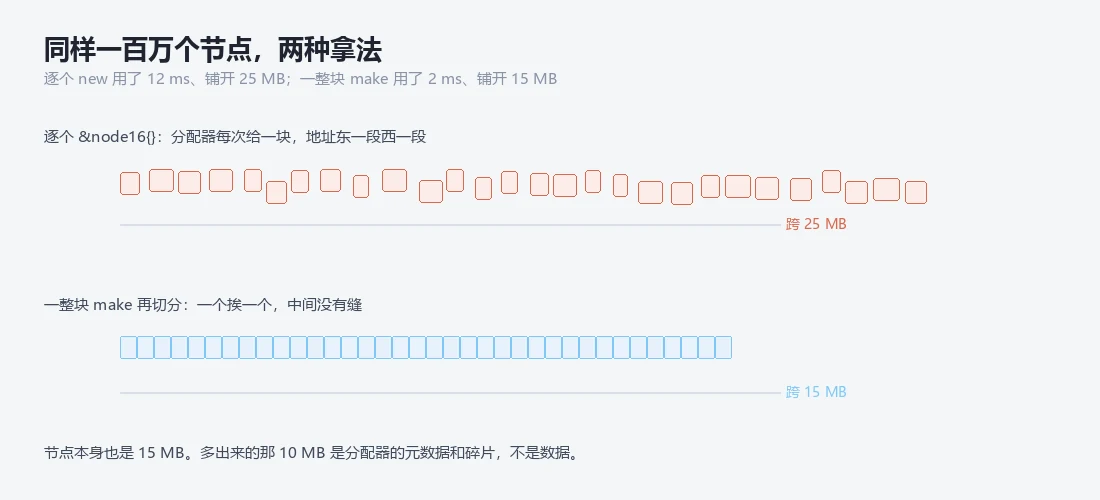
第一份活是给组里一个日志聚合的小工具加过滤。那年冬天为了弄清楚它到底吃多少内存,我在测试里堆了一百万个十六字节的节点,用循环一个一个 &node16{},把每个地址塞进一个切片里存着,跑完再从这堆地址里扫出最小和最大的两个相减。终端打出来 25 MB。这一百万个节点自己加起来只有 15 MB,十六乘一百万,一分不多,剩下那十兆是别人替我花的。
多出来的那十兆不归我。
换一种写法,同样的节点、同样的数量,一次 make([]node16, n) 把整块切出来,再自己把 next 一根一根接上,2 ms,最小到最大正好 15 MB,中间没有一处断口。前一种跑 12 ms。
同样是一百万个节点,一次 12 ms 跨 25 MB,一次 2 ms 跨 15 MB,时间差 6 倍,地址上多出来那十兆占了 25 MB 的四成,也就是说同样的东西我要了一点六七倍的地址空间。
我那时对分配器的印象还停在课本上的一幅图:一块内存,中间切几刀,切好的块摆在那儿等人拿,谁来要就挑一块给谁。翻过 runtime 的源码才知道那些块不是摆着,它们自己被串成了一条链表,链表头挂在分配器的一个结构体里,取一块是从头上摘一格,还一块是往头上插一格。
链表在这个位置不是拿来遍历的。
那十兆被两个东西吃掉了
逐个 &node16{} 的时候,每次调用都向分配器要一个十六字节的槽;手里没有现成的,就去要一批,一批切成等大的槽放进一个 span 里(Go 把按页切出来的那段叫 span)。span 是一个一个要来的,在地址上彼此不挨着,中间夹着别人要走的页,也可能夹着还没被用上的预留区。所以把最小和最大一减,中间所有的缝都被算进了那 25 MB,也包括根本不属于我的部分,这个数只能当上界看,不能全记成浪费。
能确认的有两笔。一笔是分配器自己的账本:每个 span 都有一个头,记着它切了多大、还剩几个空槽、属于哪个大小档;更上面还有页一级的记录,垃圾回收扫堆的时候靠它们定位对象。这些结构按 span 的个数长,不按我的节点数长,所以节点越小、span 切得越多,账本摊到每个节点上的比例就越高。另一笔是碎片:span 里这次切剩下、还没人来填的槽,占着地方不干活,因为那个 span 已经被绑定在某个大小档上了,别的档要的尺寸它给不了。两笔加起来方向是清楚的,我算不出各自占多少,只能确定它们都在,而且都跟着 span 的个数走。
一整块切分没有这两笔。它只问了一次,拿回来的就是十五兆连续的空间,切多少刀都在里面,只要算好偏移,不需要为每一小片单独记账,也没有哪一段切剩下要留着等别的尺寸来填。
省下的那十毫秒不在算法上。
分配粒度从一颗一颗变成了一整片,次数从一百万降到了一。
这件事我在别处也验证过:容器类的代码爱用一个大数组加下标,看着朴素,实际上是每个节点单独要一块地的时候,账本和缝隙会跟着一起长,而这两样东西的代价在 profiler 里根本不出现。12 ms 里也有一百万次赋值,这两件事我没拆开量过,所以这六倍里有多少是分配的账、有多少是写内存的账,我只能说前者占了大头。
链表的节点就住在空闲块身上
空闲链表最要紧的一点是它不额外占地方。链表的节点就是空闲块本身,块的头几个字节被当成 next 用,写着下一块空闲块在哪儿。一块被摘走的时候,这块内容归你了,往里面写什么都行;还回来的时候,分配器在你那块的头几个字节写一个地址,它就又成了链上的一节,连内存都不用另申请。
所以它有一个下限。
至少要装得下一个指针,next 才有地方放。分配器的最小规格就是这么定下来的,最小那一档只有一个指针那么宽;比它更小的东西没法单独成块,运行时干脆把几个塞进同一个块里挤一窝,再在里面按字节数切分。
摘和还都是常数时间,因为只动链头。取是读头节点的 next,把头指过去;还是把还回来那块的 next 写成当前的头,头指过去。两次赋值,一条链,没有遍历,也没有查找。
1 | type pool struct{ head *node } |
代价跟着一起来了。链上的顺序是后进先出,块的大小也不保证一样,想找一块装得下某个尺寸的块,只能从头往下走,走到够大为止,这一步是 O(n),而且发生在整个程序最热的路径上。所以真的分配器不这么干:它们按大小分成几十个档,每档一条自己的空闲链,取的时候直接去对应的那条,一步到位。
分档把找一块够大的换成了查一个下标。
代价是每一档都可能各留一点库存,谁也用不上谁的,档分得越细,这种闲置越多。
向系统要一次,贵在哪儿
为什么不每次直接向系统要。要一次内存的路径大概是这样的:进内核,找一段可用的虚拟地址,建页表项,把这块标成你的;真正碰到那些页的时候还要再缺一次页中断,内核这时候才给你物理页,并且把页清零。这个清零不是礼貌,Go 的零值语义靠它撑着,新拿到的内存里不能有上一次别人留下的东西。
在池子里摘一块,是两次赋值。
所以分配器的做法是先拿一大片、再自己分:一次向系统要一大段,切成页,页再切成槽,切剩下的记在账上等下次。这一层把每次都要变成了每很多次才要一次,这就是为什么说分配是被摊薄的。
摊薄有个前提,拿回来的那片得够用很久。
摊薄之后能差多少,我没量出来。这台机器上 time.Now 半毫秒才走一格,单次 mmap 加一次缺页的开销在这把尺子上连一个点都算不上,量出来要么是 0,要么是时钟自己在抖。这个差距通常被说成一两个数量级,我信这个方向,但给不出自己量到的数,就不编了。归还也是一样的账。把内存还给系统意味着那些页表项作废,下次再要又得重建一遍,所以运行时不会一空出来就还,它留着,等真的闲了很久再慢慢还回去。这条推论挺实用:一个进程的 RSS 涨上去以后掉不下来,很多时候问题并不在泄漏,分配器还攥着那些页等复用。
我在这条上翻过车,把没还回去的页当了两天泄漏。
三层缓存把同一件事做了三遍
Go 的分配器把这条链摊在三层上,一层比一层慢,一层比一层大。最上面是每个 P 私有的一份缓存,按大小档各挂一个 span,要一个槽就从对应的 span 里摘,不加锁,因为这份缓存只有这个 P 在动。第二层是每个大小档一个中心列表,所有 P 共享,上面那层摘空了就来找它要一整段,这里要加锁,或者至少要做原子操作。第三层管页,上面两层都不够的时候才由它向系统要。
三层做的是同一件事。
每一层手里都是一串可用的东西:缓存里是 span,span 里是那条空闲槽的链,中心列表里是还没切完的 span。取,从某一层的头上摘一个;还,插回某一层的头上。分层的意义只有一个,让绝大多数请求停在最上面那层,不要碰到锁,也不要碰到页。细节我不敢说得太死。Go 每个版本都在动这块代码,槽空没空这件事曾经用链表表示,后来换成了位图,档数也不是一直不变。要精确到字段,得对着你手上那个版本的 runtime 源码看,我没那么做,所以这里只说形状:分档、分层、每层一串。
slab 和它用的是同一把钥匙
Linux 的 slab 分配器干的是同一件事,只是名字不同。每一类对象有一个自己的 cache,cache 里再按 CPU 各有一条空闲对象链,链的节点就是空闲对象本身,对象空闲时头几个字节存着下一个空闲对象的地址。要一个,从链头摘;还一个,插回链头。
前提只有一个:一样大。
同一个 cache 里所有对象一样大,头几个字节才够放一个指针,摘下来给你用的时候也不会串味。这条约束看着是限制,其实是整个设计的地基,它把分配从一次查找压成了一次查表。Go 的 size class 是同一把钥匙,只是它把尺寸压成几十个档,再让每个档各走一条链。文件系统里也有过一模一样的写法。早期 Unix 的空闲块表就是串起来的,每个空闲块里存着一批空闲块号,再存一个指向下一个这样的块的指针;那块地方本身被用掉的时候,存在里面的块号跟着一起没了,因为它们本来就在那块地方上,这也是这套做法最后被换掉的原因之一。
这条路的尽头是位图。
后来的文件系统改成了位图,一个块一位,一表示占着。取舍正好反过来:找一块连续的空闲区很快,因为那就是在一片位里数连续的零;但摘一个、还一个要改一位,还要同步到磁盘上的元数据,没有链表那么干脆。
链表强在摘和还,位图强在找。
池子里的东西在 GC 眼里都活着
自己写对象池的人图的是省掉分配。写下去之后很容易碰上另一件事:池子里的东西,对垃圾回收器来说全是活的。
你省下来的是分配次数,赔进去的是活对象数。判断一个对象能不能回收,看的是还有没有人引用它;池子这个结构体一直活着,它手里那条链就一起活着,链上每一块都被算成正在使用,扫描要一块一块过。池子越满,堆越大,扫描要过的东西越多。换个说法:池子让分配变便宜了,代价是释放被推迟,被推迟的东西还在占地方,而且这些地方在每次回收时都要重新走一遍才能确认没人用。
标准库的 sync.Pool 在这件事上做了个折中:每次垃圾回收,池子里的东西会被清掉一批,能留一轮,留不过第二轮。运行时在池化和堆之间替你选了一个折中的位置。
我写过一个装字节切片的池子,用来拼日志。上线之后内存没降,比不池化的时候还高。原因是归还的块大小不一,池子照单全收,最大的那几块一直躺在里面没人再要,可它们占的地方一直算活的。后来改成按大小分几档、每档限一个上限,超了就丢,内存才回到该在的位置。
判断该不该池化,我现在看三条:这段分配是不是在热点路径上;对象大小是不是固定的;同时在用的对象数有没有上界。三条里有一条不成立,池子很容易变成另一种泄漏。
总量够,也拼不出一整块连续的
碎片是这类结构的天生副作用。不停地要、不停地还,还回来的块大小各不相同,空闲链上就变成一长串长短不一的块,中间还夹着已经被占用的,链的顺序是后进先出的,所以相邻的两次分配在地址上可能隔得很远。
这不是谁写错了。
空闲总量够,不等于手上有一块能用的连续内存。总空闲量可能还有一半,可你要一块比链上任何一块都大的连续区域,就是没有。分配器只能去要新的一片,于是总量继续涨,在用的还是那些。分档本身也在制造碎片:同一个大小的对象只进同一个档,A 档空着一堆槽,B 档满了;A 档那些槽没法切成 B 档要的大小,就算硬切,A 档的账也就对不上了。那 25 MB 和 15 MB 的差,从这个角度看就没那么神秘了。逐个 new 的节点散在几十个 span 里,span 之间本来就有缝,缝里夹着别人要走的页;整块切出来的十五兆是一整片,缝只可能出现在最后,最多就是最后一个页没填满。地址跨度这个指标之所以能看出差别,是因为它把缝全算进去了。
我的节点只占其中一部分。
只盯要得够不够整
平时写业务代码,我不会自己去实现空闲链表。运行时和内核已经把这件事做在我看不见的地方,我能做的是别让它多做无用功:一次要够,大小固定,别在循环里一个个 new。
真要自己写池子,我会把两个数量出来再决定:不池化的时候花多少时间,池化之后堆涨了多少。只看前者,池子永远是对的,因为它确实省了分配。省下来的时间和涨上去的堆,是同一笔账的两面。
我只盯这两件。
要得够不够整,留下了多少活。
回到开头那十兆。它不是 bug,也不是我哪里写错了,它是把一百万次要一小块地换成一次要一大片之后必然会出现的差别。链表在这里出现的理由和我最初以为的相反:它不是为了把数据连起来,是为了让空闲的地能被反复找到,找到之后立刻摘掉,用完立刻挂回去。
那一百万个节点后来我换成了整块切分,地址跨度变成 15 MB,正好等于节点自己占的地方。这个等式比快六倍更让我满意,因为它说明这块内存里除了我的东西,没有别的。