那到底什么时候该用链表
那到底什么时候该用链表
隔壁老康难度 ★★☆☆☆ · 前置:链表慢在每一次跳转 | 一句话结论:链表不是拿来装数据的,是挂在对象身上的钩子,它卖的是手上捏着节点时的 O(1) 摘除,和同一个对象同时属于多条链。
第一个正经活是给一个热门商品的详情接口加本地缓存。缓存要设上限,满了按最久没用的淘汰。架构组给了一版参考实现,一个 Map 配一条链表,谁被访问就把它挪到表头,满了从表尾砍掉一个。我照着抄,抄得挺顺,连变量名都没改,周一上线,周二没出事,周三也没出事,我就把这件事忘在了脑后,还跟带我的同事夸了一句这结构好用,插进去、摘出来,都不用管别人挪没挪窝。现在回头看,我夸的是自己的手感,不是那个结构。
抄到第三次,出事了。
连接池那边报了个怪数字。池子里的空闲连接数对不上,多的时候多三四个,少的时候少一两个,跑了两个星期没人发现,直到有台机器开始刷连接已关闭。我去翻那块代码,翻到一半就看出来了:一条连接在池子里同时占着两个位置,一个是全部连接那张表,一个是空闲队列。这个池子是我们自己写的,写它的人已经离职,注释只留了一句加了锁,可以放心摘。我盯着那句注释看了很久,锁确实加了,两张表加的还是同一把锁,可锁保护的是写的动作,没保护两边的一致性。
第二次关它,谁也没拦住。
锁管不了这个。
那两天基本在打日志。先把每个连接的开和关各打一行,攒了四十多万行,再把两张表各自导出来,对着时间戳找差。找到第三遍才看明白,那几条连接在两张表里都在,代码只从空闲队列里摘掉了它。这种错编译器不会替你挡,单元测试也难盖住,因为两条链单独测都是对的,两个函数的覆盖都到百分之百了,只有同时操作才露馅。
两条链单独都对,合起来就错。
这地方用数组很难写对。同一条连接不可能在两个切片里各占一格,除非存两份副本,那又变成改了一边忘了一边。那次修完,我对链表的看法算是定了型:它不是拿来装数据的东西,是往对象身上挂的钩子。
后来我给那个池子补了一段注释,写明一条连接同时属于两张表,任何一处把它摘掉,另一处必须跟着摘,包装函数只留一个出口,谁都不许绕过去直接调摘除。这段注释比代码长。多链结构的成本不在写,在往后每个改它的人都得知道这份约定。数组没这个问题,它根本不给你挂第二条链的机会,等于用一句编译错误替你把约定守住了。这个便宜我一开始没算进去。
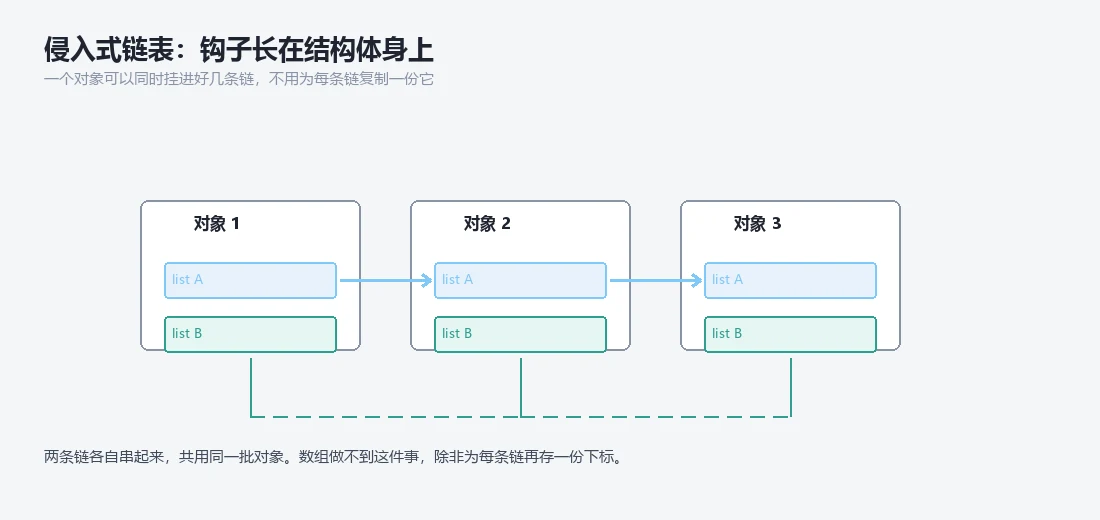
一条连接身上挂着两根线
Linux 内核是反着来的。不是把结构体塞进链表节点,是把链表节点塞进结构体。下面这段是我照着形状编的示意,不是内核源码原文,字段名不必当真。
1 | struct conn { |
一个对象同时挂在两条链上,两条链指向同一块内存,各自有一对前后指针。摘的时候不用管对象放在哪,也不用复制,改四个指针,一个字节都没搬。内核里那套 list_head 就是这么用的,链表节点是结构体的一个成员,谁需要挂链就在自己身上留一块地方。
代价在取回。内核遍历时手里只有 struct list_head *,要拿到外层的结构体,得用偏移量反算,那个宏叫 container_of,把指针减去成员在结构体里的位置。
1 |
这个减法能成立,是因为一个结构体的成员排在内存里是固定的,从成员的地址倒推回去就是结构体的首地址。代价是它只在成员类型对得上时成立。要是把一个 list_head * 当成另一个成员的指针传进去,减出来的地址照样像个地址,不会报错,编译也能过,跑起来取到的是结构体外面几个字节的内容。这种错比空指针难查得多,空指针至少崩得快,减错了地址什么时候发作全看运气。内核里那些宏用得久,盯的人也够多,出事的概率低;业务代码里自己手写一份偏移量反算,就得有人替你把这条约定守到项目结束。
所以这个宏我认得、读得懂,但没在业务代码里写过一次。
丑归丑,换来的是一笔实打实的账:零额外分配。我量过这一笔:一百万个节点逐个 new 出来要 12 毫秒,地址跨了 25 MB;换成整块 make,2 毫秒,跨 15 MB 而且连成一片。链表每多加一个节点就多一次分配,侵入式把这些分配全省成了零,节点就是对象自己身上的一段。省下来的还有一次跳转,container/list 里的 Element 是单独分配的一块,节点和数据隔着一次寻址,侵入式的链表节点就长在外层结构体里,跟业务字段挨着。这一条我没量过,是读代码时的判断,方向上占优,别拿它当结论。
内核为什么非得这么干,我后来想明白一层。那些结构体不是一次性建好的,是运行中一个一个长出来的,建完就要挂到好几条链上,事件要挂,定时器要挂,等待队列也要挂。要是每个都先包一层节点再挂,一个对象就得分配两次,一次给对象,一次给节点,对象越大越亏,节点和对象之间还隔着一次寻址。侵入式把这两笔账一起抹掉。
不好看,但便宜。
数组中间少一个,挪的是一整片
一百万个元素的切片,从中间删一个,保序就得把后面五十万个往前挪一格,实测挪动的比例是 49.9% 到 50.0%,正好一半。不想保序就 swap-remove,把末尾那个换过来,只挪一个。差别不在删除那一行,在谁付搬运费。
链表删一个也是改指针,一分钱不搬。可你手上如果只有一个 id,得先找到那个节点,找的过程就是遍历,一趟下来几万次跳转,每次都得等上一跳回来才知道下一步去哪。所以定输赢的地方不在删除有多快,在删之前你手上有没有那个节点。
我一开始把这个道理记反了,以为链表赢在删除,后来才发现它赢在删除之前那一步:你从哈希表里查出来的不是 key,是那个节点的地址。
差一个指针,判决就翻过来。
账就是这么翻的。
那个 49.9% 是我自己量出来的,量法很土。造一个装一百万个 int64 的切片,随机挑下标删一千次,每次删之前记下当时的长度和位置,删完拿长度差反推挪了几个。第一遍跑出来正好一半,我以为自己把循环写错了,改成删末尾试一次,挪零个;再改成删开头,挪九十九万九千九百九十九个。两头一对,中间那一半就站住了。链表的对照组更好写,一百万个节点的双向链,手上预先捏着中间某个节点的指针,删它就是改两个指针,计时的读数落在计时器自己的刻度底下,量不出来。所以那张表上链表这一格我一直空着,只写了句小于一微秒,没敢往上填具体数。
空着的那格比填了数的那格更能说明问题。
这条我写成了自己的第一条:手上已经捏着节点引用,才轮到链表上场。
散开的链表和排好的链表,是两个东西
一千万元素扫一遍,切片 3.0 到 3.5 毫秒,链表按地址顺序 11.6 到 15.3 毫秒。差三四倍,这个差距还在能接受的范围里,毕竟链表每走一步都要多读一次指针。
把节点地址打散再扫,同一个循环,同一份数据,970 毫秒。
三百倍。
我盯着这个数字看了半天。
中间我没改一行遍历代码,只是让节点在内存里散开了。所以聊链表快慢的时候,聊的其实不是链表这个结构,是这批节点当初怎么分配出来的。逐个 new 出来的链,和从一整块里切出来的链,能差两个数量级,而它们在代码里长得一模一样,光看结构体看不出来,看注释也看不出来,只有翻分配那几行才知道。
我在这上面栽过一次。一个离线任务,数据量不大,几十万条,结构体里带个 next 指针,我看着像链表就按链表的常数估了一遍,结果跑了一分半,比我估的慢了二十倍。后来把分配改成从大块里切,别的都没动,掉到六秒出头。同样是链表,从大块里切出来的节点地址挨着,跳起来像在走一条稍微绕的路;逐个 new 出来的节点散在堆里各处,每跳一次都可能撞上一次缓存未命中,而这件事在代码里完全看不出来。教训不在链表,在我拿结构挑性能。
顺手记一笔:十万个节点上找一千次不存在的东西,链表 100655 微秒,连续数组扫 39505 微秒,两倍半。这个倍数不算吓人,方向倒是清楚,顺序扫这件事,链表没赢过。
Go 的标准库留了一份,runtime 用的是另一份
标准库的 container/list 是通用双向链表,Element 里装着值和前后指针。用法是先 PushBack 拿到 *Element,之后想删就拿着这个指针删。
1 | l := list.New() |
它比数组强的地方就这一行。你已经拿着 e 了,Remove 不需要知道它排第几,也不需要挪动任何人。Go 里自己写的 LRU 基本都是这个套路,Map 存 key 到 Element 的映射,链表管顺序,两边互不复制,淘汰的时候从表尾摘,不用扫一遍找谁最老。
runtime 里那些链我读得没那么细。能确认的是形态:对象活着的时候挂在某条链上,条件满足了从中间摘掉。这类地方容不下搬运,对象可能很大,摘它的时候手里可能还端着锁。具体是哪个文件、哪个结构体,我没逐个对过源码,这篇就不点名了,写错一个字段名比不写更糟。
到这儿就够了。
只在两头进出的时候,它不是最好的那个
日志缓冲这类东西,从一头写进去,从另一头读出来,环形容器更合适。分配一次,两个下标转圈,省掉每个节点那次单独的分配。Go 的 channel 里面就是一圈槽位加两个下标,不是链表。
撤销栈那个东西我写过两版。第一版照教科书,一个双向链表,压栈就是往表头插,撤销就是把表头摘掉,栈顶永远是最近那一层。写完发现这个结构里从来没用到过链表最值钱的那条特性:我永远只碰表头,中间的节点一辈子不会单独摘一次,那两条 prev 和 next 指针从建出来到程序退出都没派上用场,白占十六个字节,还多给了自己一个把指针连错的机会。第二版换成切片,压栈是 append,撤销是把长度减一,代码少了三分之二,跑起来也看不出差别。那次之后我看链表的标准就是这一条:它的两个指针得被用上,不然就是白背的行李。
我用链表用得最没负担的地方,是几十个待发消息、一张十来条的配置表、一个大小几十的订阅者名单。这个量级上,一次遍历的常数比复杂度重要得多,随便挑一个都跑在微秒底下,量不出来差别。真要纠结,说明别的地方还有更大的账没算。
反过来,要按下标随机取、要顺序扫、要把整块喂给别的东西,一律数组。前几篇量过的那些数字讲的就是这件事,没有一次是链表赢的。
这条没什么可争的。
一个对象要挂几条链,先数这个
如果一个对象只属于一个集合,顺序还经常变,我先看它被删的频率,再看我是不是总能在删之前拿到位置。
只有一个集合,就不用挂链。
如果它同时属于两个以上集合,基本不用再想,直接在结构体里塞两对指针。一份对象,几条链,谁也不复制谁,也不用二次分配。这是我一年多里唯一觉得非它不可的场合。
如果它只是被查、被遍历、被按下标取、被当成一块连续数据喂给别人,那是数组的活,别绕。
如果只在头尾走,用环形队列。
如果集合里就那么几十个元素,随手写个切片,不必为几十次比较写一段解释。
那两天我花在改错上的时间
连接池那次,从报错到改完花了两天。最费功夫的其实是写清楚一条连接到底属于几个集合、谁有资格关它,代码本身没占多少时间。写完我盯着屏幕想了一会儿,发现两天里最难的那部分,跟链表一点关系都没有。
后来我养成个习惯:写容器之前先在纸上画一遍对象的生命周期,看它会不会同时出现在两个地方,会,就给它挂链,不会,老老实实用切片。
现在打开编辑器,看见自己要往结构体里加一对指针,我第一反应不是快不快,是以后会不会有人拿着这个指针从另一个地方改我。答不上来的时候,就用切片。