索引建错列,比不建还慢
索引建错列,比不建还慢
隔壁老康难度 ★★★★☆ · 前置:写多读少的世界里,B+ 树输了 | 一句话结论:联合索引能不能用,看的是前导列,不是“这个查询里出现的列都在索引里”。
2024 年 4 月 9 号中午,我在楼下食堂端着盘子问老周,联合索引的列序到底要不要讲究。他咽下饭说,不用讲究,where 里出现的列全塞进去就行,先让查询跑起来,真慢了再回头调。我信了。晚上回家,我在自己那个测试库上照这个说法建了一条 create index idx_uid_status on orders(user_id, status),建索引花了 1012.9 ms。表是一百万行五列,id、user_id、status、amount、created_at,假订单是我用 Python 灌进去的,user_id 随机撒在 2 万个值上,status 只有几种。
第二天下午五条查询跑完,有两个数我看了三遍。
五条查询都是业务里会写出来的样子:按 user_id 查,按 user_id 加 status 查,按 status 查,按 status 加 amount 查,按 user_id 加 amount 查。这五条不是我凑的,是把我那阵子写过的列表页翻了一遍,去掉分页和排序,剩下的条件就这几种形状。前两条对应详情页,第三条是后台按状态筛,后两条是我猜会有人顺手加上的组合。不建索引的时候五条计划全是 SCAN orders,最快 46.05 到 49.02 ms,中位 46.79 到 49.39 ms,五条挤成一团,快慢分不出来。扫表的代价跟条件怎么写几乎无关,反正都是从头读到尾,读到不匹配的丢掉。
机器是 i9-14900HX,32 个逻辑核,Python 3.13.12 自带的 SQLite 3.50.4,页大小 4096,一百万行。库文件落在本机固态盘上,每次跑之前先 select count(*) from orders 把页读进缓存,再跑一遍丢掉的预热轮,然后连跑若干轮取最快和中位。计时夹在 execute 和 fetchall 外面,游标返回的行我都取完了才算数,不然测的是规划时间不是取数时间。执行计划单独用 explain query plan 拉一次存成文本,跟耗时表贴在一起比对,免得事后凭印象回忆它写的是 SEARCH 还是 SCAN。灌数据和建表的时间没算进去,那两个数跟查询没关系。
我把 where 里的列,按顺序抄进了索引
表在下面。中间那列最快和中位,右边那列从 explain query plan 里原样抄的,USING 后面那半句比时间更值钱。
| 查询 | 最快 / 中位(ms) | 执行计划 |
|---|---|---|
只要 user_id |
0.27 / 0.29 | SEARCH orders USING COVERING INDEX idx_uid_status (user_id=?) |
user_id 加 status |
0.26 / 0.28 | SEARCH orders USING COVERING INDEX idx_uid_status (user_id=? AND status=?) |
只要 status |
140.69 / 189.94 | SCAN orders USING COVERING INDEX idx_uid_status |
status 加 amount |
220.04 / 269.37 | SCAN orders |
user_id 加 amount |
0.31 / 0.35 | SEARCH orders USING INDEX idx_uid_status (user_id=?) |
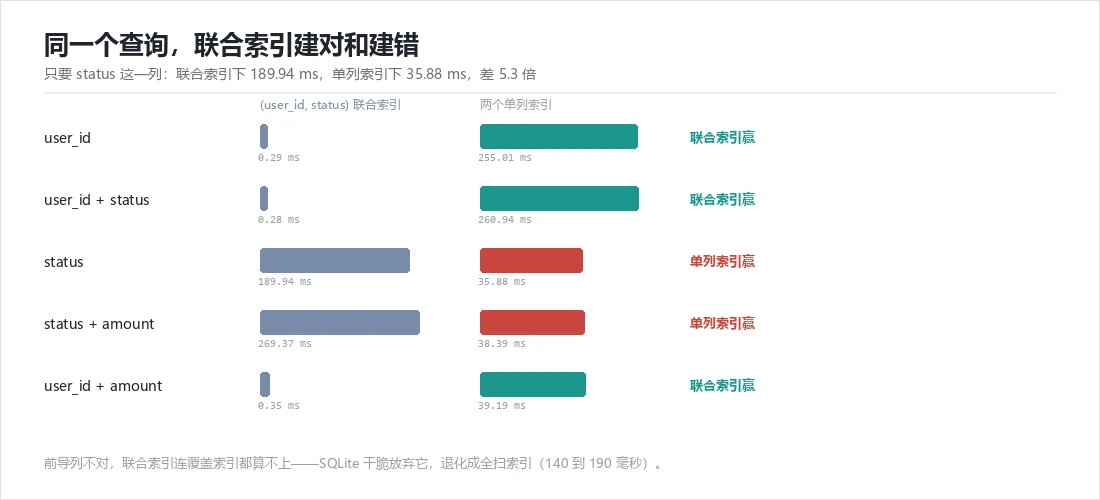
三行掉到 0.3 ms 上下。
一行 190 ms,一行 269 ms。
前导列就是 create index 括号里第一个写进去的列。这条索引的前导列是 user_id,整棵树按 user_id 排,user_id 相同的行才按 status 排。status 在这棵树里从来没有单独成过段,它被切成了两万段,每一段只在自己那个 user_id 里面有序。要找 status 等于 3 的行,只能把这两万段一条不落地翻完,翻的时候还得一页一页解记录。计划里那句 SCAN orders USING COVERING INDEX idx_uid_status 说的就是这个意思:SQLite 还在用它,只是把查找换成了全扫,索引从帮手变成了一个必须从头读到尾的副本。
用它,和用好它,是两个动作。
更难看的是另一件事。这条索引下只查 status 要 189.94 ms,不建索引时同一条查询是 47 ms 上下,索引没帮上忙,还把它拖慢了四倍。扫索引和扫表看的行数一样,走的指令不一样:索引是棵树,得按树的顺序往下走,每进一页解一条记录、取 status、比一次,再挪到下一页;表是顺序读,一页里几十行连着摆,读指针几乎不用回退。这个差值我没拆到指令那一级,只能记成现象。
建错列,是会比不建还慢。
后一行更彻底,status 加 amount 的计划退回 SCAN orders,索引一次没碰,中位 269.37 ms。这一格我不敢当结论,因为不建索引时同一条查询是 47 ms 上下,五倍多的差说明我的 page cache 状态没控住,它是整组数里最脏的一格。
前缀一断,后面那列就散成一地
(user_id, status) 在树里是一份按字典序排好的副本:先比 user_id,小的整段在前;user_id 相等才比 status。判断一条查询能不能用上它,只看一件事,条件里有没有从第一列开始的那一段。有,就在这一段里二分;没有,就只能从头扫到尾。所以最左前缀不是一句要背的口诀,它是排序规则直接落下来的结果,树怎么排,条件就得怎么给。我这人记口诀一向记不牢,知道它是排序规则之后反倒不用记了:拿到 SQL 先想这棵树按什么排,能不能把条件翻成一段连续区间,翻不出来就是扫。
名字听着像口诀,其实是树的形状逼出来的。
前缀就是这棵树的入口。
MySQL 8.0.13 之后加了 skip scan,前导列不同值很少的时候,它可以一个值一个值跳着走进每一段。SQLite 没这个优化,我这儿看到的是实打实的全扫。同一句 SQL 换一个引擎可能换个结果,这条别跨库套用。
前缀也不是只有等值能吃。前导列上给范围,where user_id between 100 and 200 and status = 3,user_id 那一段是连续地址,段里再按 status 二分,两列都能吃到。吃掉多少另算,取出来的行照样要回表。反过来说,前缀一旦被范围打断,后面那列就只剩过滤的份:where user_id > 100 and status = 3 里 status 还能帮忙筛,可它已经不能用来定位,得在 user_id 那段连续地址里挨个看。这个区别我在建索引的时候不太在意,等真写到带范围的分页查询里才发现,两列写在条件里,跟两列都能进索引,差着一层。
换成两条单列索引,五个数全反了过来
联合索引删掉,换成两条单列的,idx_status(status) 和 idx_amount(amount),同样的五条查询,跑法也一样。
| 查询 | 最快 / 中位(ms) | 执行计划 |
|---|---|---|
只要 user_id |
235.94 / 255.01 | SCAN orders |
user_id 加 status |
234.51 / 260.94 | SEARCH orders USING INDEX idx_status (status=?) |
只要 status |
28.98 / 35.88 | SEARCH orders USING COVERING INDEX idx_status (status=?) |
status 加 amount |
27.46 / 38.39 | SEARCH orders USING INDEX idx_amount (amount=?) |
user_id 加 amount |
35.01 / 39.19 | SEARCH orders USING INDEX idx_amount (amount=?) |
五个数跟上一张表一行一行对着看,全反了。
最核心的一行是只查 status:联合索引下 189.94 ms,单列索引下 35.88 ms,5.3 倍。同一列,同一份数据,一条专门给它建的索引赢了,一条把它塞在第二位的索引输了。反过来也成立,user_id 加 status 在联合索引下 0.28 ms,在两条单列索引下 260.94 ms,差九百多倍。
反过来那一行更扎眼。只要 user_id 的时候,两条单列索引下是 255.01 ms,计划 SCAN orders,一条都没用上;同一条查询在联合索引下是 0.29 ms。索引还在库里,名字也在,就是帮不上忙,因为 user_id 不是任何一条的前导列。我第一次看到这个落差愣了几秒,脑子里想的是“索引明明建了啊”,翻执行计划才明白建了跟用得上是两码事。
两条索引不会在一次查询里合起来用。SQLite 没有 index merge,MySQL 有,可要让规划器相信合并起来比单扫一条便宜,条件挺苛刻,多数时候它宁可选一条然后回表。
所以索引不是攒出来的。
缺了前导列,两条单列加一起也顶不上一条列序对的联合索引。
覆盖索引省下的是回表,不是判断
再切一组。同一条联合索引,只换 select 后面的列,条件都是 user_id = 12345,各取 50 行。
| 取的列 | 最快 / 中位(ms) | 执行计划 |
|---|---|---|
user_id、status |
0.13 / 0.36 | SEARCH orders USING COVERING INDEX idx_uid_status (user_id=?) |
user_id、status、amount |
0.40 / 0.41 | SEARCH orders USING INDEX idx_uid_status (user_id=?) |
两行的中位差 0.05 ms,几乎是平的。
覆盖索引的意思是,查询要的列全在索引里,读完索引页就能交差,不用回表。(user_id, status) 的叶子上存着这两列和 rowid,刚好够用,计划里就多一个 COVERING。多要一个 amount,索引里没有,只能拿着 rowid 回主键表把整行取回来,命中的每一行一次主键查找、一次随机页读。行少了这笔钱可以忽略,行多了它能把索引省下的全吃回去。50 行的时候我盯着这两个数看了半天,0.36 对 0.41,看不出任何东西,后来才想明白是自己把样本量选小了:要看出回表的代价,命中的行数得先上去,而那次我只想验证覆盖这件事成不成立,没打算量代价。
这次只有 50 行,回表的账没显出来。
所以这组数不能拿来说回表一定慢,它只说明回表在 50 行这个规模上便宜。同样一条索引换成命中十几万行的等值查询,覆盖和回表的差别会换一个量级,那个数我没另建表量过,不往表里写。
区分度低的列,只配待在索引尾巴上
user_id 撒在 2 万个值上,一百万行平均一个值 50 行;status 只有几种,一种 20 万行上下。索引把查询变成一段连续地址,这一段有多长,由前导列那个值决定。50 行是翻半页,20 万行是翻几百页,同样写着 SEARCH,价钱差两个量级。status 那条单列索引能赢,靠的还是覆盖索引,20 万行全在索引页里翻,一次回表都没有;要是这 20 万行每行都回表,35.88 ms 这个数保不住。后半句是我按页读的量级推的,没单独量。
列序给最常用的那组条件让路,不是给最干净的那列让路。
区分度决定这一段有多长,使用频率决定这段值不值得为它建。两件事都要看,只看一件,要么把 status 塞到第一位,要么把 user_id 踢出索引。
我量区分度的办法很土:把候选列挨个 select count(distinct col) from orders 跑一遍,拿一百万除一下,得到这个值在表里平均重复多少次。user_id 那一列算出来是 50,status 算出来是 20 万上下,两个数一摆,谁该排前面根本不用讨论。真到了业务库里,这一步经常卡住,因为分区表的分区键、软删除的标记、多租户的 tenant_id 这些都挤在同一张表里,算出来的数字跟线上过滤条件对不上,得把那几个固定的 where 子句一起带上重算。我那会儿是用一个小脚本把候选列和常用条件列成两列比着看的,列了七八行才把这层想清楚。
不等号和前缀 like,规划器先弃权
另一组实验,换一张一百万行六列的表,多一个 note 文本列,量两种索引明明在、却用不上的情况。第一种是不等号,where id != 25000,有索引没索引计划都是 SCAN orders,中位 3143.32 对 3233.21 ms,差在噪声里。
规划器不是不会用索引,是算过账。!= 排除一行,剩下九十九万九千九百九十九行都得取,每行都要回表,随机页读比从头顺序扫一遍贵。
不等号真正贵的地方不在判断。同一个条件只取 id 时,无索引 1066.567 ms,有索引 1053.791 ms,几乎一样;换成 select count(user_id),走覆盖索引,76.463 ms。代价不在扫表,在把剩下的五列搬出来:判断一百万行要一秒出头,搬六列要三秒。
判断躲不掉,搬列可以省。
第二种是前缀 like。note like 'n12%',note 上根本没建索引,170.94 对 158.25 ms,1.1 倍,量的是没有索引的样子。前缀匹配要靠索引加速,得那一列上先有树,还得是前缀本身进树。右边少一个字符都不算,%n12 这种前面带通配的,树没法定位,只能全扫,跟没建一样。我一开始以为 like 天然快,后来看到这条的正经用法是配合前置的通配符写法反过来验证:'n12%' 能走树,'%n12' 不能,差别跟列上有没有索引无关。
顺带记一条 MySQL 上更常见的:列上套了函数,或者 varchar 跟数字比触发隐式转换,索引会当场失效,type 从 ref 掉到 ALL。这两种我在 SQLite 上量不出来,写在这儿当提醒。失效跟用不上不是一回事。用不上是规划器算过账,觉得走索引不划算,索引本身还能用;失效是我把条件写成了它根本没法用的形状,函数、隐式转换、前导通配,条件没错,索引也没错,两边对不上。前者可以改数据分布或者调列序去争取,后者只能改 SQL。我一开始把这两个概念混在一起,看到 SCAN 就以为索引白建了,后来发现一个要动 DDL,一个只动查询,才分清楚该往哪边使劲。
五条查询摆成一张表,建法自己浮出来
三组数摆在一起,标准其实是四句话:前导列对不对,命中集合多大,要的列在不在索引里,条件会不会让规划器直接放弃。
| 查询长什么样 | 建什么 | 依据 |
|---|---|---|
| 只按 user_id 等值 | (user_id, status) 联合索引 |
前缀命中且覆盖,0.29 ms |
| user_id 加 status | 同一条 | 两列都在前缀里,0.28 ms |
| 只按 status,命中十几万行 | status 单独一条 | 低区分度只能靠覆盖,35.88 ms |
| 只按 status,想蹭那条联合索引 | 别建 | 退化成扫索引,189.94 ms,比不建还慢 |
命中过半的 != 或范围 |
别建 | 规划器多半直接扫表,回表更贵 |
2023 年 6 月我刚入行那阵,读 explain 只扫耗时那一列,计划那列从来不看。这个习惯改过来花了小半年,改完才知道快慢是结果,SEARCH 和 SCAN 才是原因。
现在建索引之前我先问三句:等值条件里最常用的那列排第几,命中集合占表多少,select 出来的列在不在索引里。三句过完,列序基本就定了,剩下的交给 explain,看它写的是 SEARCH 还是 SCAN。
那天下午抄的列序,五条查询里三条吃到了,两条被挡在外面。这个比例不算难看,可我当时并不知道自己在赌。