哈希索引为什么赢不了 B+ 树
哈希索引为什么赢不了 B+ 树
隔壁老康难度 ★★★☆☆ · 前置:加一台机器,九成的 key 都要搬家 | 一句话结论:哈希索引把一次等值查询压成一次桶定位,范围、排序、最左前缀这三件事它连门都进不去,所以能挑的时候还是挑 B+ 树。
六月十四号晚上,同一批查询我跑了两遍。
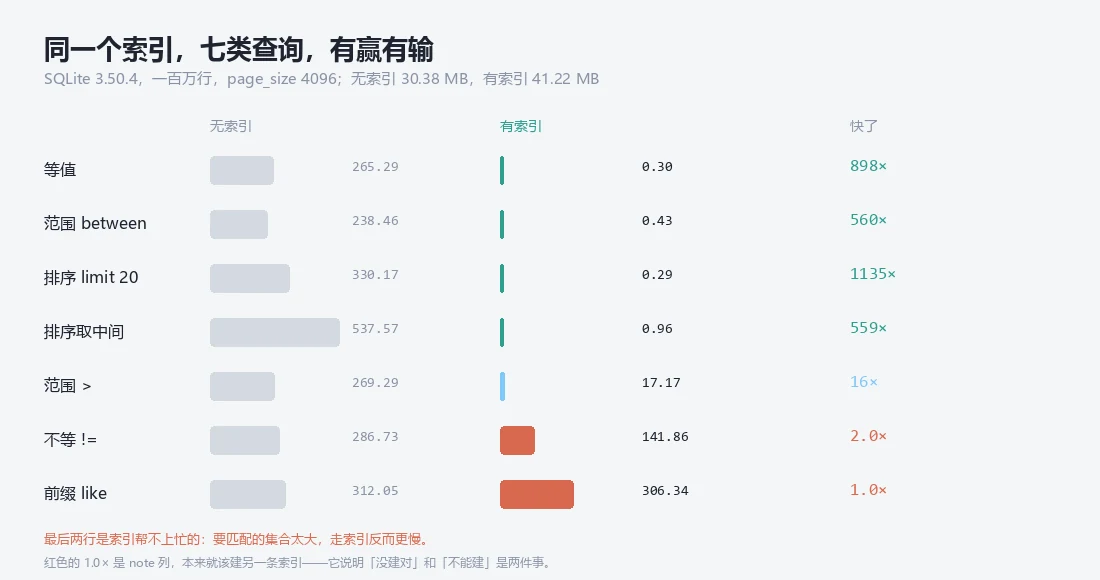
先建表。六列,id、user_id、status、created、amount、note,一百万行假数据灌进去,SQLite 3.50.4,页大小 4096。第一遍不建索引,七条查询挨个计时,数抄在便签上;第二遍给 user_id 建了索引,断开连接重开,同一批查询再跑。第二遍跑到第三条我停了一下,跟慢没关系,是那一行的数掉得太狠,我怀疑索引根本没生效,把 explain 调出来又看了一遍,看到 SEARCH user_id USING INDEX 才接着往下跑。
| 查询 | 无索引 | 有索引 | 倍数 |
|---|---|---|---|
等值 user_id = 12345 |
265.29 ms | 0.30 ms | 898× |
范围 user_id > 40000 |
269.29 ms | 17.17 ms | 15.7× |
窄范围 between 100 and 200 |
238.46 ms | 0.43 ms | 560× |
排序 order by user_id limit 20 |
330.17 ms | 0.29 ms | 1135× |
排序取中段 limit 20 offset 30000 |
537.57 ms | 0.96 ms | 559× |
不等 != 12345 |
286.73 ms | 141.86 ms | 2.0× |
前缀 note like 'n00001%' |
312.05 ms | 306.34 ms | 1.0× |
左边是没索引的一百万行,右边是同一张表加了索引。
文件从 30.38 MB 涨到 41.22 MB,页数从 7778 变成 10553,索引自己占掉 10.8 MB。
四行掉到一毫秒以下。
三行原地不动。
同一列,同一份数据,同一个索引,七条查询被劈成两半。快的四行里,等值 265.29 ms 变 0.30 ms,排序 330.17 ms 变 0.29 ms,窄范围 238.46 ms 变 0.43 ms;没动的三行里,!= 从 286.73 ms 到 141.86 ms,两倍,like 'n00001%' 从 312.05 ms 到 306.34 ms,一分钱没省。那天晚上我想弄明白的只有一件事,凭什么一半掉下去,一半不带动静。回去的路上我一直在猜,猜来猜去都是同一句,因为索引有序,可有序能解释排序,解释不了 != 为什么只快两倍。
等值那一行,哈希是赢的
哈希索引干的事很短。把 12345 丢进哈希函数,得到一个桶号,桶号换算成页号,读那一页。
一次定位,一次页读。
B+ 树要多走两步。从根页起步,比一次,跳下去;再比一次,再跳;落到叶子上。
三次页跳,就是 0.30 毫秒的大头。
桶里不止一条记录的时候,哈希索引也不慌,桶内再拿 key 比一遍就是了。桶挂得太长会退化成一条链表,那是实现没调好,不影响一次定位这件事本身。哈希索引在等值上只会更短,不会更长,同样是读一页,它把往下走的那两步省掉了。所以标题那句话得先收着讲,等值查询这一件事,哈希索引是赢的,赢得干净,一次桶定位对三次页跳,没有别的结构能把这个数再往下压。表里那 898 倍是 B+ 树跑出来的,哈希索引根本没上场,可它真上场也不会比 0.30 ms 难看。这一点必须说在前面,否则后面几节读起来像在替 B+ 树兜售。
写到这里我停了一下。接下来要说的全是它输的地方,输得一点也不含糊。
三层,一千万行还是三层
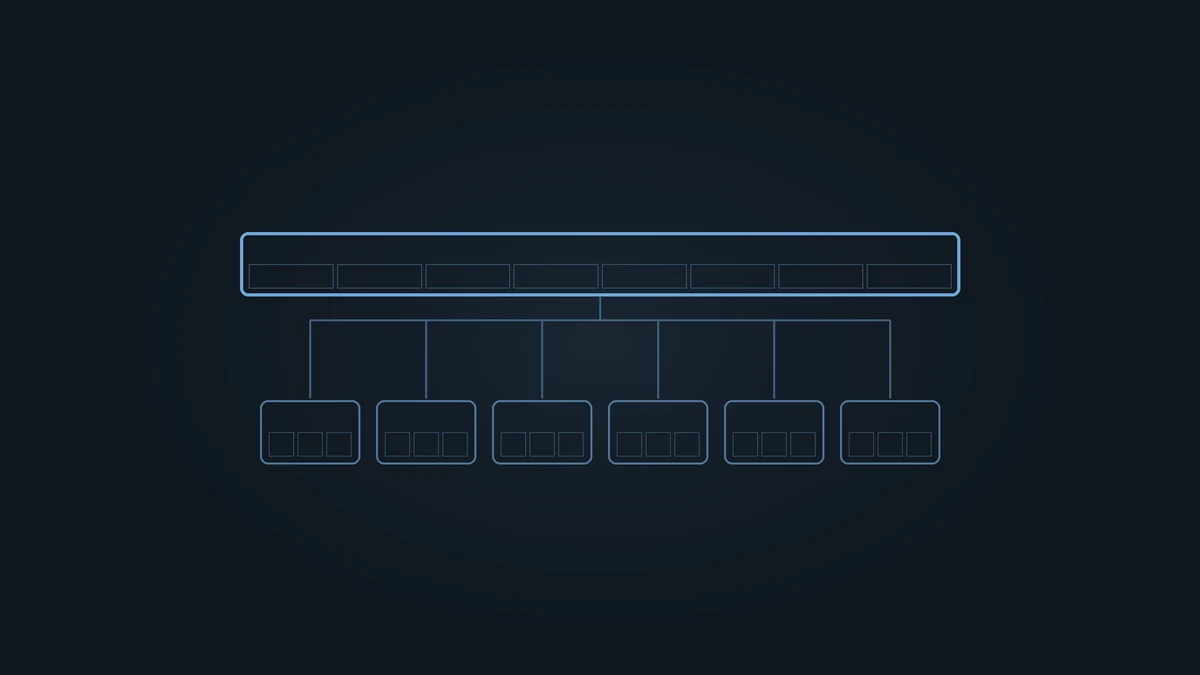
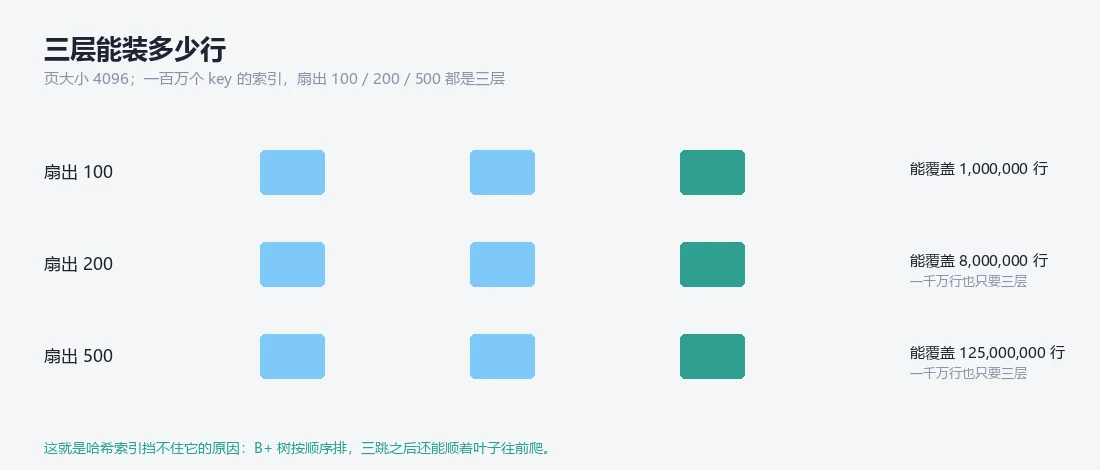
先说树高,因为后面所有的赢法都长在这上面。页大小 4096,一个内部节点能挂多少指针就是扇出(一个节点往下分几个叉),三层树能装的行数大约是扇出的三次方。扇出 100,三层到顶一百万行,刚好装下这张表;扇出 200,三层八百万行;扇出 500,又是另一个量级。一千万行落在中间,把扇出提到 300 就能盖到两千七百万行,照样三层。
一千万行,还是三层。
行数涨十倍,树高不动,这是 B+ 树最要命的地方。它不靠加深一层来容纳增长,靠的是最底下那一层多铺页,从根到叶的路径长度原地不动。索引变大这件事落在文件上是文件变大,落在查询上一点感觉都没有,一千万行的叶子页每个还是 4096 字节,只是页数多了几千。你要往里灌到上亿行,树才肯长第四层。
这就是它挡不住的原因。
哈希值不保序,范围只剩全扫
12345 和 12346 挨着,桶号能隔着一整个文件。
哈希函数把 key 打散,打散的意思就是不保序。不保序的后果只有一句,比 40000 大这个条件,变不成一段连续地址。
那就只能把每个桶翻一遍,269.29 ms,跟没建索引一个数。
表里那 17.17 ms 是 B+ 树跑出来的。它先定位到 40000 所在的叶子页,再顺着叶子一页一页往后读,一直读到末尾,六十万行一个不落。读的页不少,可每一页都装满了命中的行,每读一页换回几十行,15.7 倍就是从页满和页乱之间挤出来的。
页数能估。索引 10.8 MB 摊到 4096 字节的页上正好 2775 页,一百万行平分下来一页装三百六十条左右,六十万行就要顺序翻一千六百多页。
between 100 and 200 那行 560 倍是同一件事的另一头,区间只有一百行,一页就装下了,B+ 树定位一次扫一页就走完,0.43 ms。哈希索引连只扫一页都做不到,它不知道这一百行散在哪几个桶里,还是得把所有桶翻一遍。这两个倍数差的不是算法,是命中的行数。
桶号是乱的,顺序就没了。
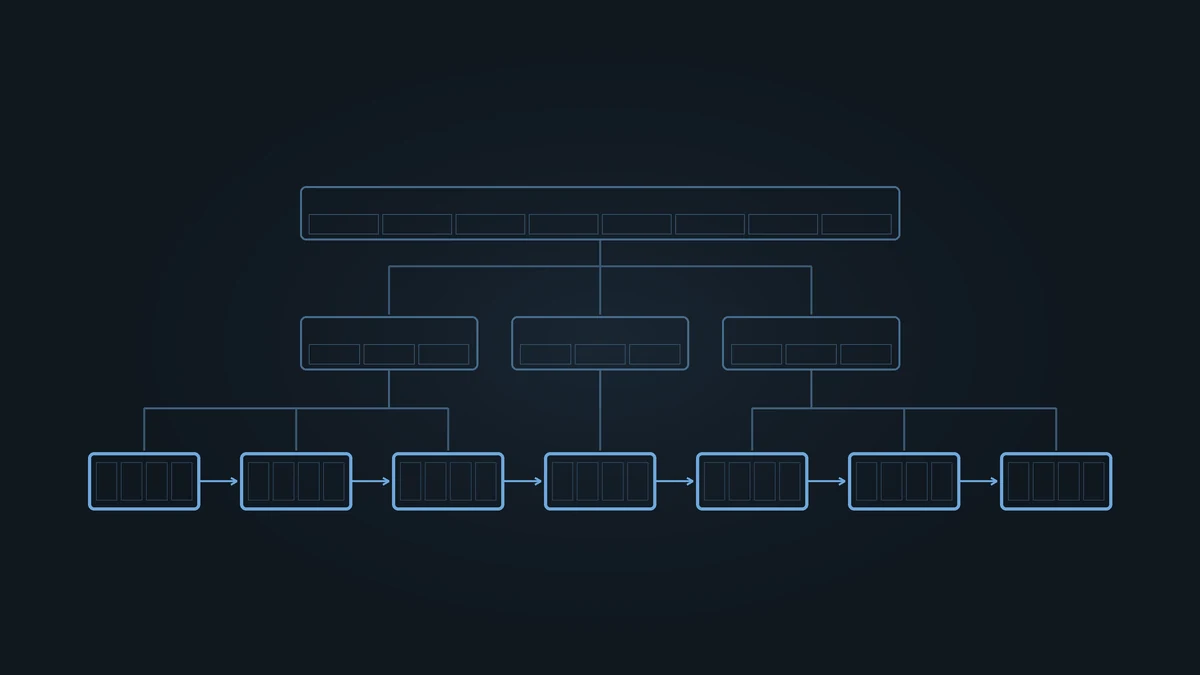
叶子本身就是一条有序链表
order by user_id limit 20 是 1135 倍,330.17 ms 到 0.29 ms,全表最快的一行,比等值还快一点。原因是它连 12345 都不去查。
B+ 树的叶子按 key 排好,页与页之间用指针串成一条双向链表。想按 key 的顺序取二十行,从最左那个叶子进去,顺着链表往前走,走到二十行收工,中间不排序,也不碰表里其余的部分。索引在这里不只是查找结构,它本身就是一份按 key 排好的副本,建索引那 10.8 MB 买的是这份副本,不是那三次页跳。
limit 20 offset 30000 那行 559 倍,537.57 ms 到 0.96 ms。它要多走三万行,0.96 ms 就是走这三万行的钱,这三万行全在索引页里走完,一次回表都没有,所以还是不到一毫秒。
哈希索引做不了这件事。桶里的记录按插入的先后躺着,跟 key 的大小半点关系没有,同一个桶里的两条记录,key 可以差一百万。要顺序它只能把命中的行全捞出来再排一遍,排序的代价跟行数成正比,limit 20 救不回来,因为排序得先把该排的排完。
联合索引排的是前缀,哈希算的是一个数
(a, b) 上建一棵 B+ 树,索引里的顺序是先按 a 排,a 相同的再按 b 排。
b 单独查用不了。
b 在索引里散落在每一段 a 的中间,不构成一列。
哈希索引把 (a, b) 当一个整体喂进哈希函数。a 单独查的时候,等于拿半个 key 去问桶号,问不出来。这一条在真表上比看起来要命,索引常常照着最左那一列建,右边几列顺手加上去,查询里偏偏只用右边那列,这种时候 B+ 树还能靠前缀往下走一半,哈希索引一步都走不动。
走一半的意思是,索引从头到尾是一段一段按 a 排好的,a 一定,后面那段就全在手里,b 在里面再找一次就行。
顺序能切,位置不能切。
不等号和 like 前缀,索引先退场
!= 12345 要排除一行,剩下九十九万九千九百九十九行还得一条一条判。
那 2.0 倍是这么来的,索引把整行读出来的次数省掉了,判这一百万次的活一点没省。命中的集合一大,索引就从帮手变成负担,一次命中一次回表,一百万次随机页读比从头顺序扫一遍还贵,规划器算过这笔账,有时候干脆不选它。141.86 ms 已经是它愿意帮忙时的上限。真正省不掉的是判断本身,索引能告诉你第几行在哪一页,告诉不了你这一行满不满足条件,那一步永远得把行拿出来看过才算数,九十九万九千九百九十九次全躲不开。
like 'n00001%' 那行 1.0 倍,因为 note 上压根没建索引。
这行量的是没有索引的样子,跟索引没关系。
要在前缀上加速,得在 note 上建一棵 B+ 树。前缀匹配在树里是一段连续区间,n00001 到 n00002 之间的 key 全是候选,扫这一段就够了。哈希索引在这里连建的资格都没有,两个前缀的哈希值之间没有任何关系,扫不到一块去。
内存里只查等值,哈希就够
再加一组对照。同样一百万行塞进 Python 的 dict,建索引 174.6 ms,等值查询一千次共 0.03 ms,摊到一次 30 纳秒。
SQLite 那 0.30 毫秒换成纳秒是三十万,差一万倍。
差的不在哈希函数上,在中间隔着的那一整套页管理。一次内存访问加一次哈希加一次比较就完事的活,进了磁盘格式就得先找页、再读页头、再在页里二分。代价还是落在范围上,五万个键里找一段区间,dict 只能把键全遍历一遍,1.12 ms,看着不慢,可它跟键的个数成正比,五万个键一个都没少看。
什么时候哈希就够,这组数说得很清楚,数据全在内存,访问只有等值,不需要顺序。MySQL 的 Memory 引擎默认给哈希索引,Redis 的 key 查找是哈希表,Go 的 map、Python 的 dict 都是同一类东西,没有一个是拿来做范围查询的。
我现在选索引之前会问四句,要不要范围,要不要排序,要不要按前缀查,联合索引右边的列会不会单独出现在 where 里。四件里有一件要,就建 B+ 树;四件全不要,数据又装得进内存,哈希就够,而且比树快。这张表还差几列没量,建索引本身要多久,每次 insert 多花多少,索引把页缓存挤掉多少,并发读写时锁落在哪,这几个数我没跑过,拿它去替别人拍板,底气不够。
下次碰到一张要选索引的表,我先查两件事,查询里等值和范围各占多少,有没有 order by。这两句问完,答案通常自己就浮出来了。