写多读少的世界里,B+ 树输了
写多读少的世界里,B+ 树输了
隔壁老康难度 ★★★★☆ · 前置:索引长成一棵 B+ 树,是被磁盘逼的 | 一句话结论:LSM 把随机写换成顺序写,代价是同一份数据被反复重写,写放大与读放大必须拿一头换一头。
我在 _local/ds-exp/d5/lsm 下新建了 main.go,一百一十六行。没有数据库驱动,没有临时文件,没有后台线程,只有一个 put 循环和几个 int64 计数器。它干的事很窄:把一棵 LSM 树往磁盘写了多少字节数出来。
写完 B+ 树那篇,有件事一直没落地。
那棵树把一次更新压成一次页写,4096 字节,原地改。读多写少的时候这是笔好买卖,页缓存一命中,连磁盘都不用碰。可要是一张表的写入是读取的几十倍,每次改一行都得动一整页,一页一页改下去,机械盘上是一次次寻道,SSD 上是一次次擦写。LevelDB、RocksDB、Cassandra、HBase、ScyllaDB 这几家没有一家用 B+ 树,全走 LSM,五家各做各的生意却走到同一条路上,背后多半有个代价被换出去了。
我想知道那个代价有多大。
那几天我在读 db_impl.cc,翻到 kL0_CompactionTrigger = 4 那一行停了很久。4 这个数不像推导出来的,像调出来的,调大调小分别意味着什么,我想用一个能跑的东西回答,而不是再读一遍文档。于是有了那个文件,它跟真实数据库没有关系:一笔 IO 都不做,只按规则记账,把每次落盘的字节加起来。
SSTable 的编码一行没写。
key 是 int64,value 大小写死 1 KB,布隆过滤器和 block cache 全当不存在,真实的读写延迟、缓存命中率、后台线程抢占,它一个都答不了。它能说的只有一件:照那套分层规则搬数据,同一份用户数据会被写多少遍。搬多少字节是数出来的,快多少只是推出来的,这两件事我分得很开。延迟受缓存、受调度、受盘上碎片影响,同一个程序跑两遍都能差出一截;字节数是确定的,规则定下来,跑几次都一样。所以它回答的是这套规则本身贵不贵,答不了线上要几块盘、要多少 IOPS。
攒满一块,整块刷出去
写入先进 memtable,一张有序的内存表,LevelDB 里是跳表。攒到阈值,比如 4 MB,整块冻住,后台按 key 排好序写成一个文件,这个文件就是 SSTable,sorted string table。写的时候从头到尾一次写完,中间不回头改任何一个字节,这也是整个结构的身家所在:磁盘最擅长的活是顺着往后写,它让每一次落盘都长成那个样子。原地更新正好相反,改的是随机位置上的一个页,机械盘要先把磁头挪过去,SSD 要先把整块擦出来再写回去。
写完一个文件,就再也不碰它。
SSTable 内部按 key 切成若干数据块,块内做前缀压缩、每十六条记一个重启点,块尾放索引,另有一块布隆过滤器,文件末尾是 footer。读的时候先读 footer 拿到索引块的位置,二分找到数据块,再读那一个块,一层目录一层数据,跟 B+ 树的内部节点指向叶子是一个意思。区别在于 B+ 树允许回头改,这里不允许。
想改,只能写一份新的。
刷出来的文件进 L0。L0 的文件之间 key 范围重叠,新的盖住旧的,读的时候得从新往旧一个一个查,所以 L0 一多读就慢。攒到 4 个,整体并进 L1。从 L1 往下,每层内部有序且互不重叠,容量是上一层的 10 倍,L1 装 64 MB,L2 装 640 MB,往后 6.4 GB、64 GB,六层摆下来,4 GB 数据稳稳落在第三层里。
容量梯度决定了后面所有的账。
它是我在代码里先定死的常数,不是算出来的。动它,等于换一道题。
四组参数,跑了一秒
场景按一次真实配置摆:4 GB 用户数据,每条 1 KB,一共 4194304 条;L1 容量 64 MB,层间放大 10 倍,共 6 层;L0 攒到 4 个文件开始合并。4 和 10 都是从源码抄的,kL0_CompactionTrigger 就是 4,MaxBytesForLevel 每层乘 10。机器是 i9-14900HX,32 个逻辑核,go1.27.2 windows/amd64,四组参数跑完不到一秒,因为它一笔 IO 都没做。write_buffer_size 的默认值也是 4 MB,所以第一组从 4 MB 起跑,另外三组我按四倍往上加。
四行数里只有两列在动。
| memtable | 写盘 | 写放大 | 刷盘次数 | 合并次数 |
|---|---|---|---|---|
| 4 MB | 136.8 GB | 34.19× | 1024 | 720 |
| 16 MB | 112.2 GB | 28.06× | 256 | 180 |
| 64 MB | 50.9 GB | 12.72× | 64 | 46 |
| 256 MB | 27.2 GB | 6.81× | 16 | 12 |
4 MB 那一行,136.8 GB 摊到 4 GB 用户数据上,34.19 倍。写进去 4 GB,盘上挨了 136.8 GB。memtable 抬到 256 MB,涨了 64 倍,写放大掉到 6.81,掉了五倍,可它还压在原地更新那行的 4.00 上面。下面两行对照是同一个分母:按 B 树的路子原地改,4194304 条更新每条改一页 4 KB,一共 16.0 GB,4.00 倍;纯追加不合并是 4.0 GB,1.00 倍,代价是读一次要翻 N 个文件。
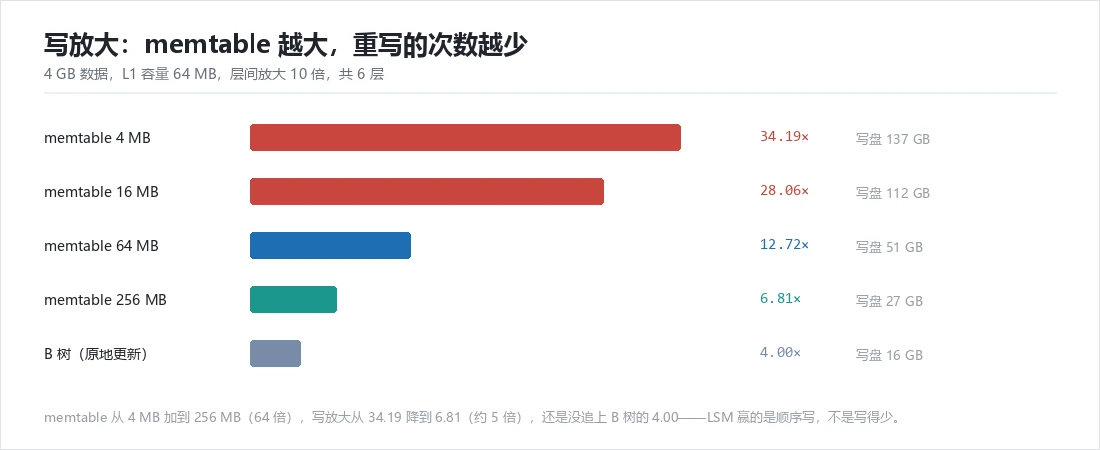
三行摆在一起,位置就清楚了。
三十四倍是一层一层堆出来的
一次 L0 进 L1 的合并要干三件事:把 L1 里和这批 key 重叠的部分读出来,把合并结果写回去,再把新数据写进去。规则就这一句,读重叠、写回重叠、写新数据,我代码里也是这么记的账。L0 跟 L1 的 key 范围完全重叠,所以重叠区就是整个 L1。一次合并读 64 MB、写回 64 MB、再加新进来的 16 MB,一共 144 MB 的写,只为搬 16 MB 的用户数据,这一层就摊到九倍。九倍是这么来的:读重叠 64、写回 64、写新数据 16,一百四十四除以搬走的十六。分母固定,分子里 64 那一项取决于 L1 能装下几批这样的新数据,64 除以 16 是四,memtable 越小这个倍数越大,第一层就越贵。
越往下越是这样,也越不是这样。
L2 有 640 MB,可一次从 L1 只压下去 16 MB,按比例只碰 640 MB 里的四十分之一,十六兆。搬的量大,碰到的比例小,两头互相抵消,所以层数往上加,倍数不会一层翻一倍,单层的倍数收敛在一个跟层间放大倍数有关的值上。这一条我第一版没想明白,把每一层都算成碰下一层全部,跑出来的数大得离谱。
顺着这个思路,写放大能拆成两截:一截是每搬一次要碰多少旧数据,一截是这种搬动一共发生多少回。前者由层的容量梯度定,后者由 memtable 定,两截乘起来才是那一列里的 34.19。L1 那 64 MB 在四组参数里一样大,可它被整体重写的回数差了六十倍:表里刷盘次数从 1024 掉到 16,合并次数从 720 掉到 12,写盘总量跟着从 136.8 GB 掉到 27.2 GB。memtable 调大没有改掉任何一条合并规则,它只是让同一套规则少跑了几轮。
变的只有次数。
真正决定这个收敛值的,是 memtable 有多大。
第一版里 memtable 是个摆设
第一版的 pushDown 只写了一条规则:这一层超容量就把超出量压下去,压的时候把下一层碰一遍。三组参数跑出来三个一样的数,4 MB、16 MB、64 MB 全是 18.02×。我第一反应是 fmt.Printf 的参数顺序错了,加了两行打印,才确认数没打错,是模型里那条规则跟现实对不上。
三个一模一样的数。
真实的分层合并碰的是下一层里 key 落在范围内的那一段,段有多大取决于这次搬下去多少,跟下一层总量没有直接关系。我把规则改成按比例碰一段,memtable 的大小才开始进入结果,四个参数终于跑出四个数。
这一版错得不难看,18.02 看着也挺合理,如果当时心里已经有一个 LSM 写放大十几倍的预期,我大概会把它当答案收下。
错得合理,才是最麻烦的那种。
改完撞出二百五十八倍
第二版改过头了,4 MB 报 258.81×,是现在的 34.19 的七倍半。这回数错得太狠,一眼能看出来,可原因找了不短时间。问题还在 pushDown:move 是本层挤出去的字节数,overlap 要按 move / cap 折算下一层该碰多少,注释里我写了这句话,代码里却把 overlap 直接取成了下一层的全部。
1 | // 改之前:下一层整段都碰 |
差的就是这一行,修完 34.19×。
这两个返工比 34.19 本身值钱。模型跑出来的数不对,第一反应不该是改结论,是回去看模型里哪条规则跟现实对不上。第一版那种错最麻烦,它给出的数落在合理区间里,你越信自己的直觉,越容易把它当成结论;第二版反过来,数错得离谱,反而逼着人去读代码,一行一行对着注释找哪句没落地。我现在写完一段模型,会先拿一个能手算的小例子对一遍,再去跑大数据。
离谱的数救了我一次。
读放大和空间放大,另外两笔
写放大只是三笔账里的一笔。读一次的顺序是:memtable、冻结待刷的 memtable、L0 里那四个文件、L1 到 L6 每层一个文件。L0 的文件范围重叠,一个都跳不过;下面的层有序不重叠,二分能定位到唯一可能命中的那个。最坏情况 1 + 1 + 4 + 6,十二次查找。十二次是这个布局的上限,也贴着下限:哪一层都跳不过,因为谁都不保证 key 不在自己这里。层数往上加一次,这个数跟着加一,写放大省下来的那部分,读这边按层收回去。
B+ 树是三次页跳。
这是从布局上数出来的,不是量出来的,模拟器压根没有读的代码。布隆过滤器把大部分空查找挡在内存里,一次探测就否掉,只有疑似存在才真去读块。挡掉多少取决于位数和误判率,热点数据在 block cache 里,连这一步都省了。所以读放大不是十二倍那么吓人,可在缓存没命中的时候,它就是十二次 IO 对三次。这一项我没有模拟,位数和误判率一换结论就换,凭空给个数不如不给。但内存账可以估个量级:按每个 key 十位算,一亿个 key 是 125 MB,每层一份,六七层就是小一 G。工业界那些优化——只对整 key 建、分块建、按层调位数——省的都是这笔钱,而它跟数据量线性相关,跟层数也线性相关,两个维度一起涨。空间放大是第三笔。同一份 key 在合并完成前,旧版本留在上层,新版本在下层,删除标记要一路带到最底层才敢真删,所以磁盘占用会在一段时间里明显大于用户数据本身,合并越慢、层数越多,堆得越多。B 树那边浪费的是页内空洞和分裂留下的半页,形状不一样,也一样浪费。
三笔账不可能同时压到最小。
合并策略换的是同一笔钱
我跑的是 leveled,每层内部有序不重叠,读放大低,空间放大低,写放大高。换成 tiered 就全反过来了:一层里放好几个大小相近、key 范围重叠的文件,攒够几个再一起并下去,每次搬的数据不用重写下一层的旧数据,写放大能压到个位数,代价是读的时候要把这些文件都查一遍,空间也堆得住。RocksDB 里这两条路都有,leveled 是默认,universal 介于两者之间;Cassandra 早年用 size-tiered,后来也补了 leveled。还有一路是把 value 挪出去单独存日志,索引里只留 key 和指针,写放大的大头跟着 value 一起搬走,代价是读 value 多一次随机 IO。三条路选的是三笔账里先付哪一笔,没有白拿的。
我按这个顺序排:先看读写比,偏写再往下走;再看写入是按时间追加的还是散在整张表上的;剩下看内存给不给得起,memtable 能开多大,直接决定写放大落在 34 还是 6。反过来排,就是拿参数凑结论。
各自的地盘
B+ 树的地盘是读多写少。范围查询、排序、前缀匹配,它一路顺着叶子走,路径长度稳定,读延迟可预测;更新分散在整棵树里,命中缓存的那部分连磁盘都不碰。MySQL 的 InnoDB 到今天还用 B+ 树,理由很朴素:它的负载里读的比重大,写放大那笔账还没到肉疼的程度。数据量再往上,一次更新要动的页数也不涨。范围扫描这点更明显,between 一条语句顺着叶子链表往后走,走多少页读多少页,不用回头。
一次更新,三页。
LSM 的地盘是写多读少,写入本身还得顺着时间往后追加:日志、时序点、消息堆积、埋点。这类负载天然按时间往后追加,LSM 连排序都省了一半。机械盘上它的优势最大,顺序写和随机写差着几个数量级。换到 SSD 上这个差距被抹掉了很多,随机写没那么贵,那 34 倍的写放大就变成实打实的带宽和寿命。寿命这件事我就算不清了,TBW 怎么折算成实际年限,取决于盘的型号、写入分布和写放大在固件那一层又被放大了多少,我手里的数到不了那一步。
闪存普及之后又有人回头去看 B 树变体,原因也在这里。
我现在的判断很短:先问这张表的读写比,再问写入是散的还是顺着时间来的,两个答案都偏向写,才轮到 LSM。34.19 这个数只对这套参数成立,memtable 加到 256 MB 就是 6.81,参数一换结论跟着换,把它当成 LSM 的固有属性,跟把 B+ 树说成永远快一样不靠谱。参数先落地,结论才有意义。