unsafe 是一张随时会过期的通行证
unsafe 是一张随时会过期的通行证
隔壁老康难度 ★★★★★ · 前置:泛型带来的是形状,不是运行时检查 | 一句话结论:unsafe 借给我的是编译器内部的布局知识,它省下来的每一次复制、每一次类型检查,都要用可移植性和回收器的信任去还。
我第一次真正用上 unsafe,是在一个解析二进制协议的包里(顺手说一句,那会儿我对它唯一的理解就是能省一次复制)。那个包做的事很单调,按固定偏移从一段 []byte 里读出整数和变长字段,再拼成结构体。
写得慢不是因为逻辑难,是因为每一步都要把字节拷出来,切小段、转成 string、再塞进字段,一个报文上百个字段,中途拷出来的内存比报文本身还大,GC 的压力也跟着上来。那阵子我在翻 runtime 的源码,看见它自己也在用 unsafe 做同样的事,就把那段思路抄了过来,切出来的几段直接用指针指过去,一个字节都不搬,看着干净,跑起来也快。跑通那天我挺得意,觉得自己找到了一条别人不肯走的捷径。
那条路确实短,短到我根本没意识到它绕开的是编译器原本替我守着的那道门,门后面还排着什么,我当时一点概念都没有。
后来这段代码在一次工具链升级里给我上了一课。听起来像白捡的。
那篇泛型写完以后我一直在想它的反面。我是 2023 年 6 月才开始写 Go 的,语法熟得很快,对运行时底下那层东西却一直隔着一层雾。泛型是让编译器把类型钉死在编译期,unsafe 是让我绕过编译器自己动手,一个把决定提前,一个把责任推回给我。
先把尺寸量出来
先用 Sizeof 把一排类型量一遍。bool 占一个字节,int 在 64 位上占八个,int32 占四个,string 十六个,[]byte 二十四个,map、chan、func 三个都是八个,interface{} 十六个,空的 struct 是零。这几行数字看着平淡,其实每一个背后都有一段设计。string 那十六个字节是两个机器字,一个指针一个长度,[]byte 那二十四个是三个机器字,多出来的那个是 cap,map 和 chan 在变量里只放一个指针,真正的结构在堆上,所以量出来永远是八,而 interface{} 的十六个是类型字加数据字,空 struct 之所以是零,是因为它一个字段都不占,编译器连一个字节都懒得给它。
这些解释我在写切片和字符串那两篇的时候都翻过一遍,换到这一篇再量一次,是因为接下来所有的事都要站在这几个数上。数字本身跟 CPU 型号、主频、GOMAXPROCS 设成几都没有关系,它们由目标架构的字长和对齐规则决定。尺寸只是半个答案。另一半在偏移里,而偏移会把尺寸没说的那部分补上。
1 | Sizeof(bool)=1 Sizeof(int)=8 Sizeof(int32)=4 Sizeof(string)=16 Sizeof([]byte)=24 Sizeof(map[string]int)=8 Sizeof(chan int)=8 Sizeof(func())=8 Sizeof(interface{})=16 Sizeof(any struct)=0 |
十三个字节撑成了二十四个
我拿一个只有三个字段的结构体试(当时是在纸上先算了一遍才敢写代码),A 是 int32,B 是 int64,C 是 byte。三个字段本身的尺寸加起来是四加八加一,十三。可偏移量打出来是 A 等于 0,B 等于 8,C 等于 16,而 Sizeof 报的是二十四。中间那些缺口不是我写的,是编译器为了对齐填进去的,int32 后面空四个字节,让 int64 落在八的倍数上,byte 后面空七个,让整个结构体的尺寸是最大对齐值的整数倍。十三和二十四之间差的十一个字节,谁也没有声明过,它们是布局规则算出来的,规则本身很稳,写在语言规范和各个编译器的实现里。我第一次看见这组数的时候愣了几秒,因为在我脑子里那个结构体就是十三个字节,是我按字段一个个加起来算的,而编译器给我的答案是二十四,多出来的部分我一份也没写。
对齐是先决条件。可规则稳,不等于我有权把算出来的结果抄进自己的代码。
我那次踩的坑就在这儿,我用 Offsetof 算出一个字段的位置,把它写死成一个常量,带进了一个手写的序列化函数里,本地跑得很好,测试也过了。
后来有人在这个结构体前面加了一个字段(加的时候谁也没想起来去看那段手写偏移),偏移量全变了,我那个常量没变,那段代码就安静地读错了一个字段,错得很久才被发现,因为读出来的值依然是个合法的整数,只是不是原来那个。
找到它的过程也没什么英雄色彩,是一次对账的时候两边数字对不上,我从输出往前一行一行倒推,才落回这段看起来毫无问题的常量上。
那次之后我对这类型代码多了一个习惯,凡是写死的偏移量,旁边必须有一句注释说明它是按哪个版本的布局算出来的。
1 | Offsetof: A=0 B=8 C=16 (struct{A int32; B int64; C byte} 的 Sizeof=24) |
编译期常量,运行时一分不花
Sizeof 和 Offsetof 有一个容易被忽略的性质,它们在编译期就是常量,不产生任何运行时开销。写 unsafe.Sizeof(x) 的时候,编译器根本不会去读 x,也不会为这次调用生成一条指令,它只是从类型信息里取一个数,把结果当成字面量塞进表达式里。
所以这两个函数挂在一个叫 unsafe 的包下面,实际上是这一组函数里最安全的那两个,安全性跟写一个 const 没有区别。危险的不是这两个数,是拿到这两个数以后我开始假设它永远不变,手写偏移、手写长度、手写位域,一旦写死,就变成了一份编译器不知道的布局副本。副本这个词我用得有点重,可我想不出更准的,因为编译器算布局的时候并不读我的常量,它读的是类型,我的常量和它算出来的结果只是碰巧相等,哪天不相等了,它也不会来找我报错。编译器不认识你的承诺。
换个角度看,它们更像一个只读的窗口,它让我看见编译器怎么排内存,而看见不等于有权修改。
看见之后拿它去算一个必须永远成立的等式,等于把一次性的观察变成了一个永久的前提,前提错的那天,代码本身不会有任何一行报错。
uintptr 是一串没人认领的数字
真正开始危险的地方是 uintptr。它在类型系统里的身份是一个无符号整数,和 int 一样可以加减、可以比较、可以存进全局变量、可以当 map 的键,唯一特殊的地方是它的宽度刚好装得下一个指针。也正因为它是整数,垃圾回收器在看栈和堆的时候不会把它当成引用,一个只活在 uintptr 里的地址,对回收器来说跟一个随手写下的常量没有区别,它不会因为栈上还留着这个数,就认为那块内存还有人用。这不是缺陷,这就是定义,语言规范写得很直白,uintptr 只是一个整数,不是指针,谁把它存下来,谁就得自己保证那块内存还活着。我一开始不太理解为什么要把话说得这么绝,后来想通了,回收器能做的判断只有一个,就是这个地址有没有人持有,而整数在它眼里没有身份,它没有义务为一个我不再用的数字留住一整个对象。这段内存随时会走。上面这两行语法上完全合法,编译器不会提醒一个字。但在两行之间只要发生一次回收,p 指向的那块内存就可能被判断成没人用,被收回去,第二行拿到的就是一个悬空的地址,读它是在读别人的内存,写它是在破坏别人的内存。
而 unsafe.Pointer 不一样,它在表达式里是活的,回收器认它,只要它还指着,那块内存就还在。所以规则才要求这两步写进同一个表达式里,中间不留任何可以被抢占的缝。这句话我读了很多遍才有体感,它不是一句保险条款,它说的是回收器的工作方式,只要有一瞬间没有活的指针指着那块内存,它就有权动手,而我的代码对那一瞬间毫无察觉。
中途被 GC 搬走一次,这个指针会指向哪?
1 | addr := uintptr(unsafe.Pointer(p)) |
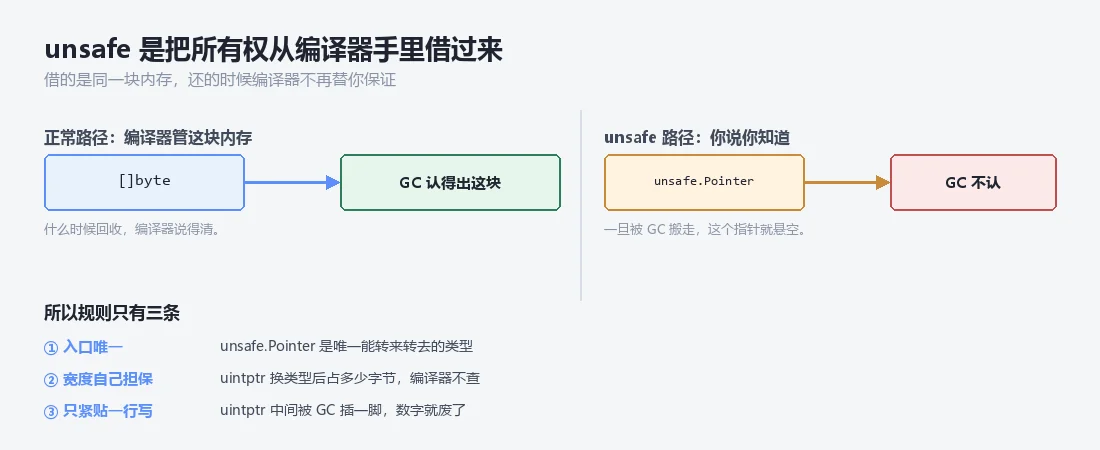
规范里给 unsafe.Pointer 列了四条转换规则,四条刚好凑成一个环,所有合法的玩法都在这四条边上走。
| 第几条 | 规则 | 我的记忆点 |
|---|---|---|
| 1 | 任意指针类型 → Pointer |
入口只有这一个,别的类型进不来 |
| 2 | Pointer → 任意指针类型 |
换身份,宽度靠调用方自己担保 |
| 3 | Pointer → uintptr |
数字掉了,回收器不再认它 |
| 4 | uintptr → Pointer |
只能紧贴第 3 条写,中间不能有别的事 |
反过来的那条路是堵死的,把一个 *int32 直接写成 *int64,编译器当场停下,因为这两件事之间的转换不是类型系统能够担保的,宽度对不上,对齐对不上,谁也没法保证换完之后读到的是自己以为的东西。
四条规则我只记住了其中一条的使用场景,就是指针和整数之间那两次转换必须贴在一起。其余的场合我宁可多写一行,把中间值放进一个局部变量。中间那一步是必须的。很多看起来像零拷贝的技巧其实不在这四条边上,它们靠的是把两个结构一样的指针类型绕一圈,Pointer 当中间站,绕完就换了个身份。
这种写法之所以还能跑,是因为两边的头在内存里长得一样,而长得一样这件事,同样是编译器说了算,不是规范承诺给我的。
零拷贝省下的是复制,借来的是责任
四条规则最实用的地方,是让 []byte 和 string 互相看一眼对方的内存。string 的头是十六个字节,[]byte 的头是二十四个,多一个 cap,前两个字段的位置和含义都一样,所以只要把指针和长度交出去,就能造出一个新的头,底下的字节一个都不动,省下的就是那一次复制。
1 | unsafe.Sizeof("")=16 unsafe.Sizeof([]byte(nil))=24 |
StringData 比出来是 true,说明两个头指着同一块内存,这次转换一个字节都没搬。切出来的 string 只活在一个函数里的时候,这个办法很划算,代价只落在约定上。省下的每一次复制都要还。约定是这样的,string 在 Go 里默认不可变,任何人拿到它都可以放心地长期持有,甚至把它当 map 的键存起来。
写法整齐了,责任没变。
如果底下那块内存其实是一个还在被写的 []byte,这个默认就破了,错误会出现在离修改点很远的地方,查起来的时候那个 string 看起来毫无异常,go vet 也不会说一个字。
另外两个口子是 unsafe.Slice 和 unsafe.Add。Slice 能从一个数组指针造出切片,我给了一个四个元素的数组,造出来的切片打出来是 [10 20 30 40],长度和容量都是四。
1 | made slice: [10 20 30 40] len=4 cap=4 |
Add 做的事更小,它只在指针上做一次加法,我从数组头往前挪两格,打出来是 30。
这两个函数的意义不在于它们能干什么,而在于它们把以前必须手写 Pointer 算术的地方,收成了两个签名清楚的函数,让我少写两行 Pointer 和 uintptr 之间的来回倒腾。
真正零拷贝转出来的字符串打出来是 hello,看着和普通字符串一模一样,没有任何标记说明它是借来的。
类型系统不会替我记住这件事,只能靠我自己在代码里守住边界,比如承诺这个 string 不越过创建它的那个作用域。
1 | zero copy string: hello |
linkname 借的是符号名,不是 API
比 unsafe 更少人用的一个是 //go:linkname。它写在函数声明的上面,能让我直接链到另一个包里没有导出的函数,包括标准库里的那些。它绕过的不是类型系统,是包的边界,链接器按符号名把两边的函数接上,中间没有任何一层检查会问我一句凭什么。
它依赖的东西很脆,符号名是编译器的实现细节,不是 API,标准库的维护者没有任何义务保住它,一个小版本改掉一个内部函数的签名或者名字,链接就断了,或者更糟,连上了但是意思变了。
函数名在小版本里是可能改的。
我后来想明白,这套机制之所以存在,是因为标准库内部确实有一些东西需要跨包共享,而它并不打算把那些东西变成对外的承诺,它给自己留的门,我跟着走进去就等于跟着承担了它的维护成本。
标准库自己在用它,runtime 和 sync 之间就有几处这样的连接,代价是每次升级工具链都得重新验证一遍。
我跟着用过一次,那次之后我把它从自己的代码里删掉了,理由很简单,出事的时候我分辨不出是哪一层的问题。
每一次升级都要重新验一遍
把这些摊开看,unsafe 给我的其实是一份编译器内部的布局知识,它把那些本来只在编译期成立的假设,临时借给我在运行时用一下。借来的东西有两个特点:
- 它随时可以变。
- 它变的时候不会通知我。
字段顺序、对齐规则、string 和 slice 的头长什么样、某个内部函数叫什么名字,这些在上一个版本里成立,在下一个版本里谁也没有担保它还成立,而我的代码看上去一如既往地干净,编译也一样通过,问题只会在某个特定的输入上冒出来。
它只保证这个版本编得过。
偏移量写死在业务代码里,迟早出事。
版本一变,全都得重新量一遍。go1.27.2 上量出来的这几个尺寸,换一个架构、换一个大版本,有几个会变。int 在 32 位上就是四个字节,指针从八个变四个,头的尺寸跟着缩,偏移量跟着重排,我抄下来的一整套常量在那边全部作废。
用 linkname 抄近路去调一个标准库的内部函数,也不行。
所以我现在给自己划的线很短,看一眼布局、量一个尺寸、写一段带注释的转换,这些可以。
那份通行证是有期限的,期限写在编译器里,不在我的代码里。
每次升级工具链,我都得回头把用到 unsafe 的那几处重新翻一遍,量一遍,确认数字没变、假设还成立,全部做完才敢说这段代码在新的版本上是对的。