哈希表的 O(1) 有三个前提
哈希表的 O(1) 有三个前提
隔壁老康难度 ★★★☆☆ · 前置:别猜,量一遍 | 一句话结论:O(1) 是平均值,平均的前提是哈希把 key 摊开、桶留着余量、冲突不把尾巴拖成几千步。
接的第一个活是给一个统计脚本提速。脚本本身没什么可看的,读一批日志,按 key 累加,再打一张表。我一开始怀疑磁盘,把读文件那一段单独拎出来计时,才发现它只占一小截,剩下的时间全花在把 key 塞进那张 map 里。当时我对 map 的全部认识就一句话:哈希表,查找 O(1),一次到位。既然一次到位,一百万条日志就是一百万次,不该慢。
可它就是慢。
我想知道那个“一次”到底是几次,就在自己机器上把表拆开重写了一遍,只留三样东西:一个桶数组、一个探测循环、一个计数器。用的是开放寻址加线性探测,key 算出一个下标,那个位置被占了就往后再看一格,一直看到空位,每看一格计数器加一。
循环短得可以抄在便签上。
1 | for i := 0; ; i++ { |
桶数取 2 的二十次方,一百零四万八千五百七十六个,mask 就是桶数减一。位与能代替取模,前提是桶数是 2 的幂:对一个 2 的 k 次方取模,数学上等于留低 k 位,而 & (2^k - 1) 干的正是这件事,一条指令,比除法快一个数量级。代价是桶数不能随便定,想加一倍只能翻倍,不能加三成。哈希函数准备了五个:FNV-1a 的 64 位版和 32 位版,Go 运行时自己的 maphash(它每次进程启动换一次种子),还有两个我故意写坏的凑数版,一个把 key 的每个字节加起来,一个只看前四个字节。前两个是从教科书上抄的,第三个是真正在用的东西,后两个是我拿来当反例的,我想看看一个坏哈希能把表坏到什么程度。一百万个 key 各插一遍,读数是这样。
| 哈希函数 | 插进去多少 | 平均探测 | 最长探测链 |
|---|---|---|---|
| FNV-1a 64 | 1000000 | 11.069 | 4261 |
| FNV-1a 32 | 1000000 | 11.235 | 3701 |
| maphash(Go 运行时随机种子) | 1000000 | 11.253 | 3203 |
| 字节求和 | 9204 | 4346.377 | 9102 |
| 只看前 4 字节 | 8944 | 4472.500 | 8944 |
字节求和那一行停在九千二百零四个。它每插一个 key 平均探了 4346.377 次,最长的一次走到 9102 步,撞上预算上限,整个插入就放弃了。只看前四字节更靠前一点,8944 个,平均 4472.500,最长 8944 步,正好等于插进去的个数,说明每一次插入都在同一条链上一路走到头。这两个函数把不同的 key 映到同一个下标的概率高得离谱,一百万个 key 挤在几千条位置序列上,第一次落位是别人的,往后挪一格还是别人的,一路挪到预算用完。这不是慢一点的事,这是根本装不进去。
前三个那一半,读数平淡得多。
平均十一,最长四千二百六十一
一百万个 key,FNV-1a 64 平均探 11.069 次,FNV-1a 32 是 11.235,maphash 是 11.253。三个数贴在一起,差不到百分之二,最长的那一条差得多:4261、3701、3203,maphash 比 FNV-1a 64 短了一千多步。
平均差 0.184,最长差一千多。
哪个是真的?
两个都是,只是它们回答的不是同一个问题。平均问“随便挑一个 key,它要找几次”,最长链问“最倒霉的那个 key 要找几次”。文档里那个 O(1) 用的是前一个答案,你在一次请求里等的往往是后一个答案。
平均是对这一百万个 key 平均。分母是一百万次插入,分子是每次插入看了多少个位置。它不对桶平均,也不对时间平均。
换分母,同一张表给另一个数。
一百零四万八千五百七十六个桶装一百万个 key,装载因子 0.954(就是 key 数除以桶数),平均每个桶 0.95 个 key。这个数看着舒服,看着就像一次落位,两次就够用,可同一张表量出来平均 11.069 次,最长 4261 次。这一组用的是 FNV-1a 64;下一节那张装载因子表换成了 maphash,数是另一组,别把两边的“最长”直接比。0.95 是桶的密度,11.069 是查找的代价,两个数之间隔着的那一层正是装载因子:桶比 key 多的时候是前一个数说话,桶只比 key 多一点点的时候是后一个数说话。教材推 O(1) 的时候想的是前者,程序碰到的是后者,一次落位的概率不到百分之五,剩下九成多都得往后走。
而装载因子是我能选的。
装载因子把 1.156 抬到 11.164
桶数翻两倍、翻四倍,key 一个不动。
| 装载因子 | 桶数 | 平均探测 | 最长链 |
|---|---|---|---|
| 0.238 | 4194304 | 1.156 | 11 |
| 0.477 | 2097152 | 1.454 | 35 |
| 0.954 | 1048576 | 11.164 | 5146 |
装载因子 0.238 的时候,平均探测 1.156,最长 11。0.477 的时候是 1.454 和 35。0.954 的时候是 11.164 和 5146。装载因子涨了四倍,平均探测涨了差不多十倍,最长的那条从 11 涨到 5146,四百多倍。这条曲线有闭式解,线性探测的成功查找,期望探测次数是 0.5 × (1 + 1/(1−α)),α 是装载因子。代进 0.477 得 1.456,实测 1.454。代进 0.238 得 1.156,实测也是 1.156。代进 0.954 得 11.37,实测 11.164。
公式和实测咬得很紧。
形状比分母有意思。α 从 0.238 走到 0.954,1−α 从 0.762 掉到 0.046,它的倒数从 1.31 涨到 21.6。装载因子每往上挤一点,代价不按比例涨,它撞的是分母里那个越来越小的数。扩容阈值不是拍脑袋定的,在某个比例之前扩容,代价还能压在一两次探测里,过了那条线,每一次插入都在付利息。
扩容买的是分母。
顺带说一句桶数翻倍时的那次搬家怎么省:桶数从 2 的 k 次方翻到 k+1 次方,mask 多出来的那一位正好是旧桶数。一个 key 原来落在 i,翻倍之后要么还在 i,要么挪到 i 加旧桶数,没有第三种可能——决定它去哪儿的,就是这个 key 的哈希值和旧桶数相与那一位是 0 还是 1。所以扩容不用重新算一遍哈希,也不用全表打散,看一位就够。Java 的 HashMap 就是这么写的,(e.hash & oldCap) == 0 留在原位,否则挪到原位加旧容量。这条我第一版没想到,以为扩容一定得把所有 key 重新散一遍。
二十三万八千个 key 不止探一次
平均值算完,我把每个 key 的探测次数也存了下来。
| 探测次数 | key 个数 |
|---|---|
| 1 | 761604 |
| 2 | 140882 |
| 3 | 48549 |
| 4 | 21855 |
| 5 | 11226 |
| 6 | 6220 |
| 7 | 3544 |
| 8 | 2173 |
| 9 | 1349 |
| 10 | 844 |
| 11 | 558 |
| 12 | 349 |
| 13 | 274 |
| 14 | 189 |
| 15 | 113 |
| 16 | 82 |
| 17 | 56 |
| 18 | 33 |
| 19 | 33 |
| 20 | 10 |
| 21 | 17 |
| 22 | 11 |
| 23 | 8 |
| 24 | 6 |
| 25 | 3 |
| 27 | 3 |
| 28 | 1 |
| 29 | 2 |
| 30 | 2 |
| 31 | 1 |
| 33 | 1 |
| 38 | 1 |
这张表来自一次完整的运行,三十二个档位加起来正好一百万个 key。maphash 的种子是每次进程启动时重新抽的,重跑一遍每个格子都会变几百个,但形状不变,最长那根尾巴每次落在三十几到四十出头。
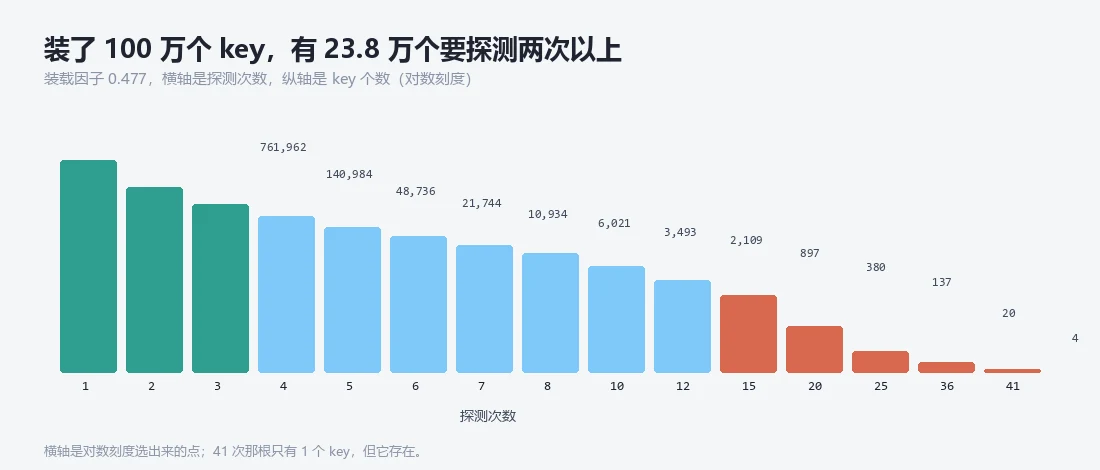
装载因子 0.477 那一行,一百万个 key 里 761604 个第一次就落在自己的位置上,剩下的 238396 个要探两次以上,接近四分之一。两次的 140882 个,三次的 48549 个,四次的 21855 个,五次的 11226 个,到十次还有 844 个,尾巴一路拖到 38 次。1.454 这个平均数长在这条分布的中间偏左,它离 1 很近,近到看上去像每个 key 一次就到。
它离长尾很远。
平均数的本事是把一整条分布变成一个数,代价是那条分布从它里面消失了。1.454 这个数看不出 238396,看不出 38 次那一个,也看不出 761604 那些一次就中的,尾巴也不是均匀的,线性探测的尾巴是一整片连着的区域:key 落在 i,i 被占了看 i+1,i+1 也被占了再看 i+2,冲突连成片,越挤的片越长。所以最长的探测次数不止平均值的几十倍,是几千倍,装载因子 0.954 那张表里,平均 11.164,最长 5146。
这四千多步要一步一步走完。好处是地址挨着,一条缓存行装得下几十个槽位,硬件预取跟得上。坏处是每一步都得等上一步的结果,前后串成一条依赖链,谁也不能提前。
顺序上占便宜,延迟上吃大亏。
链地址把代价堆进一个桶里
换一种冲突处理方式,坏哈希的形状就变了。
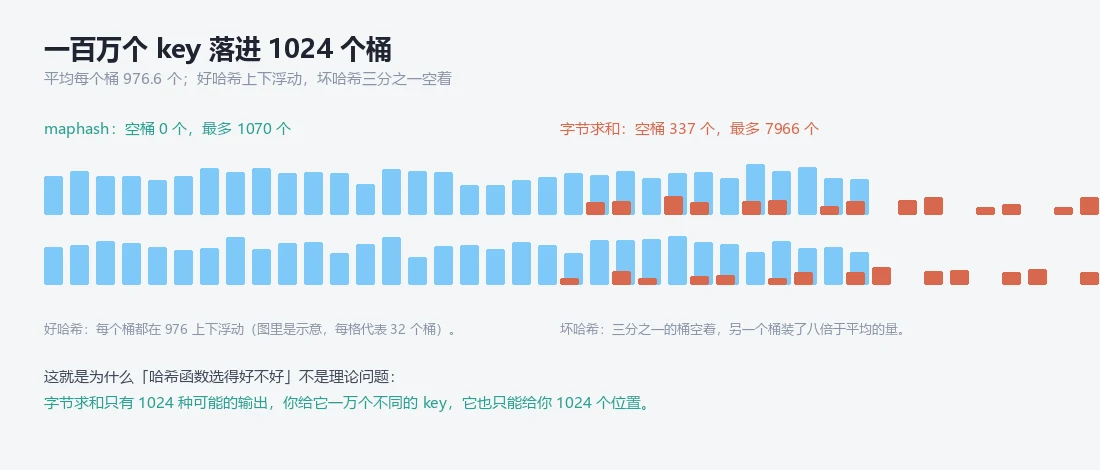
链地址不做探测。key 算出一个桶号,撞了就挂在那个桶的链表后面,桶里已经有几个不影响它落位,一百万个 key 落进 1024 个桶,平均每个桶 976.6 个。maphash 那一行,1024 个桶里一个空的都没有,最挤的装了 1070 个,比平均多不到一成。字节求和那一行,337 个桶是空的,三分之一的桶一个 key 都没分到,最挤的装了 7966 个,是平均的八倍。
| 哈希函数 | 空桶数 | 最挤的一个桶 |
|---|---|---|
| maphash | 0 | 1070 |
| 字节求和 | 337 | 7966 |
同样的桶数,同样的 key 数,一张分布是平的,一张是塌的。平均长度在这两张表上是同一个数,976.6。它在第一张表里是有信息的:分布平,最长的 1070 只比平均多一成,随便挑一个桶,长度都在这个数附近,到了第二张表,同一个数开始撒谎,三分之一的桶空着,最长的一条 7966,落进哪个桶全看运气。退化的形状也不一样,开放寻址坏起来是一整片连着的区域变长,探测在里面挪,链地址坏起来是几条链变长,查找在链上走。
计数器只数步数,不数钱。
链地址的每一步是一次指针跳转,跳到的节点在堆上,地址是散的。开放寻址的每一步是比较相邻的两个槽位,多半落在同一条缓存行里。同样走一百步,两种走法的价钱差很远,所以 key 小、桶里放得下的时候,开放寻址划算,key 很大、每一步都要整块比较的时候,链地址反而省,因为它只搬一个指针。这条判断不在复杂度表上,它在缓存里。
五十六字节一个 key,三十一点五纳秒一次命中
上面所有表都是我自己的计数器,它数的是探测次数,不是时间。
工业实现长什么样,得看 Go 自己的 map。一百万个 22 字节的 key,map[string]int,堆增长 53.36 MB,摊到每个 key 是 56.0 字节,56 字节装一个 22 字节的 key,多出来的三十四字节里,有桶本身、有每个槽位的一字节 tophash、有指向溢出桶的指针,还有为了让桶落在整条缓存行上留出来的对齐空隙。这一层不存数据,它存的是让 O(1) 成立的条件。
| 指标 | 数值 |
|---|---|
| 堆增长(一百万个 key) | 53.36 MB |
| 每个 key 占的内存 | 56.0 字节 |
| 命中查找 | 31.5 ns/op |
| 未命中查找 | 28.6 ns/op |
命中查找 31.5 纳秒一次,未命中 28.6 纳秒一次。没找到反而更快。
这不合直觉。
未命中在桶里碰到一个空槽就停了,那个槽位没有 key 可比,值也不用取。命中要把槽位里的 key 和要找的 key 逐字节比一遍,比中了还要取值。多出来的三纳秒,是比出来和取出来的。31.5 纳秒在机器的尺度上不算小,一次内存访问是几十纳秒的量级,这个数大致等于一到两次访问,哈希表在时间上的 O(1) 就是这么大,一亿次查找乘 31.5 纳秒,三秒出头。
三秒。很快,也很具体。
缺一条,平均值就作废
这一圈数下来,O(1) 那句话我现在的理解是,一个带前提的平均值。
前提有三个。
哈希函数得把 key 摊开。表里那两个坏函数,一百万个 key 只落进九千来个位置,其余的在预算里死掉了。这一条不成立,表根本装不满,谈不上平均,桶得留余量,从 0.238 到 0.954,平均从 1.156 涨到 11.164,最长从 11 涨到 5146。这一条是唯一完全由我控制的,key 有多少改不了,桶开多少能改。
冲突怎么处理,决定了退化之后长什么样。开放寻址的坏是一个连片的区域,链地址的坏是几条长链,前者先撞上探测预算,后者先撞上等待时间。真正被平均抹掉的是尾巴的形状。
三条缺一条,平均值就不可信。
现在再写这种表,我先估一遍 key 的数量,把桶开够,然后在探测循环里挂两个计数器,一个记总和,一个记最大值。前者告诉我这套配置有没有毛病,后者告诉我最慢的那一次能不能接受,两个数都看,缺一个都不行。