O(1) 是骗人的
O(1) 是骗人的
隔壁老康难度 ★☆☆☆☆ · 前置:接口慢了两百毫秒,最后是一张表的问题 | 一句话结论:O 只描述增长趋势,常数项、缓存、分配三样它都管不着,而工程里慢的往往是这三样。
头两个月写的代码基本照着旁边人的样子抄,抄到切片这一段卡住了:同样是把一百万个 int64 乘二装进一个新切片,有人从空切片开始 append,有人先 make 出长度再按下标写。我把复杂度表翻了两遍,两边的格子都写着 O(n),表上没有哪一格能告诉我该抄哪一种。问旁边人,他说都行,看你顺眼。我原本以为这只是个写法口味问题,既然表答不上来,我就在自己机器上跑:这台笔记本, windows/amd64,三种写法各跑五次取中位数,代码在 _local/ds-exp/d0/const_test.go 和 shape_test.go。
数出来是这样。
| 写法 | 中位耗时 | 分配次数 | 分配字节 |
|---|---|---|---|
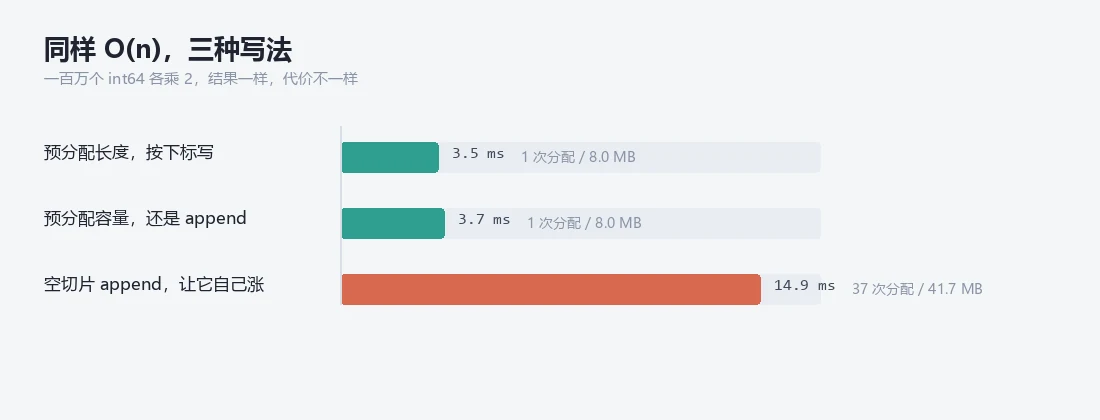
| 空切片 append,让它自己涨 | 14.9 ms | 37 | 41.7 MB |
| 预分配长度,按下标写 | 3.5 ms | 1 | 8.0 MB |
| 预分配容量,还是 append | 3.7 ms | 1 | 8.0 MB |
三种写法都要把一百万个元素过一次,循环次数一样,复杂度一样,全是 O(n)。
第二行和第三行几乎贴着,都在三毫秒半上下,这符合我的预期,容量够了就不用再涨。第一行不是。十四点九毫秒,是下面那行的四倍多,内存多占五倍多,分配次数多出三十七倍。三种写法在复杂度表上占同一格,在我这台机器上差 4.3 倍、5.2 倍、37 倍。我把这张表贴在显示器边上看了两天,越看越觉得那个 O(n) 像个盖子,把下面这一列数全盖住了,盖子上方干干净净。
我盯着那个 37 看了半天。
差的那四倍藏在分配次数里
三十七是个能数的数,不是玄学。从空切片开始 append,容量不够就换一块,换的时候要申请新内存、把老数据整块拷过去、再让旧块等着被回收。一百万个元素,容量从零一路涨到装得下,中间要换几十回,每一回都比上一回大,搬过的字节加起来比最后那块 8.0 MB 多出好几倍。预分配那两版把这些全省了,一次申请够,一次都不用搬。多出来的三十几兆没装任何新元素,全是搬家的路费,一趟一趟搬完就扔。两版预分配之间的差距压在 0.2 毫秒里,容量够的时候 append 不搬家,只多做一次长度检查,这点开销在四毫秒里看不出来。
决定胜负的是容量够不够,跟用不用 append 关系不大,我一开始还以为差别出在那次检查上。
这就是复杂度表缺的那一列。它只给我一个 n,而机器上真实发生的是一列一列的数:换了几回块,搬了多少字节,回收什么时候来。
三次分配和三十七次分配,在表上是同一个格子。
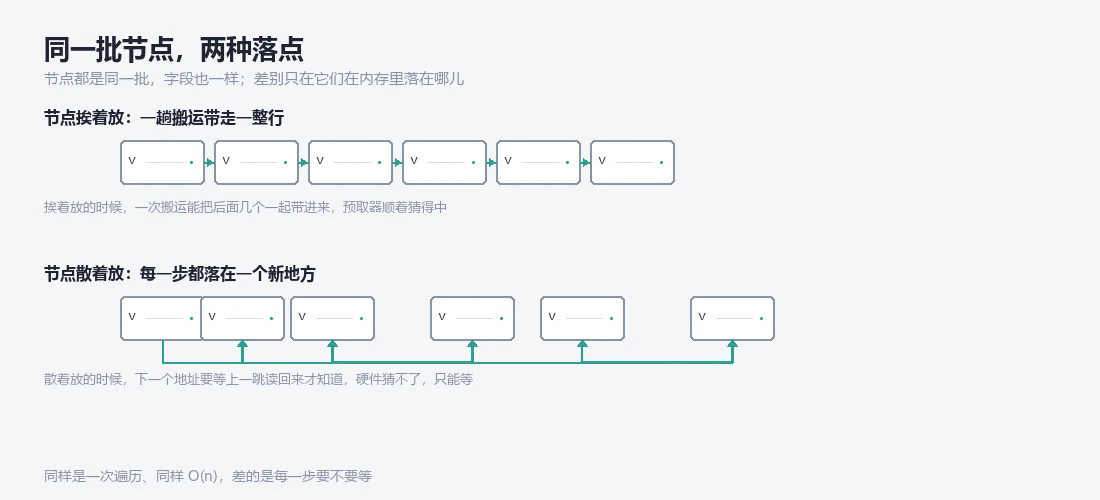
内存那一侧还有一组更直接的数。一千万个 int64,装进四种容器,做的都是同一件事,顺序遍历一遍求和:扁平切片 13.5 毫秒,指针数组 24.0 毫秒,链表按顺序分配 30.4 毫秒,链表打散分配 1735.9 毫秒。扁平切片和指针数组那一对最有意思,两边都是连续遍历,下标一个加一,差别只在后者每个元素多一次解引用,值不在数组里,在另一处,1.8 倍的差距就来自这一次跳转。链表那两行才是重点:节点按顺序 new 出来,地址是挨着的,遍历方向跟内存增长的方向一致,只比扁平切片慢 2.2 倍;把同样的节点建好之后随机洗一遍再串起来,字段一个没变,遍历代码一个字没改,变成 1735.9 毫秒。
五十七倍。
它在等内存,一个节点等一次。
O 扔掉的三样东西
O 描述的不是快慢,是输入变大时工作量怎么变。这句话很多教材写过,我读的时候跳过去了,直到上面那几组数摆在面前才真的停下来想它:它压根没打算告诉你一次操作花多久,它只告诉你 n 翻十倍的时候总工作量跟着翻几倍。
为此它必须扔掉三样东西。
常数项、缓存、分配。同一件事写两遍,一遍一步取一个 int64,一遍多跳一次指针,后一遍贵一点八倍,表上两遍都是 O(n),这一个字都体现不出来。同样一千万个节点,挨着放和散着放差五十多倍,这个倍数不在指令条数里,在内存等不等得上,O 数的是访问次数,不是每次访问要付多少钱。同样一百万个元素,一次申请和三十七次申请,差四倍多时间、五倍多内存,而分配在复杂度里压根没有位置,它不算算法,算运行时的账,账是运行时付的,表上记不到它头上。
三样东西扔得对不对?扔得对。不扔就没法跨机器比较。同一段代码在我这台机器上 14.9 毫秒,换一颗 CPU 可能是另一个数,换一代编译器又是一个数,连我那天开没开浏览器都能算进去。而 n 翻十倍、时间大致翻十倍这个形状,在哪台机器上都成立。O 是拿具体换普适,这笔交换在数学上很划算,在工程上经常吃亏,因为工程每天回答的都是一个特别具体的问题:我这段代码,在我这台机器上,明天上线,够不够快。
翻车的是我。
所以 O 没骗人,把它当性能预测的人才骗自己。它最硬的一条用处是排除:指数级的写法,常数项再小也救不回来;平方级的写法,规模上到一百万基本没戏。这种判断不用量,看一眼就知道。
但排除完剩下的两三个候选,它就不管了。
规模一大,常数项就让位了
那它什么时候真的管用?答案在规模差里。
常数项是个固定倍数,不随 n 变。四倍多就是四倍多,一万个元素是四倍多,一亿个元素还是四倍多。复杂度差距是另一回事,它随 n 一起涨。一个不动,一个一直涨,两者迟早交叉,交叉的位置就是门槛。
估门槛的办法很土,两步。第一步,把常数项的倍数量出来,同一个规模、同一份数据,两种写法各跑一遍,比值就是它,像我那张表里的 4.3 倍。第二步,看复杂度差距涨得多快:n 涨十倍,平方对线性涨十倍,线性对数对线性只涨一点点,指数对线性涨得没有边。举一个能算的,一百万个元素,log₂ 一百万大约是二十,n log n 的写法比 n 多走二十倍的路,要是那一版常数项大四倍,二十除以四还剩五倍,仍然值得。
两个数摆在一起,谁先追上谁一眼就能看出来。
反过来,常数项差到八百倍的时候(上一篇那一对:链表 993 微秒,切片 1.24 微秒),log 级的优势根本盖不住,要让它盖住,规模得涨到 2 的八百次方,宇宙里没那么多元素。换成平方对线性,规模到一百万时是实打实的一百万倍,常数项怎么折腾都不影响结论。
所以门槛的判断可以粗成这样:常数项差几倍,就得靠复杂度把那几倍挣回来。挣得回来的是幂级的差距,挣不回来的是 log 级的差距加上一个很大的常数项。它算不上公式,更像一张排序表,先用复杂度砍掉差一个数量级以上的候选,再在剩下的里面比常数项。
还有一个变量容易漏。
n 到底会不会涨。我现在维护的东西里,绝大多数数据的规模是稳的,一万条就是一万条。规模不涨,复杂度就是一张废纸,因为 n 不动,剩下的全是常数项和缓存,每天在替我决定接口是两百毫秒还是一千两百毫秒。
O(1) 有两种,一种会疼
复杂度的表上,O(1) 那一格住着两种东西。
一种是真常数。切片按下标取一个元素,地址等于基址加下标乘以八,一次乘一次加,取第 0 个和取第一百万个花的时间一样多。数组下标、取结构体字段,都在这一格。
另一种是摊还常数,append 就是。绝大多数时候它只做一件事,把值放到末尾,长度加一。偶尔容量满了,它要申请更大的块、把老数据整块搬过去、释放旧的。平均下来每次还是常数,所以表上写 O(1),写得没错。
可平均是平均值,它不保证某一次不疼。那一百万次 append 里落到 37 次分配,最疼的一次要搬几十万个元素,那一下是实打实的 O(n),而且是在一次调用里全部付清。
摊还的意思是平均下来,不是每一次。
这句话我在文档里见过好几回,真撞上才知道它有多具体。一个每秒 append 几万次的循环,平时稳得像条直线,扩容来的那一下延迟顶上去一截,然后又落回来。要是这个循环正好卡在请求链路上,尾巴就粗了,平时看不出来,压测一跑全是尖刺。
两种 O(1) 的区别就在这里:数组下标那种随便用,规模涨十倍它也不变;append 那种得知道它什么时候疼、疼多久。每次涨一倍还是涨一半,决定的是那一下疼多久、多久疼一次,这一格底下藏着的账比看上去长。
三条办法,按顺序过
写到现在,我的办法就三条,按顺序过。
第一条,先看规模。数据量在十万以下、两年内不会涨一个数量级的东西,复杂度表可以直接合上,这个规模上跑十万次和跑二十万次的区别,比不过一次缓存没命中。这种代码该省的是别处:少查一次库,少序列化一遍,少分配一块内存。第二条,规模会涨的,看复杂度差距是什么级,差一个数量级以上的,比如平方对线性、指数对多项式,按复杂度选,常数项不用管,规模会替你把它抹平。
只差一个 log 的,先把两个版本的常数项各量一遍再决定,别照着表选。
第三条,量。
基准不用写得漂亮,把两种写法放进同一个文件,同一个规模,同一份数据,各跑五遍取中位数,半小时够了。猜错一次花掉的调试时间比这半小时长得多。我那张表就是半小时的产物,它推翻了我原本笃定的两条:append 比下标慢,链表只是理论上的慢。
O 是地图,不是里程表。地图告诉你往哪个方向走,不告诉你到那儿要多久。我现在用它做两件事:排除掉一整类不可能快的写法,以及在两个差距悬殊的候选之间做选择,剩下的判断交给基准。跑一遍半小时,猜错一下午,这笔账怎么算都划算。