字符串为什么不能随便改
字符串为什么不能随便改
隔壁老康难度 ★☆☆☆☆ · 前置:删中间一个元素要挪多少人 | 一句话结论:字符串的字节是只读的,每次加号都要新开一块内存把旧的整条抄过去,拼 n 次就是 n² 的搬运量,Builder 把这件事压成一次。
入职第一个月接的活是写一个导出:把一个订单的二十几个字段拼成一行文本,逐行写进文件。我打了个循环,line += field,本地几百条数据,点一下按钮就出来了。为了证明这段代码没问题,我还认真写了个基准,加上 -benchmem 跑了一遍,第一行输出就把我看愣了。拼 5000 次,每段 10 字节,总分配 5020 次,累计分配 128.99 MB;而最后那条字符串长 50000 字节,也就是 50 KB。
五万字节的东西,路上扔了一百二十九兆。
我第一反应是基准写错了。在我的账本里,字符串加字符串就是往后接一段,接一段能有多贵。我把 -benchmem 的说明又翻了一遍,手算了一次 10 乘 5000,确认 50000 没错,128.99 MB 也没错,错的是我脑子里那个字符串会自己在原地变长的假设(现在看这假设蠢得很,当时却理直气壮)。
它不会。
加号底下是一次完整的搬运:左边那条字符串一个字节都没动,右边拼出来的是全新的一条,旧的整条被抄进去,新的接在后面。拼到第 n 次,抄的是前面攒下来的全部。
五万字节的结果,搬了一百二十九兆的货
把这件事写成公式很快。每次拼接要搬的量,等于当时字符串已经有多长,加上新来的 10 字节,所以拼 5000 次搬的总量是 10+20+30+…+50000,等差数列求和,50000×5001/2,一亿两千五百万字节,125 MB。实测 128.99 MB。多出来那三四兆,是基准框架每轮的固定开销,加上临时缓冲偶尔没被复用上。公式和实测贴得这么紧,说明这条路上没有别的秘密,贵的只有搬运这一件事。
一万次那组,公式给 500 MB,实测 531 MB。
5020 次分配也对得上:5000 次拼接,一次一块新内存,剩下二十来次是基准自身的。它不会像切片那样翻倍扩容,因为它没有容量这个概念,每次都是按长度精确地要一块,长一点短一点都得新要。
两笔账同时满了。
一笔是块数,分配多,GC 就忙,每块都要登记、跟踪、最后回收;一笔是字节数,搬得多,内存带宽被吃掉。+= 是少见的那种两边都不省的写法。
一万次拼接,四种写法
为了看清贵在哪里,我把同一件事写成四种,拼的都是一万次,每段还是 10 字节,最后都是十万字节。四段代码挪进同一个文件,数据在 init() 里建好,计时从 b.ResetTimer() 之后才起,每轮的结果塞进一个包级变量,免得编译器认定没人要。机器是 i9-14900HX,32 个逻辑核,Go 1.27.2,windows/amd64,每个基准 -count=3。取三次的范围而不是只看一次,是因为我头一遍跑的时候数字比后两遍高一截,取单次就会被开头那点抖动骗了,写进文章里也一样骗人。
| 写法 | 每轮耗时 | 分配次数 | 分配字节 |
|---|---|---|---|
s += piece |
194~215 ms | 10039~10086 | 531 MB |
strings.Builder 带 Grow |
76~85 µs | 1 | 106498 B |
strings.Builder 不带 Grow |
225~280 µs | 23 | 514811 B |
[]byte 一路 append |
110~139 µs | 2 | 212993 B |
先看最上面那行。+= 跑 194215 ms,85 µs,中间差着两千六百倍上下。(单位一个是毫秒一个是微秒,别看成同一个。)四次加法都做了一万次,拼出来的东西一模一样,十万字节,差的全在中间那块内存怎么用上。Builder 加 Grow 是 76
一个拼一次就换一块新的。
另一个攒在一块够大的地方往后写,只在不够的时候才换。一百二十八兆和五万字节的差距,是这两种用法一路累积出来的,没有别的花样。
后面两行值得单独看。
Builder 不带 Grow 是 225280 µs、514811 B、23 次分配;139 µs、212993 B、2 次分配。[]byte 一路 append 是 110[]byte 那组只有两次分配,我本来以为它会跟不带 Grow 的 Builder 差不多,实测快了一倍,字节数也少一半。212993 这个数几乎是 106498 的两倍,跟翻倍扩容对得上:第一次要一小块,第二次直接翻到十万字节,中间没来回折腾。这两组差在哪我没继续挖,因为我要的排序已经清楚了。
Grow 省下的是二十二次搬家
不带 Grow 的 Builder 慢的原因跟 += 是同一个,只是规模小得多:缓冲区不够长的时候要换一块更长的,把老的搬过去。23 次分配说明它这一路换了二十多次家,514811 B 差不多是最终长度的五倍,多出来的全是被扔掉的前几代。带了 Grow,你提前告诉它最后大概十万字节,它一次要到 106498 字节,后面一万次写全落在原地,分配次数从 23 掉到 1,字节数掉到五分之一,时间掉到三分之一。但这两个加起来都还比 += 便宜得多,不带 Grow 的那个仍然比 += 快八百多倍。这是最容易被跳过的一行:它自己也在反复扩容,也扔掉了几百 KB,可它搬的是缓冲区,一次搬几万字节,上面摊着几千次写入;+= 搬的是整条结果,第 n 次就要搬 n 次写入攒下来的东西。
但它两个都比 += 快得多。
不带 Grow 的那个,仍然比 += 快八百多倍。这是最容易被跳过的一行:它自己也在反复扩容,也扔掉了几百 KB,可它搬的是缓冲区,一次搬几万字节,上面摊着几千次写入;+= 搬的是整条结果,第 n 次就要搬 n 次写入攒下来的东西。
差的是摊薄的比例。
还有一个小地方,Builder 最后调 String() 不拷贝,它把缓冲区的头直接当字符串头返回,所以整个流程只有一次分配。如果最后还要把缓冲区整块拷成一条新字符串,那 1 次分配、106498 字节这行数就不成立了,得翻倍。
1 | var b strings.Builder |
那次跑出来全是 0 ns 的基准
量互转的时候我又栽了一次。第一版基准我写的是 runtime.KeepAlive([]byte(s)),我以为这句话的意思是编译器你别动,这段转换的结果我后面还要用。跑出来 []byte(s) 那一列,16 字节 0 ns,1 KB 0 ns,64 KB 0 ns,4 MB 还是 0 ns。
四兆的整块拷贝零纳秒。
这已经不是快,这是没干。我盯着那四个 0 看了很久,把 KeepAlive 的文档翻出来逐句读。它保证的是到这个点为止这个对象还活着,它没法让一个从头到尾没人读过的值变得有用。编译器看到转换的结果没被读、没被改、没传出去,直接把整个转换删掉了。
连 KeepAlive 里那个参数都只是个临时副本。
第二版改成先写一格再读回来:bs[i%len(bs)] = byte(i),然后从中间那一格读一个字节加进结果。数字立刻出来了,4 MB 那次 1115661 ns。同一段代码,同一个编译器,只因为我真的改了一下、真的读了一下,那块内存才必须存在。
1 | func benchToString(size int) time.Duration { |
这件事后来被我写进基准文件的第一行注释:Go 的编译器比你想象的聪明,你只有真的改了它、真的读了它,它才不敢删。写基准最怕的不是数字难看,是数字太好看,0 ns、1 ns、比一次函数调用还便宜,那基本可以确定这段代码根本没跑。还有一种更隐蔽的,循环被整个提到外面,跑一次算一万次,数字小得让你以为自己写了个神迹。我现在看到异常的漂亮数字,第一件事是去翻结果有没有被用上,第二件事是去翻循环还在不在,第三件事才是怀疑机器。0 是最危险的读数。
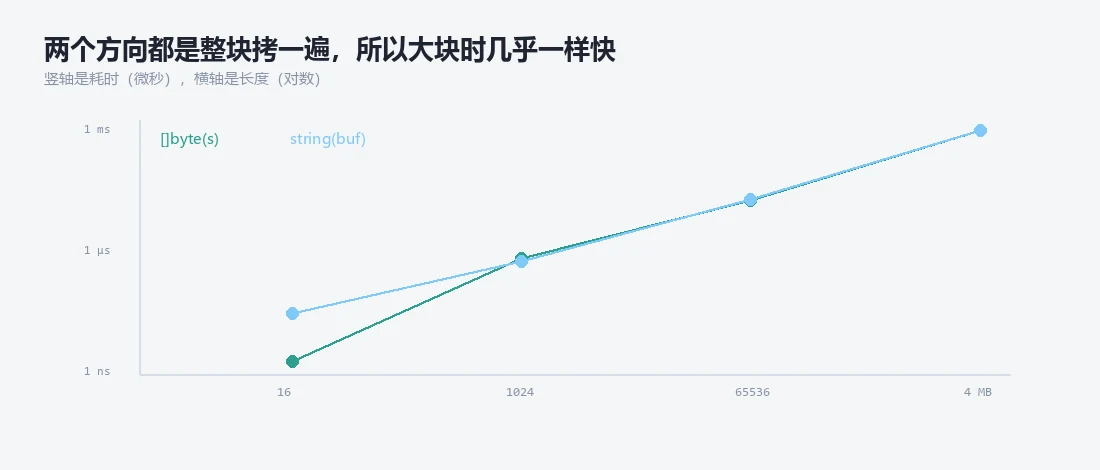
互转是整块拷贝,两个方向一样贵
第二版量出来的数字在下面。两个方向都真的写了一格、读回一格,读回来的值加进一个包级变量。
| 长度 | []byte(s) |
string(buf) |
|---|---|---|
| 16 B | 2 ns | 32 ns |
| 1024 B | 712 ns | 610 ns |
| 65536 B | 19809 ns | 20662 ns |
| 4 MB | 1115661 ns | 1102947 ns |
表里两个方向基本持平。1 KB 以上两边互有胜负,差距都在 5% 以内,4 MB 那两行差 1%,那点差别是测量本身抖出来的。原因很朴素:两个方向做的是同一件事,申请一块同样大的新内存,把老的字节整块抄过去,方向不改变工作量。前面那个 0 ns 的教训在这里还有一层用处,它说明这张表里的每个数都不是白来的,两个方向都得真的写一格、真的读一格,编译器才肯把拷贝留下。大块折下来 3.3~3.8 GB/s,这个数大概是一半的内存带宽,因为一次拷贝要读一遍再写一遍,一来一回正好翻倍。你在一段热路径里写两个来回,带宽就没了。
16 字节那一行是两个世界。
[]byte(s) 2 ns,string(buf) 32 ns,差十几倍。这里比的不是拷贝速度,是固定开销:32 纳秒大概是一次堆分配加一次很小的搬运,而 []byte(s) 能到 2 纳秒,是因为那块返回值没逃逸出去,编译器干脆给了它一块栈上的地方,连分配器都没惊动。这一点我后来靠着 -gcflags=-m 才看明白,光盯着两个数字是猜不出来的,我看的时候还以为是机器抖了一下,重跑三遍才发现它每次都这样。
小对象的时间按次数算,不按字节算。
1 KB 那一档把同一件事又说了一遍。712 ns 折下来才 1.4 GB/s,比 4 MB 那一档慢一倍多,因为搬 1024 字节只要一两百纳秒,剩下的全给了分配器挑块、登记、最后回收。尺寸小到一定程度,拷贝本身就不是主要成本了。
几兆的字符串该往哪儿放
这里说的几兆,是那种整块读进来、过一遍、再吐出去的东西,一份几十兆的 JSON,或者一整个 CSV。这种场合第一条是别拿它来拼:先用 Builder 或者 []byte 把整块攒好,攒完只转一次。第二条是转的方向,能留在 []byte 里就别转回 string,w.Write(buf)、sha256.Sum256(buf) 都收 []byte,转一次就是白拷一次。第三条是按行或者按分隔符切开的时候,别为了拼回去先 strings.Split 出一个 []string。Split 本身不拷字节,它给出来的每一段都是原串的视图,可那个切片是实打实分配的,每一段占一个十六字节的头,行数越多这个头数组越大;更要紧的是每个视图都攥着原串,你还留着其中任何一段,整块原串就释放不掉。
一个二十兆的文件切成一百万行,光切片头算下来就是十六兆。
还有一条不太容易想到:s[i:j] 切出来的子串不拷贝,它跟原串共享同一块字节。这在解析时很省,可如果你把切出来的小段存进 map 或者缓存,那块 8 MB 的原串就一直活着,因为每个小段都攥着它。我踩过一次,从一个 8 MB 的字符串里切了 20 个字节的 key 存起来,以为只存了 400 字节,内存却一直不降,GC 跑完也降不下来,后来改用 strings.Clone 才降下去。这个坑的麻烦在于它不报错也不变慢,只是内存一直挂在那儿,翻代码翻不出来,得翻堆快照才看得见那一堆小字符串底下压着同一个大家伙。省下来的拷贝,最后用内存还了。
省下来的拷贝,最后用内存还了。
遍历的方向也得对。len(s) 是字节数,s[i] 是第 i 个字节,for range 才按 rune 解。中文一个字三个字节,按下标切到一半,切出来的就是半个字,写进文件里全是乱码。
1 | func scanLines(s string, fn func(string)) { |
这段里面没有一次分配,用的全是原串的下标。扫一份几十兆的文本,它跟 strings.Split 的差距不在复杂度,在于一个只碰过所有字节,一个还要另外分配一个几十万元素的切片头数组。
先数它要搬几次家
现在我在代码里看到 s += x 躺在循环里,会先停一下,问三件事:这个循环最多跑几次;拼完的东西大概多长;拼完是不是只读一次就扔。三个都有答案,就用 Builder 一次 Grow 到底,写完收工;答不出来,说明这段代码的规模还没定,那更不能用加号,它在大规模下会把机器拖住,而且拖得很安静,没有报错,只是越来越慢。这三问问起来比写起来慢,可它们花的时间,跟事后去翻一个跑了二十分钟的导出任务比,根本不算什么。我现在的做法是把这个循环的长度当成一个必须写进注释的数(写不出来就说明这段代码还没想清楚),有数的人才会顺手 Grow,没数的人连自己拼出来多长都不知道。
这三问问起来比写起来慢。
值不值?一段导出逻辑,五千条数据,用加号是一百二十九兆的搬运,用 Builder 是五十六 KB。这个差距不用优化经验去判断,量一次就有答案,而且量一次之后不会忘,记忆里那句字符串不可变是个名词,128.99 MB 是个数字。
数字比名词好记。
字符串不可变这件事,我原来是当成一句背诵的教条记的,觉得它是个设计口味的问题。量完这几组数才明白它是一条硬约束:只读的字节才能被无数个头共享,切一刀不用拷贝,代价是任何一次改动都得整块重造。加号贵、Builder 省、互转要拷贝,三件事说的是同一句话。
我现在看到一段拼接,先数它会搬多少次家,再想它该不该写在循环里。