map 的遍历顺序为什么每次都不一样
map 的遍历顺序为什么每次都不一样
隔壁老康难度 ★★★☆☆ · 前置:切片的容量是这么长的 | 一句话结论:map 的遍历顺序每次都不一样,是因为运行时从随机的桶和随机的槽位起步,它只保证每个键被看见一次,从不保证看见的次序。
第一次被 map 的遍历顺序坑到,是在一个配置加载的小包里。那个包的测试写得直白,遍历一张配置表,把键和值拼成一个长字符串,再跟一份写死的期望值逐字节比较,本地连跑三遍全绿,推到 CI 就红了。日志里两个字符串的内容一模一样,只有先后不同,我第一反应是并发,把调用链上的 goroutine 数了一遍,一个都没有,又怀疑 CI 上的 Go 版本落后,还怀疑测试缓存没清干净,折腾到晚上十点,最后干脆把四次遍历的结果原样打出来,才看见四次是四个完全不同的排列,而那段代码里没有任何一行碰过随机数。在此之前,我对 map 的理解停在哈希表这三个字上,它对我来说就是一个袋子,键丢进去,需要的时候伸进去掏,掏出来的先后固定得像数组从零号位往前走。
那晚我把四次输出贴在同一个文件里上下比对,才意识到自己一直在找一个不存在的错别字,真正的差异只在顺序上。
先看它长什么样。
栈上只有一个八字节指针
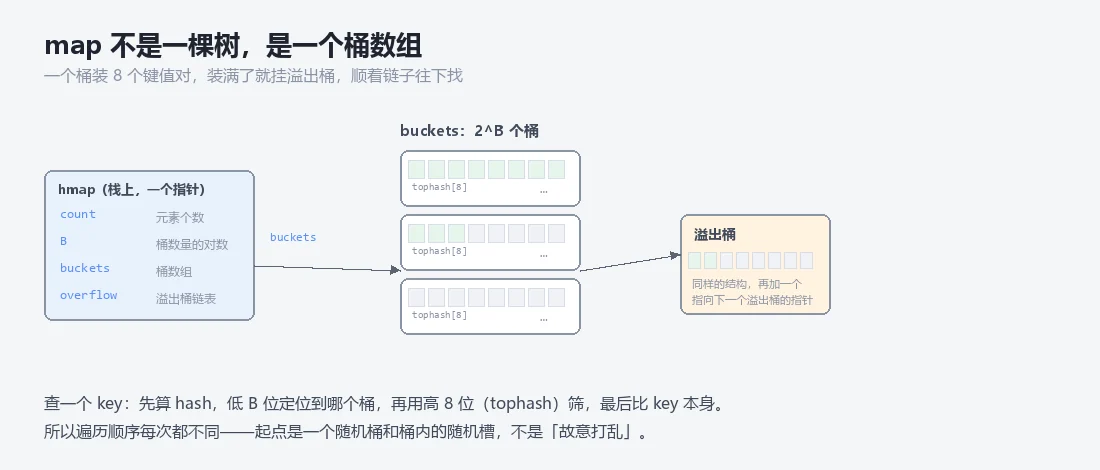
把一个 map 变量传给函数的时候,传过去的既不是一个结构体,也不是一整张表,只是一个八字节的指针。这个指针指向堆上的 hmap,里面那几样东西各管一件事:
| 字段 | 记的是什么 | 什么时候用得上 |
|---|---|---|
count |
键的总数 | len() 直接读它,一次都不用遍历 |
B |
桶数量以二为底的对数 | 算桶号,一条位与指令 |
buckets |
指向桶数组 | 每次读写都从这里进去 |
overflow |
溢出桶链表的头 | 桶满了之后挂新桶 |
我第一次读这段定义的时候,也没弄明白 B 为什么要用对数存,直接用桶数不是更省事。后来在一张只有几十个键的小表上把 hmap 打印出来,对着 B 和实际桶数数了一遍,才接受这个写法,桶数组的长度是二的 B 次方,存对数就是存位数,取模那一步只要一条位与指令,不用做除法,扩容的时候也只要把 B 加一。用对数的代价是每一处算桶数的地方都要现算一次幂,我就在调试输出里把 B 当成桶数读过一次,盯着一个对不上的桶号找了半天,最后发现是自己把两个量混成了一个。
(这种错大概每个读源码的人都犯过一次。)
make(map) 只给了栈上一个 hmap 指针。
桶不够用的时候,B 会加一。
栈上那八个字节之外的东西全在堆上,包括 hmap 本体,包括后面跟着的那一大片桶,一张装了几十万个键的表也不例外,换个说法,你手里的变量永远只是一个地址,表本身从来没有跟着参数走进栈里来。
认下这一点,很多现象就不用单独背。
map 不能比较,因为没有可比的内容,两个变量之间能比的只有那个指针。
空的 map 连桶数组都不分配,第一次写入才建一个桶,键多起来再翻倍,翻倍时 B 加一。
一个桶装八个槽位
桶的类型叫 bmap,一个桶装八个槽位。结构上它先是八个字节的 tophash,一个槽位一个字节,然后是八个 key 挨着排,再是八个 value 挨着排,最后是一个指向下一个溢出桶的指针。把 key 和 value 分开排不是为了整齐,是为了让八个 tophash 落在同一段连续内存里,比候选键的时候能一口气读完,不用读一个 key 就跳去下一个 key 的地址。
八这个数字也不是随手定的,它刚好落在一条缓存行的余量里,既能摊薄桶头的开销,又不至于让一次比较串起太多字节。
桶里的槽位是有序的,第一个空槽就是插入位置,所以同一个键在同一次运行里往往一直落在同一个槽,直到扩容把它搬走。八个是一种密度。
tophash 只占一个字节,撞车是常事,这一步筛不掉全部。八个槽排满之后,第九个键不挤走别人,运行时会在这条链后面再挂一个溢出桶。
定位一个键要走三步
查一个键的时候,运行时分三步走,一步比一步贵:
- 用哈希值的低
B位算出桶号,桶数组长度是二的B次方,实质是取模,只不过模数是二的幂,一条位与指令就结束 - 拿到桶之后,用哈希值的高八位当 tophash,跟桶头那八个字节逐一比,相等的才可能是目标键
- 最后才把 key 本身拿出来逐个比,确认它真的是要找的那个,而不是一个 tophash 撞车的邻居
这三步里前面每一步都只是缩小范围,真正确认身份的永远是最后一步,而最后一步也是唯一需要读整个键的一步,键越长,这一层越贵。这三步里前面每一步都只是缩小范围,真正确认身份的永远是最后一步,而最后一步也是唯一需要读整个键的一步,键越长,这一层越贵。
1 | hash := hasher(key) |
这三步的顺序不能反,因为比 key 是最贵的一步,字符串做键,哈希要把整个串走一遍,比 key 在最坏情况下还要再走一遍。顺序不在这里。哈希的低位决定桶,高位决定 tophash,两段来自同一份哈希。
一个键落在哪个桶,只取决于哈希的低 B 位,跟键的大小无关,也跟插入的先后无关。
一个桶八个槽,tophash 一过通常只剩一个候选,剩下七个连 key 都不用碰。
桶装满之后挂溢出桶
新键往哪放,查的时候又怎么找回来?溢出桶的代价不在挂的那一下,在查的时候。目标桶里的八个 tophash 都比完还没有命中,就得顺着指针去下一个桶,到那边再比八个,链长了就是好几次内存跳转,每一次都可能是缓存未命中,而缓存未命中是这套结构里最贵的开销。写的时候也一样,一个桶满了,运行时要顺着链找到最后一个桶,再往第一个空槽里塞,链越长这一次写的路越远,路越远就越容易踩到别的缓存行,把本来只该占一行的活摊成好几行。分布差了就得重排。扩容的触发条件里有一条就是溢出桶太多,哪怕键的数量还没到阈值,一条链长得不像话也会被判定为分布变差,运行时把桶数组翻倍,再把这些键分到两倍数量的桶里。扩容时新桶数组先开好,旧桶里的键要重新算一遍位置再搬过去,这一段是 map 操作里最费时间的部分。我第一次在意扩容是在一条线上服务的内存曲线里,那条曲线本来很稳,某一刻开始隔一段时间往上跳一格,跳完不落。
翻出来的 pprof 里大头在 mapassign,每一跳都对应一次翻倍。
后来按业务的峰值先把容量 make 出来,那条台阶就没了。
这件事让我记住,扩容的疼不是均匀摊在每次写入上,它集中在几个时刻,而那些时刻往往正好赶上写入的高峰。
起点是随机抽出来的
现在回到开头那个问题。range 一张 map 的时候,运行时不从第一个桶的第一个槽出发,它先随机挑一个桶当起点,再在这个桶里随机挑一个槽位,然后从这个位置往后绕一整圈,绕回起点为止。桶的顺序是固定的,槽的顺序也是固定的,变的只有起点。所以两次遍历的差别不是把所有键重新洗了一遍,而是同一串顺序被切在了不同的位置,这跟洗牌是两件完全不同的事,洗牌改的是排列本身,随机起点改的只是你从哪一格开始读。四次遍历,四个不同的顺序,脚本数出来是 4。其中一次正好是 abcdef,看着像字典序,其实是绕一整圈刚好从 a 开始。顺序是故意不给你的。这个设计有它的来历。更早的版本里,map 的遍历顺序是稳定的,稳定到有人开始依赖它,按遍历顺序拼签名,按遍历顺序生成报表,等到内部实现一改,这些代码集体出错,错的地方还离改动很远。
后来运行时索性把顺序的随机化写进文档,等于承认这不是实现细节,而是一条要遵守的约定。
我现在写遍历的代码,只要顺序进了任何输出,先排一遍再说,不给自己留侥幸。
1 | bcdefa |
一千次里只有四个键排过第一
同一张六个键的 map,我只取每次遍历里第一个出现的那个键,重复一千次,得到的分布是键 1 出现 619 次,键 2 出现 114 次,键 3 出现 136 次,键 4 出现 131 次,键 5 和键 6 一次都没有排过第一。这个结果比我预想的偏得多(我原本以为六个键应该差不多),每人大约六分之一,实测下来键 1 一个人占了一大半,剩下三个分掉零头,还有两个连门都没进,这个形状很难用随机两个字打发过去。偏的来源是起点怎么选,桶里只有八个位置,键只占了其中六个,起点落在哪一格并不均匀地分给六个键。四个数各跑一遍,没取平均。这个分布有一层实际含义,任何写取第一个元素的代码都是在赌,你以为反正是任意一个,实测下来确实是任意一个,只是概率差了好几倍。这个偏法是有规律的,桶号和槽位都由哈希低位决定,键一旦落进第一个槽,它排在第一个的机会就比邻居高一截,而落进靠后槽位的键,前头总挡着别人。所以取第一个元素这件事,表面上随机,实际上偏向某几个固定的键。
预分配省下的那百分之十几
往一张 map 里写一百万个键,我测出来是 66.99 毫秒,同样的一百万个键、同样的插入顺序,先用 make 把容量标成一百万再写,是 56.48 毫秒,差 1.19 倍。
这一截差距全部来自扩容,不预分配的话,桶数组要从小到大翻好几次,每次翻倍都要把已有的键重新算一遍位置,再搬到新桶里去,搬的键越多,中间白花的力气越多,而这类力气是纯粹的内耗,它不产生任何一个新键,只是把已经放好的东西挪个地方。
代价藏在桶数、键宽、装载因子三个数里。
make 的第二个参数不是容量上限,它只是给运行时一个提示,运行时按这个提示算出 B,再分配二的 B 次方个桶。
1.19 这个倍数不算大,所以我不给每个 map 都写预分配,值得写的是那种一次建好之后只读不写的表。
比预分配更隐蔽的省法是键的类型,整数比字符串便宜,短的定长结构体也比字符串便宜。
并发写是进程级的事故
两个人同时往一张 map 里写,运行时会直接让进程死掉,报错原文是 fatal error: concurrent map writes。这个错误用 recover 接不住,它不是 panic,是运行时主动调用的,打印完调用栈就退出,defer 在这条路径上根本轮不到执行。运行时并没有给每次写入加锁,它只是在一个标志位上做检查,发现有人正在写,就认定这个程序已经错了,没必要继续跑下去,于是把整个进程停掉,连带着所有正常的 goroutine 一起。我印象最深的一次是本地跑测试时它连日志都没写出来,缓冲区还没刷就被整个进程带走了,最后只能靠前面几行已经落盘的东西往回猜。后来我们的做法是把 map 的读写先过一层自己写的包装,用锁也好,用 sync.Map 也好,总之在开发环境里先把这类崩溃挡在测试阶段。还有一次是在压测里,两台机器上的概率完全不同,一台几分钟撞一次,另一台跑一整晚都没事,最后发现差别只在键的分布上,分布越集中,两处写入落到同一个桶的机会越大。
这个设计是刻意的,写入路径上加锁的话,每一次写都要付一次原子操作的钱,单线程场景白白变慢。
崩的是整个进程。
这坑我踩过两次。
读写同时发生是另一条线,检测不一定触发,可能读到一半的桶,可能看到刚搬过去还没搬完的状态,结果是拿到一个错误的值,或者一个本该在却查不到的键,这种问题比崩溃难查得多。
nil map 是另一回事,读它得到零值和一个 false,len 是 0,range 一圈就结束,全都不报错。
所以每次声明一个 map,我紧接着就 make,或者干脆用字面量直接初始化,别留一个 nil 的表在变量里过夜。nil 的表读起来是什么样?跟空表一样,返回零值,区别只是写的时候会崩。
写到这里,开头那个在 CI 上红掉的测试大概也说得清了。map 是一张会自己长大的哈希表,桶是它的最小单位,tophash 是它省下的第一道筛子,随机起点是它给你的提醒。
它只保证每个键被看见一次,不保证看见的次序,要顺序就自己把键拿出来排一遍,装进切片,用 sort 排完再拼字符串,一样的代码跑一万遍也是同一个结果,这件事没有捷径,也不该指望运行时替你排。