二叉搜索树:理想很均衡,现实很歪
二叉搜索树:理想很均衡,现实很歪
隔壁老康难度 ★★★★☆ · 前置:链表慢在每一次跳转 | 一句话结论:BST 的值钱处不是 O(log n),是它中序遍历出来就是有序的。
一万个 key,树高也是一万
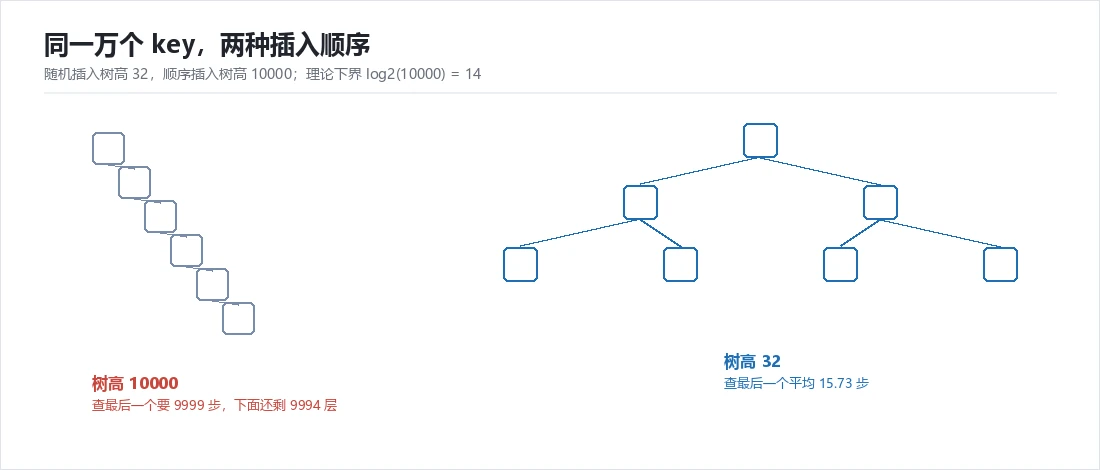
一万个 int,按 1 到 10000 的顺序插进自己写的那棵二叉搜索树,插完打印树高,屏幕上是一个 10000。树是三天前刚写完的,插入、查找、中序遍历三个方法加起来不到八十行,单元测试用手画的七节点小树跑过一遍,全绿。同一页笔记的上一行还抄着 log₂(10000)=14.00,两个数并排摆着,差了七百一十四倍。我第一反应是高度函数写错了,翻回去把递归重看两遍,又手动画了五个节点插进去验算,才承认屏幕上那个数没错,错的是我对树这个字的印象。
它没有长歪,它压根没长。
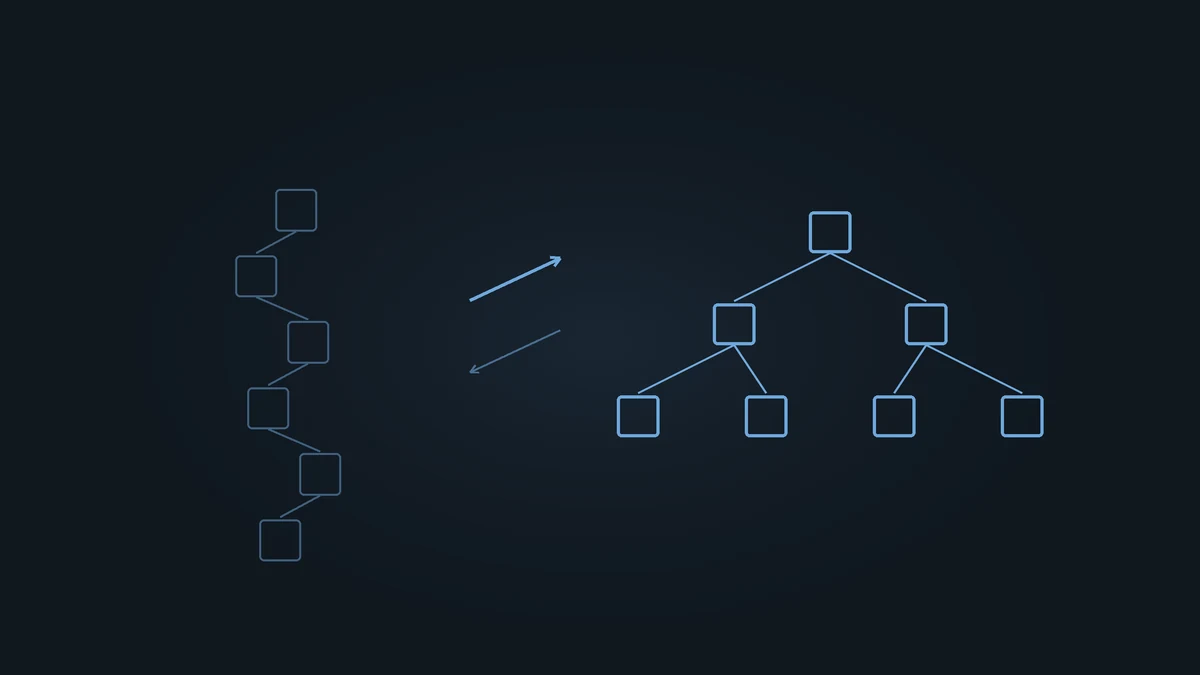
每个新来的 key 都比前面所有 key 大,比较一次就往右走,走到右边是空的,挂上去。第二个挂在第一个的右孩子上,第三个挂在第二个的右孩子上,第一万个挂在第九千九百九十九个的右孩子上。一万个节点的左指针全是 nil,一个都没用上。这棵树和一条单链表干的是同一件事,区别只有两处:每个节点多浪费一个指针,每次往下走多一次比较。链表那篇里我量过跳转的代价,那时候我至少清楚自己在链上;这会儿我以为自己在树上,还以为自己拿到了对数。
结构长成什么样,光看代码是看不出来的。
教科书给二叉搜索树的三条结论,插入 O(log n)、查找 O(log n)、删除 O(log n),底下都压着同一句前提:树是平衡的。平衡不在定义里,也不在实现里,它取决于 key 进来的顺序。我那晚喂进去的是一段连续整数,正好踩在最坏的那一档。
代价可以直接数。查 1,根就是它,零步。查 5000,顺着右指针走 4999 步。查 10000,走 9999 步。
| 建树方式 | 树高 | 查 1 | 查 5000 | 查 10000 |
|---|---|---|---|---|
| 顺序插入 1..10000 | 10000 | 0 步 | 4999 步 | 9999 步 |
| 随机插入同一万个数 | 32 | — | 23 步 | — |
第二行不是笔误:随机插入的树高只有 32,查 5000 只要 23 步。同一个结构,同一批 key,只因为进来的顺序不同,一个是一万层,一个是三十二层。
三个 0.000 毫秒是编译器替我跑的
要回答到底慢多少,光有步数不够,我得把三种结构摆到一张台面上比。第一版基准写得特别省事,每轮查十万次,跑五轮取最小值,换算成毫秒打印。选手有三个:有序切片配 sort.SearchInts、我自己那棵朴素 BST、还有一条顺序链表。写完直接跑,输出整整齐齐,我甚至没觉得哪里不对。
1 | func benchSearch(tree *BST, keys []int) float64 { |
整齐得像已经排好版的表格。
1 | 有序切片 0.000 ms |
都很快,这是我第一个念头。
第二个念头来得慢:这三个零太一致了。一条顺序链表查十万次,就算每次只花二十纳秒,也该有个毫秒的量;它和二分查找到小数点后三位都贴在一起,那这门课可以不用开了。问题出在 found 身上。它是局部变量,循环里只被加,从来没被读过,算完就扔。整个循环对程序状态没有任何可观察的影响,编译器有充分理由把它整段删掉,time.Since 量到的于是只是两条相邻语句之间的空转。
改法是加一个包级变量把结果接住,循环体里写 sink++,让编译器不敢动那五十万次函数调用。这个道理我其实知道,只是写基准的时候脑子里只有算法,忘了自己面对的还有一个会做全局优化的编译器。
1 | var sink int |
加完重跑,三行还是 0.000,但原因换人了。
微秒被取整吃掉,我还以为量不出来
我先怀疑的是时钟。Windows 上 time.Now() 走 QPC,我把它的分辨率查了一圈,又把循环挪进一个独立函数里,怕是被内联掉了,数字还是一动不动。直到点开 time.Duration.Microseconds() 的实现才看明白:它返回 int64,先把纳秒截成整数微秒再交出来。我当时测的是单次查找,一次几十纳秒,进去就被截成 0,零再除以一千还是零。修好死代码以后我盯着那排零,第一反应是换台机器试试,倒没想过回头看一眼自己写的那行除法。
零不是量不出来,是交到我手上之前就被砍掉了。
改法也是两条。批量提到十万次,让单轮落在几千微秒以上,远离取整那条线;换算改成纳秒除以一千,小数位就留得住。两处错误叠在一起时症状一模一样,都是三个 0.000,一个半小时就想通了,一个耗掉我大半天。
1 | return float64(best.Nanoseconds()) / 1e3 // 微秒,带一位小数 |
那天下午我盯着这三个数看了一会儿,说不上高兴。
同一个一万,树高是三十二
回到树本身。把一万个 key 先洗一遍再插,树高 32,平均查找深度 15.73 步,理论下界 log₂(10000)=14.00。多出来的 1.73 步是形状不均匀的税:深度不是平摊在十四层上,浅的地方挤着一堆节点,深的地方拖着几条尾巴,平均值就被抬起来。教科书里随机 BST 的期望高度是 4.311·ln n,一万代进去三十九点七,我量到 32,同一个量级。它和平衡树不是一个东西:平衡树每次插入之后会转一下,把高度锁在 log n 的量级;随机 BST 什么也不做,只是让形状大概率还行。
随机插入买到的是大概齐,不是保证。
1 | func (t *BST) Search(k int) bool { |
我那棵树的 Search 从根开始,等于就返回,小于往左,大于往右,走到 nil 就是没有。循环里每一步只做两件事:比一次,挪一次。
路径有多长,在建树那一刻就定死了,后面查多少次都改不了。
十万次查询,一点八七秒
把死代码和取整都修完,第一张表出来了。
| 结构 | 十万次查询 |
|---|---|
有序切片 + sort.SearchInts |
2630.6 µs |
| 朴素 BST(随机插入建树) | 2699.6 µs |
| 顺序链表 | 764599.7 µs |
BST 比有序切片慢 2.6%,基本算打平;链表比 BST 慢两百八十多倍。这两行放在一起,把一件我一直含糊的事情说清楚了:二分和二叉搜索树在查找上做的是同一件事,都是每次砍掉一半,差别只在有序切片砍的是下标,树砍的是指针。指针要经过一次内存访问,下标就躺在连续的一段里,所以树一般还略慢一点。这也解释了为什么标准库的二分是那么寡淡的几行:它不需要建任何东西。
第二张表只换了一个变量,建树方式。
| 建树方式 | 十万次查询 |
|---|---|
| 顺序插入建的 BST | 1871991.2 µs(1.87 秒) |
| 随机插入建的 BST | 7864.2 µs |
| 有序切片 | 7455.4 µs |
顺序插入那棵树,查十万次要 1.87 秒,随机插入的只用了 7864.2 微秒,差两百三十八倍。数据是同一万个数,代码是同一份代码,main 里只改了一行:插入前有没有 rand.Shuffle。建树本身的账也得记一笔,顺序插入一万个 key 花 1386964.3 微秒,也就是 1.39 秒;随机插入只要 1727.7 微秒,差八百倍。每次插入都要从上往下走一遍,链上第 i 个 key 要走 i 步,累加起来是五千万步,这是 O(n²) 对 O(n log n),规模涨十倍差距还会继续拉开。
同一份有序切片在两张表里差了近三倍。这个数我不打算解释,两轮之间机器状态和查询序列都变过,我只用同一张表里的比值说话。
建树慢八百倍,比查找慢两百三十八倍更该被记住。
中序遍历印出来是一到二十
前面都在算查找和建树,那两样都不是我该留着它的理由。
一万个 key 建好之后跑一遍中序,把前二十个打出来。
1 | func (t *BST) Inorder(f func(int)) { |
是 1 到 20,一个不多一个不少,再拿结果过一遍 sort.IntsAreSorted,返回 true。一句废话,但值钱的地方就在这句废话里:我没有另外维护一个数组,也没有在插入完成之后排一次序,有序性是树的结构自带的。红黑树、跳表、B+ 树收的都是这份租金,它们费那么大劲做平衡,为的就是让这条中序序列在插入删除之后还能保持有序。我一开始没看懂这一层,才把 O(log n) 当成了它的全部价值。范围查询也是从这条序列上长出来的:我要 3000 到 3100 之间的所有 key,先找到 3000,再一个接一个往后继跳,走一百零一步就停。哈希表要么把一万个 key 全扫一遍,要么在哈希之外再维护一份有序副本。
有序能换来三样东西,哈希表一样都给不了。
前驱后继、第 k 小、排名,都是从同一条链上长出来的,看着像不同的接口,底下是同一个动作:在一棵有序的树上往下走。第三样是边插边查,有序切片也能范围查询也能二分,代价是插入要挪元素,树不用挪,插进去只改两个指针。
先看 key 是谁给的
判断一棵树会不会歪,我现在只看一句话:key 是从哪儿来的。
自增主键、时间戳、日志里的序号、按行读出来的排好序的 CSV、从上游接口拿回来又没打散的一列 id,这些都是顺序数据。把它们按原样往 BST 里塞,塞多少长多少,长出来的是一条带左指针的单链表。我入职那年写过一个按时间戳建索引的小工具,当时觉得树比 map 高级,因为树是有序的,查一个区间不用扫全表。
那批时间戳只增不减。
要修有三条路。key 不可控又必须拿它当索引,就换平衡结构,红黑树或者跳表,让结构自己去转;key 可控、只是想建完就查,就别建树,攒进切片排一次序用 sort.SearchInts 二分;真要树又不想写平衡逻辑,那就插入前先洗牌,用随机性换平均形状。
这三条我在项目里都写过,最后落地的多是第二条。
一万个 key 攒齐,sort.Ints 排一次,之后所有查询都是 sort.SearchInts 在一段连续内存上跳。它没有指针、没有额外分配,建完就剩一个切片,查区间也好写:起点用 SearchInts 定位,往后一直取到超出上界为止。树的优势只在真正需要边插边查的地方才显出来,而我手上大部分活都是先有一批、再查很多次。
先有整批,再有很多次查询,这个形状本来就不需要树。
我现在建完任何一棵树,第一件事是打印树高。树高不对,后面那些 O(log n) 全是从别处借来的,迟早要还。顺便把平均查找深度也一起打出来,一个数看形状,一个数看典型代价,两个一起看才不会被其中一层骗过去。这个检查三行代码,比任何一次事后排查都便宜。