反射慢在哪一步,那几步能不能省
反射慢在哪一步,那几步能不能省
隔壁老康难度 ★★★★☆ · 前置:defer 在什么情况下不要用 | 一句话结论:反射的每一纳秒都能归到三件事上,查表、打包、拆包,缓存只治得了第一件,后两件得靠编译期生成的代码绕开。
2023 年 6 月我入职做后端,头一年写业务代码几乎没碰过 reflect 包,需要按名字找字段的地方都用 map 或者手写 switch 顶过去了。换成按 tag 反射填值,是因为一段填值逻辑二十来个结构体,手写一遍好几百行,漏一个字段线上就多一个零值。
压测那天它排在 CPU profile 前几位,我一度怀疑是采样骗了我。
环境 i9-14900HX,32 个逻辑核,go1.27.2,windows/amd64,被测结构体只有三个字段。
1 | BenchmarkDirect-32 1000000000 0.5298 ns/op 0 B/op 0 allocs/op |
五个数并排摆,倍数和分配对不上
我把这五次测量摆成一张表,横着比:
| 做的事 | ns/op | 倍数 | B/op | allocs/op |
|---|---|---|---|---|
| 直接赋值 | 0.5298 | 1 | 0 | 0 |
| 反射写字段 | 40.16 | 76 | 64 | 2 |
| 直接读字段 | 1.820 | 1 | 0 | 0 |
| 反射读字段 | 7.287 | 4 | 0 | 0 |
| 按名字找方法再调 | 384.0 | 725 | 40 | 3 |
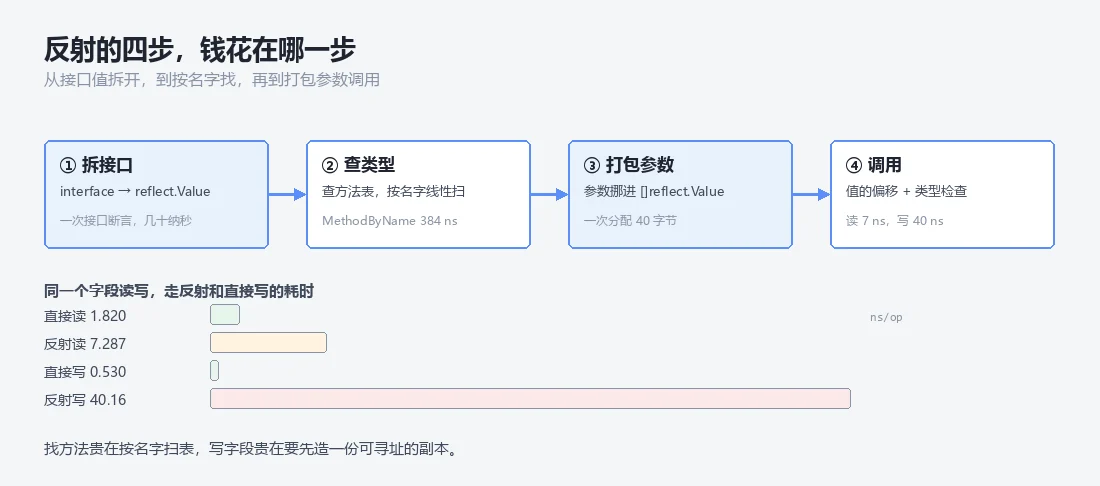
我把这五行抄在纸上横着比,第一次只盯 ns/op 那一列,怎么排都排不出统一的倍数,还以为自己抄错了小数点。(后来发现要对的是分配那两列,不是时间那列。)把字节数和次数单独拎出来排一遍才对上号:读差四倍却一次不分,写差七十六倍只分两次,调用差七百多倍分三次,快慢和分配不在同一栏里同步往上走,拿总倍数说事只能得到一句反射很慢,对改代码一点用都没有。
所以我换了个问法,不问它慢多少,问它每一步在做什么,把每个 benchmark 里发生的事一件件拆开,看哪一件对应哪个数,拆到最后只剩三件事值得单独算。
MethodByName 是按顺序扫,不是查哈希表
1 | type: Field kind: struct fields: 3 |
最后那个小写的 tags 字段导出为 false,它后面会专门制造一次挫败。reflect 包里没有给方法名准备哈希表,MethodByName 拿到一个字符串之后,是按顺序把类型的导出方法表扫一遍,逐个比较名字,找到第一个相等的就返回,中途没有短路,也没有缓存。类型上挂十几个方法的时候,平均要比较七八次,每次比较都得先看长度再看内容,所以它排在五个数里最贵的位置并不奇怪,它把查表、打包参数、真正调用、拆包返回值四件事叠在了同一行里,而查表排在最前面,每次进函数都要从头再来一遍,中间不留任何记忆。我一开始以为 Value 上会缓存一份名字到方法的映射,翻源码才发现没有,它只记着类型指针和值指针那几个字,查表的事一次都帮不上。源码里那段是个 for 循环,下标一个个往前推,取到方法再拿名字比,我盯着那个循环看了半天才确认它真的没有提前退出。还有一个更隐蔽的坑,方法集是按类型算的,ValueOf 拿到的是值,值的方法集里只有值接收者挂上去的方法,指针接收者的方法根本不在表里,MethodByName 找不着,报的错还只是方法不存在,看不出是接收者的种类不对。
这个错我犯过一次(当时以为是名字拼错了,字符串来回改了三遍),最后把 x 换成 &x 就好了。名字查找为什么不能是一次哈希?
Call 先把参数打包成切片再拆开
Call 的签名收的是一个 reflect.Value 切片,这一条就把答案写死了一半。不管你有几个参数,调用方都得先造一个切片,把每个参数包成一个 Value 放进去,一个参数是切片头加一个元素,两个参数就多一个,参数越多这块越大。
返回值还要再包一次,同样是切片。三次分配差不多就是这么来的,查表可能带一次,参数切片一次,返回值切片一次,这三个值都活在堆上,因为它们的生命周期要跨过这次调用,编译器不敢把它们留在栈帧里,哪怕它们只用一次,逃逸分析也拦不住。
函数体再瘦也省不下这两道包装。
它们必须活在堆上这一点我是在汇编输出里确认的,被调用的那个函数在编译期根本不存在,编译器没有别的地方可以替你做这个决定,哪怕它明明只被用一次。
我把它单独拎出来跑了趟 benchmark,把那段调用抄进一个空的 _test.go,只留一个方法,方法体里什么都不做,只把两个参数拼成字符串返回,命令后面跟上 -benchmem 跑,-benchmem 那一列出来的数字和这里对得上。
代价是两头都算的,ReflectMethod 那 384 纳秒里,实际落进被调函数体内的部分可能只占一小块,剩下的大头全在进出这两道包装上。我写了一段等价的代码单独跑过,让方法只返回一个拼好的字符串,别的什么都不做,40 字节和三次分配照样出现。
1 | func callByName(v any, name string) (string, error) { |
读字段只是偏移加一次类型检查
读字段这条路短得多。Value 里存着类型指针和一个指向数据的指针,读一个字段就是在数据指针上加好偏移,再按类型把那段字节解释成对应的值,中间没有切片,没有堆分配,只有一层类型检查保证你读的东西和你要的类型对得上。这层检查省不掉,因为反射的存在前提就是编译期不知道类型,运行时不查这一下,从内存里抠出来的字节就没法解释,编译器也没有别的地方可以替你做这件事。零分配不等于零成本,7.287 对 1.820 只是四倍而不是几十倍,原因就在这里。四倍里有一部分是取偏移,有一部分是类型检查,还有一部分是编译器对直接读那一行做了更狠的优化,把能提到循环外的全提出去了,反射这边每次循环都要重新走一遍 Value 的方法,内联不了,边界检查也省不掉。能省掉的只有调用方自己的重复工作,把 FieldByName 的结果先存下来,循环里直接复用那个 Value,比每次重新按名字找一遍要便宜,因为按名字找又是一次遍历。我在实际代码里做过一次取舍,一个每请求要读十几个字段的导出逻辑留在了反射上,同一个包里另一个每请求要写字段的地方换成了生成代码,那个地方在压测里能看见名字。
后来我把读的这头也改了,先把 FieldByName 换成 Field 加固定下标,再把取出来的 Value 提到循环外面,profile 里那一条矮了一截,代价是多三行缓存变量的声明。
写字段要先造一个可寻址的值
写字段比读字段多了两步,两步都在分配:
- 拿到一个可寻址又能修改的
Value,常见写法是用New造一个新对象再Elem,New要分配一次。 - 改完之后把值取出来,走的是
Interface,这一步要把数据从Value里搬进一个新的接口值,接口里带类型信息,所以又得分配一次。
这两步都不是可以跳过的细节,它们决定了写这条路的成本下限,也决定了它为什么比读贵那么多。64 字节和两次分配正好对上这两步,一份是新对象的头部加三个字段的字节,一份是接口值里那份拷贝。40.16 纳秒里,真正赋值那一句占不到多少,剩下全是这两次搬运。这也说明一个常被忽略的事,反射写字段不是就地改动,更像先复制一份到临时位置,改完再复制回来,语义上是对的,代价是你付了两份内存的账。我把这两次分配在 pprof 里查了一遍,头一次只认出 New 那一处,Interface 那次是后来对着 alloc_objects 的调用栈才找出来的。两次分配各管一段,能不能省掉其中一份取决于你是从已有对象出发还是从零开始造,前者可以省掉 New,后者省不掉,因为没有被改的那个东西压根就不存在。所以我现在写反射填值的顺序是先看手里有没有现成的指针,有就直接 Elem 上去改,没有才 New,这一条写进模板之后,那个填值函数的分配从两次掉到一次,第二次没法省,除非不把值取出来。
CanSet 为假,说明手里那份是副本
反射里最让人卡住的一句话是 CanSet 返回 false(我第一次碰到的时候以为是自己传错了参数),它经常和一句更短的 CanAddr 一起出现。前者问的是这个 Value 背后有没有一个能被取到地址的对象,后者在它之上再多问一句这个字段是不是导出的。两个条件都满足才能改,缺一个就只能读,运行时不给你任何商量余地。我第一次碰到是在一个配置合并的函数里,参数写成结构体而不是指针,编译过得去,跑起来 CanSet 一路是假,我以为是字段名大小写的问题,改了半天没用。
1 | canaddr on value: false |
上面那七行输出把函数里能出现的几种情况摆全了。传值进去,CanAddr 是假,因为函数收到的那份数据是栈上一个副本,反射拿到的只是这个副本的只读视图,改它没有意义。
先传指针再 Elem,CanAddr 变成真,因为 Elem 顺着指针摸到了原来那个对象。
可设置还得分导出不导出,我故意在结构体里留了小写开头、带 tag 的 tags 字段,名字和 tag 都拿得到,FieldByName 一点也不报错,但 CanSet 是假,写进去直接 panic。
最后两行是改完之后的验证,after set 读到 new,iface name 也是 new,call result 那行把新值顺带带了出来。这段代码里我特意留了两个字段没删,一个对应 unexported settable 那行,一个对应 canaddr on value 那行,它们正好是最常踩的两个坑。
它只是副本,不是原件,所以我把这条规则写进了自己的检查清单,凡是准备用反射改值的地方,先问调用方递进来的是指针还是值,再问要改的字段是不是大写开头,这两问花不了几秒钟,比线上多一个零值便宜太多。
这两问我在 code review 里也用过,看到有人拿 ValueOf 的结果直接去 Set,就让他先打印一次 CanAddr 和 CanSet 再往下写,打印出来通常就明白了。
缓存 Type 只省掉接口断言那一下
reflect.TypeOf 的结果是全局缓存的,同一个类型反复取,拿到的是同一个指针,运行时内部有一张按类型排的表,第二次以后基本就是一次命中。这句话容易被读成反射可以缓存,其实能缓存的只有类型和值这两样东西。
能省的是前面那一段,也就是从接口到类型的那次断言加那次查表。查表省下来是实的,可 ReflectMethod 里最贵的是参数切片和返回值切片,这两块每次调用都得重新造,因为内容随参数变,没法复用,剩下的距离它一步也挪不动,所以见到把 TypeOf 结果塞进 map 当万能优化的人,我会多问一句他省掉的到底是什么。
真要进热路径,就在编译期写死调用
把三件事都数完之后,结论比较硬,反射的成本里只有第一件能被缓存掉,后两件是它存在的前提。只要有反射值就得包,只要跨过函数边界就得拆,这不是实现得好不好,是这条路本身要付的过路费。
想再往下压只能换一条路,在编译期把具体的字段访问和调用写死,常见做法是写一个生成器,读结构体的 tag,生成一份普通的赋值代码。生成出来的东西里不再出现 reflect 这几个字,也不会在堆上多出任何一个切片。
生成器这活我写过两个版本。第一版用模板拼字符串,字段名先靠反射从结构体里读出来,再塞进模板,跑一遍生成了两份文件,一份是纯赋值,一份读写都带,结果第二份半年没人用,最后删了。
生成出来的代码在 profile 里和手写的那份看不出区别,因为它们本来就是同一种东西,编译器看到的是同一批指令。我第一次打开生成的文件还有点不适应,一个字段一行赋值,整齐得像机器排的,可跑起来和手写的一样快,说明这块本来就不该留给运行时去猜。
我在一个导出模块里试过这条路,把二十来个结构体的填值代码全生成出来,上线之后再看 profile,那段逻辑从前面几名的位置上消失了。
代价是构建流程里多一步生成命令,改了结构体忘了跑就编译不过。这个痛感比运行时那几十纳秒实在,头一回就是忘了跑生成命令,编不过,找了十分钟才发现是这回事。后来我们把它挂进 go:generate,又在 CI 里加了一步,生成完之后 git diff 必须干净,不干净就让构建失败。有一次更冤,tag 里的字段名写错一个字母,生成器认不出来,直接跳过了那个字段,编译照样过,跑到线上那个字段一直是零值,查了两天才查到生成那一层。
也不是所有地方都值得这么干,配置解析、一次性的命令行参数映射,这类代码执行次数少,一次 384 纳秒摊不到任何东西上,为它加一套生成器反而是负担,还得有人维护那套模板。
我现在给自己定的线是看单次请求里的调用次数,几十次以下用反射没关系。
每请求几千次又在 profile 里露头的就换成生成代码,别在 Type 缓存上继续抠。反射最贵的地方不是它查了表,是它每次都要把数据搬进搬出那两个切片,这两个动作没法缓存也没法绕开,唯一的办法是不进入这条路径。