trace 把调度器的每一步都摊开了
trace 把调度器的每一步都摊开了
隔壁老康难度 ★★★★☆ · 前置:反射慢在哪,以及什么时候真的该用 | 一句话结论:trace 不回答哪里慢,它回答的是谁在等谁,排队、唤醒、重新上 P 这些时间在 CPU profile 里是一片空白,只有事件流记得住。
这份 trace 是我在本机跑一个很小的程序时留下的。程序小得没什么可看,八条 goroutine 各自在 trace.WithRegion 圈出来的一块地方做二十万次取模累加,完事睡十毫秒,再往一个容量一百的 channel 里写自己的编号。
主 goroutine 用 WaitGroup 收口,收口之后故意造一次锁等待,持锁睡三十毫秒,自己再睡二十毫秒,task.End() 才轮到 trace.Stop()。环境是 go1.27.2,windows/amd64,GOMAXPROCS 是 32,机器是 i9-14900HX。我本来只想确认一件事,WithRegion 打进去的那块区域在网页上还能不能按任务筛出来,结果产物只有 5077 字节,解成文本却是九百一十二行事件,一个顺手就能写完的小程序被摊成这么多行,我反而想接着往下看了。
拿到文件我先用文本编辑器从头翻到尾,没用任何工具,就是一行一行往下滚,滚完才对那些数字和状态名有了点手感,再打开网页视图才不至于被那张图直接吓退。
它记的是什么时候,不是多少次。代码短得没什么讲究,三个 sleep 是特意留的。一处睡在区域外面,一处睡在锁里,一处睡在收尾之前,为的是在时间轴上留下三段长度不同的空白,好让我知道那些空白在图上到底怎么画出来的。
1 | f, _ := os.Create("trace.out") |
1 | trace.out=5077 bytes |
五千零七十七字节,比一张手机截图还小。文件里装的不是采样点,是一条一条带时间戳的事件,程序里发生过的每一次状态变化都在里面占一行,所以字节少不代表信息少,它只说明这个程序本身没什么可记的。
小得不像一份性能数据。
解成文本之后是九百一十二行(一个跑八百毫秒的程序,摊平了比很多服务的日志还长,这个反差我看了好一会儿)。
我按状态聚合过才敢说看懂了,原始行长得很规整,开头是 M、P、G 三个身份,中间是事件名,最后是一串时间戳,认字段全靠位置,位置从头到尾没变过。
Trace 记的是事件流,一行一个时刻
先说清楚它跟 pprof 的根本区别,这个区别决定了后面所有读法。pprof 是采样,每十毫秒打断一次程序,记下当下那摞栈,跑得越久的函数被抽中的概率越高,所以它天生擅长回答谁在烧 CPU,对等待这件事近乎瞎。trace 反过来,它不采样,它在每一个调度决策的点上插一条记录,谁变成可运行、谁上了哪个 P、谁开始等锁,都得留下一行,代价是行数跟着事件数走,不是跟着墙钟走。
一个跑了十毫秒的函数在 profile 里会被抽中一次,在 trace 里可能一条记录都没有,因为它没做任何让调度器在意的事。我一开始也拿 profile 的思路去读它,想着找出最耗时的那一段,找了半天才发现它根本没有耗时这一栏,只有先后和状态,两种数据的形状从根上就不一样。一行事件只描述一件事,发生在某一纳秒,由某个 M、某个 P、某条 G 参与。这句话听着像废话,可它决定了你会不会硬从一行里读出趋势来,趋势得靠自己把行拉成序列。
一份 trace 打开之后,第一眼该看哪条轨道?
身份三件套,和那一行全是负一的
解出来的每一行开头都是 M、P、G 三个数,操作系统的线程号、逻辑处理器的编号、goroutine 的编号,这三样凑齐了才能说清一件事发生在谁身上。M=-1 P=-1 G=-1 那种行是全局事件,不属于任何一条 goroutine,也不属于任何一个线程(比如开头那条 Sync),它记的是这份文件里所有时间戳的原点。我看行的时候习惯先扫这三个数,全是负一就说明这是一条记账用的全局行,可以跳过去,有具体编号的才是程序自己跑出来的动作。这些编号本身没有含义,它们是运行时按需分配的顺序号,上一份 trace 里的 21 在这份里可能是别的东西,所以只能在同一份文件里横向比。真要比跨进程的东西,唯一的锚是那条带 Wall 的 Sync 行,其余编号都只是这份文件的内部约定,出了这个文件就不作数。
第二行和第三行放在一起很有意思。
同一个 M 46728 先变成 Running,紧接着挂上 P=31,再挂上 G=1。
线程先有,票再发,人再上,顺序不能反,反过来就说不通。32 这个数是一切的起点。第四行是 Metric 事件,名字写得很直白,值就是 32。GOMAXPROCS 是 32,网页视图就会画出三十二条泳道,同一时刻最多三十二条 goroutine 在实际执行。
那八个 worker 为什么有的落在 P=31,有的落在 P=30,有的落在 P=28,答案不是它们被分到了不同的核,而是它们排在了不同的 P 上,P 和核之间还隔着一层调度器。
1 | M=-1 P=-1 G=-1 Sync Time=232482657877668 N=1 Trace=232482755586006 Mono=383682513358600 Wall=2026-11-16T12:10:02.2663059+08:00 |
两条时间轴,一条给顺序一条给日历
Sync 那一行同时给了三个时间,三个不是三套互相独立的东西,后两个之间差一个固定偏移,Trace 和 Mono 之间也差一个固定偏移,换算一次就能来回走。
| 刻度 | 从哪儿算起 | 什么时候用它 |
|---|---|---|
| Trace | 这份文件开写那一刻 | 看两件事谁先谁后,它不随系统对时跳变 |
| Mono | 系统开机那一刻 | 工具内部换算,我基本不直接看 |
| Wall | 带时区的日历时间 | 跟服务器日志、跟一个具体时刻对上 |
要记住的只是用途,看两件事谁先谁后必须用 Trace 时间,要跟服务器日志、跟一个具体时刻对上,就得用 Wall,因为只有它是人能直接读的。那条偏移本身不用记,工具换算的时候会用上,我只需要知道这两套刻度各自能被谁认出来。刚才那条 Sync 行里 Trace 是 232482755586006,Wall 是 2026-11-16 十二点十分零二秒出头,看着毫不相干,其实指的就是同一个瞬间,只是各自从不同的零点算起。三个数指的是同一个瞬间。区域开合那两条也能这样对。同一个 G 的 RegionBegin 是 232482755759425,RegionEnd 是 232482755779121,两条相减是 19696,单位纳秒,不到二十微秒(这个数小到不像是人类能干出来的事,我核了三遍才敢往下写)。
二十万次取模加上那点累加,真正占用的时间就这么长。程序的大部分生命根本没花在算上,全花在等上。这一条推论在 CPU profile 里看不出来,因为 profile 只统计在跑的那部分,停下来等的时间它压根不采样。
从不存在到不存在,中间隔五步
挑一个 worker 单独跟一遍,GoID 是 21,五条事件正好走完它的一生。先是 NotExist 到 Runnable,这一步是 go 语句把它创建出来的瞬间,它还不属于任何队列,只是被标记成可以跑了。接着 Runnable 到 Running,说明它拿到了一个 P,开始在某个 M 上执行。
然后 Running 到 Waiting,它卡住了。再往后 Waiting 到 Runnable,条件满足,它回到队列,但还没开始跑。最后 Running 到 NotExist,函数返回,它消失了。八条 worker 每个都是同样的五步,一条不多一条不少,整齐得像是模板印出来的。二十万次取模在这个尺度上根本不值一提,真正把这条生命线拉长的是中间那一下等待,而计算那一段掐头去尾还不到二十微秒。
1 | GoID=21 NotExist->Runnable |
  stateDiagram-v2
  [*] --> NotExist
  NotExist --> Runnable: go 语句创建
  Runnable --> Running: 拿到 P
  Running --> Waiting: 阻塞
  Waiting --> Runnable: 条件满足
  Running --> NotExist: 函数返回
  NotExist --> [*]
起点和终点都是不存在。
这五步里最容易被忽略的是 Waiting 到 Runnable 和 Runnable 到 Running 是两条,不是一条。
被唤醒不等于马上执行,中间还隔着一个排队的过程,这段时间在 trace 里能单独量出来,就是调度延迟。
六种状态里还有 Syscall,系统调用期间它是单独一个态,跟 Waiting 不是一回事,等待是主动让出,系统调用是被动卡住,P 还可能被别的 G 借走再还回来。
系统调用期间 P 会被放走。
1 | 26 Runnable->Running |
十三条 NotExist 到 Runnable,意味着这份 trace 里一共新建过十三条 goroutine,八条 worker 加主 goroutine,多出来的四条我没逐条去认,大概是运行时自己的后台活。
十六次等待,比八多出来的那一倍
Running 到 Waiting 出现了十六次,八条 worker 平均每人两次。第一次好解释,每条 worker 都睡了一次十毫秒,睡眠在 trace 里就是一次进入等待再醒来的过程。第二次要分情况,八条 goroutine 是并发的,谁先谁后没定,所以有的是在往容量一百的 channel 里写编号时挂住,有的是在 Done 那里跟别人抢同一个原子操作。不管哪一种,表现出来的都是同一条边,工具不会直接告诉你它在等谁,得自己回头看那一行后面跟着什么,再顺着时间戳找是谁把它叫醒的。我原本以为这条边会带上一个原因字段,翻了几遍才发现 Reason 那一栏基本是空的,等待的原因是靠上下文推出来的,不是它告诉你的。睡十毫秒也是一次状态转移。主 goroutine 那次锁等待更干脆,它持锁睡了三十毫秒,别的人在外面等,自己在 Unlock 的时候也可能被撞上。锁等待在调度视图里没有任何特殊标记,它就是一次 Running 到 Waiting,再一条 Waiting 到 Runnable,跟睡一觉长得一模一样。
判断的办法只剩一个,看时间戳对得上谁。三十毫秒这个数太有特征,在时间轴上一眼就能挑出来,挑出来之后才知道那根竖线上的空白是锁画的。十六这个数不是固定的。
把睡眠那一段删掉,这十六里立刻会少掉八次,把 channel 换成无缓冲的还可能更多,因为无缓冲的写要等对面把值接走。等锁也算等待。
延迟 profile 算的是排队,不是干活
trace 最容易被低估的一点是它能转进 pprof 的世界再看。用 sched 这个出口转一次,整份 trace 里的排队时间就会被折算成一份调用图,谁在等、等多久,都按栈归到函数上。我那次转出来的总量是 110.37 微秒。这份 profile 的类型写着 delay,它算的不是函数执行了多久,而是它从可以跑变成正在跑之间空等了多久。这样 Add 排第一就很好理解,八条 goroutine 同时往上加,原子操作本身很快就完成,被挡住的那几条要排队,排队的时间全记在这行头上。Mutex 的 Unlock 排第二,说明解锁那一刻有人正好在等,得把它叫醒,叫醒这个动作本身也要花一点。它的分母是一百一十微秒,不是整整一份 trace 的时长,所以百分比看着小,绝对量也小,只能用来比较彼此。这里的 flat 是排队总时长,不是函数自己花的钱,跟 CPU profile 里那个 flat 同名不同义。
排队的时间是别人花掉的。总量只有一百一十微秒,因为这份 trace 里在排队的时间本来就少,八个 worker 各干各的,三十二个 P 有一大半闲着。要是把 GOMAXPROCS 压到二,同一份程序转出来的 delay 会是另一个形状。
1 | Type: delay |
网页那张图里,一行是一个 P
打开网页视图,主图是按时间轴铺开的,横轴是时间,纵轴是 P,每一行是一条泳道,泳道里那些彩色的小块就是某个时刻正在跑的 G。第一眼容易把行当成线程,其实不是,行是 P,M 是可以在 P 之间换的,一个 M 堵进系统调用,P 会先下来交给别人。所以这张图回答的问题是谁占着票,不是谁占着核,这两个问题在很多故障里会给出完全相反的答案。我第一次看它的时候还以为是线程池那张图,找了好久没找到自己那条 goroutine,后来才明白它一直在第二行。行号只是 P 的编号,跟核的编号没有对应关系,同一行上前后出现的两块也可能根本是两条不同的 G。泳道里的空白不代表程序停在那,代表这个 P 此刻手上没有 G,正闲在那里。三十二条泳道大部分时间是空的,整份 trace 里新建过的 G 一共十三条,八条 worker 加主 goroutine,再加四条运行时的后台活。图表比数字诚实。
这是把业务概念塞进调度视图的唯一入口。
那行 Parent=18446744073709551615 是 uint64 的负一,表示这个任务没有父任务,它是整棵树的根。区域成对出现,都带着 Task=1,所以网页里能按任务过滤,只看主任务底下那八段。不这么做,你面对的只有一堆 GoID,谁也认不出哪个是下单、哪个是扣款。
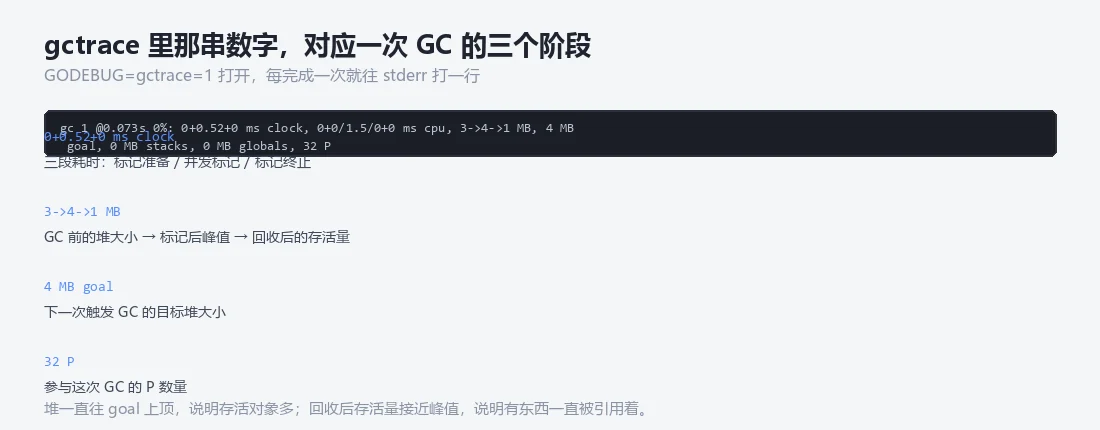
1 | M=46728 P=31 G=1 TaskBegin Time=232482755678199 ID=1 Parent=18446744073709551615 Type="main" |
四种阻塞 profile,和一次开短窗口的取舍
go tool trace -h 里列了四种可以转出去的 profile,四种加起来覆盖了大半场景:
| 类型 | 记的是什么 | 什么时候看它 |
|---|---|---|
net |
网络阻塞 | 怀疑对端慢、连接卡在半路 |
sync |
同步原语阻塞 | 锁竞争,等待时间加在谁头上 |
syscall |
系统调用阻塞 | 磁盘、文件描述符这类真出去了的调用 |
sched |
调度延迟 | 剩下那种说不清的卡,谁排了多久队 |
1 | Generate a pprof-like profile from the trace: |
这里有个反直觉的地方,它们是同一个工具的不同出口,不是四个工具。采集一次,四种视角随时切换,不用为了看锁竞争再跑一遍程序。
帮助里还有一句容易被跳过的话,网页视图来自 Chrome 的 trace-viewer 项目,只在 Chrome 上做过积极测试。用别的浏览器打开可能白屏,也可能能开但点不动。(我第一次在别人的机器上打开就是白屏,还以为文件坏了,换回本机才看见图。)
代价得说清楚。trace 记的是事件流不是采样,每一次状态转移、每一次区域开合都占一行,事件密度一高,程序会被明显拖慢,产物也会跟着事件数一起涨。所以它适合的是短窗口,几十秒,最多一两分钟,够复现一次问题,然后把文件拖回本地慢慢看。挂在线上长期开着是另一回事,那是指标和持续采样的活,不是它的。这跟 pprof 的取舍正好相反,profile 可以常开,因为它按固定频率抽一次,开销基本稳定,trace 的开销跟着事件数走,没法预估。跑得越久,文件涨起来的幅度越取决于这段时间里发生了多少事件,跟墙钟关系不大。短窗口,只开一次。我现在的习惯是这样,线上出问题先在容器里抓一小段 trace,同时把那段时间的日志留着,回来先拿 Wall 对齐,再看那几条状态转移有没有异常,最后才转 sched 看谁在排队。
三步走完,基本能判断是锁、是网络、还是票不够用。