零值不是「空」,是一个具体的数
零值不是「空」,是一个具体的数
隔壁老康难度 ★☆☆☆☆ · 前置:
:=和var的差别,比你想的要大 | 一句话结论:Go 里没有未初始化的变量,只有被初始化成零值的变量,这个零值对每个类型都是确定的,而每种零值能不能用、怎么用,差别大得超出直觉。
用 %+v 打一个没初始化的结构体(这个格式我现在还用,排障时比打印器友好),出来是 {Name: Retries:0 Queue:<nil> OnDone:<nil>} 这么一行,四个字段,三种写法。Retries 是 0,Name 后面空着,Queue 和 OnDone 是 <nil>。空的那个我一开始以为是打印器的手滑,换个格式再打一遍还是空。差得最远的还是后两个。
Queue 是 chan int,OnDone 是 func(),零值都叫 nil,打印出来一模一样,可真用起来一个在 select 里永远不 ready,另一个一调用就崩。
同一个 nil 落在不同类型上,能做的事完全不一样。
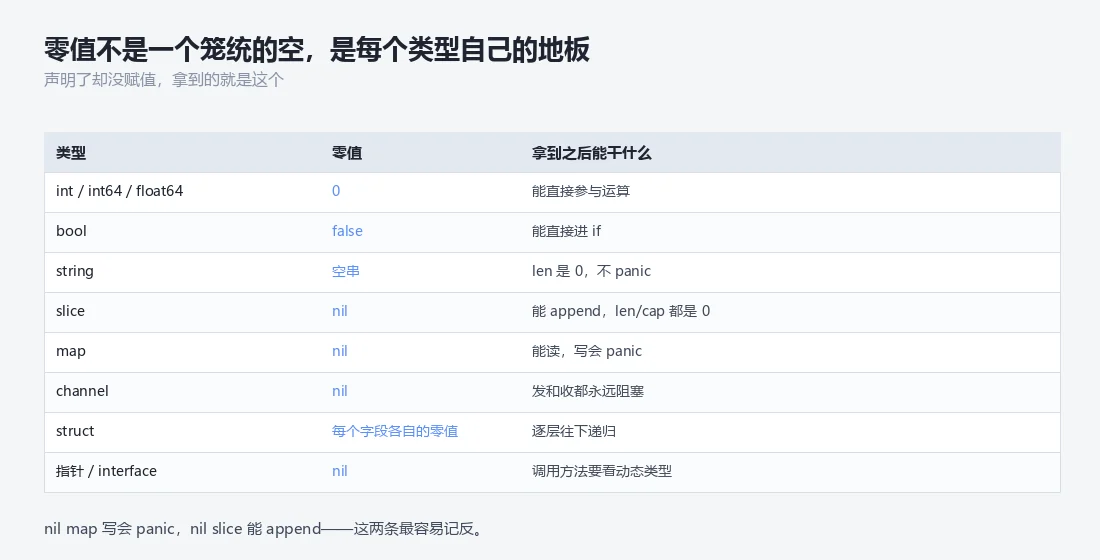
零值是每个类型的地板
我写了一段把所有类型都打印出来的代码(本来是想找几个反直觉的例子),第一次跑的时候有点失望,因为输出太整齐了。
1 | struct zero: {A:0 B: C:[] D:map[] E:<nil> F:<nil>} |
六个字段,六个 true 一个不落:
| 字段类型 | 零值 |
|---|---|
int |
0 |
string |
空串 |
| 切片 | nil |
| map | nil |
| 指针 | nil |
error 接口 |
nil |
%+v 打印的时候切片和 map 显示成 [] 和 map[],那是格式化的呈现方式,跟空切片、空 map 的打印长得一模一样,这个重合后面还会再咬我一次。要注意 error 这个字段,它是个接口,打印出来是 <nil> 而不是空,因为接口的零值连类型信息都没有,格式化器在没有任何类型可依据的时候只能打这个。这个细节在排查问题时很有用,你在日志里看到 <nil> 和看到 null 是两回事,前者说明这个接口压根没被赋过值,后者说明它装着某个东西,只是那个东西本身是空。这个区分在排查线上问题时能省掉很多弯路,我有一次追一个空指针,日志里打印的是一个指针字段,我盯着那个 0x0 看了一会儿,才想起来它可以有两种来源,一种是从来没被赋过,一种是被赋了一个零值指针,这两条路径在代码里的位置完全不同。
把这几个 nil 排一排,差别就看清了。
这六个字段是我照着文档一个个试出来的。
1 | var sl []int |
四个变量,四个 nil,但它们的类型不同,能做的操作也完全不同。切片可以 append,map 只能读不能写,channel 收发都阻塞,函数调用直接崩。同一个 nil,四种命运,这件事如果零值真是空的,根本不会发生。
这就是我说零值不是空的意思。
一个 nil,四种方言。如果它真是空的,那这四种情况应该表现一致,都不许用或者都能用,可它们表现出的差异恰恰说明它是一个有类型的、有确定含义的值,这个值在每种类型里有各自的解释。切片解释成空集合,map 解释成空表,channel 解释成不存在的通道,函数解释成没注册的回调。同一个位模式,四种语义,这正是静态类型在零值上的投影。换句话说,零值不是一个中性的起点,它是类型契约的一部分,每种类型都得为它指定一个合法的、能被接受的值,这个值必须是该类型的合法实例,不能是某种未定义的特殊状态。
nil 切片能 append,nil map 只能读
切片这个类型我得单独说,因为它的零值行为是最容易被误解的。它被误会了很多年。
1 | var sl []int |
输出 0 0、true,然后 append 成功。一个 nil 切片,长度和容量都是 0,append 上去它自动分配了一块底层数组给你,整个过程没有一句警告。所以你在初始化一个 []T 的时候根本不需要 make,var s []T 加 append 就够了,这比 make([]T, 0) 少一次分配,也比它更诚实,因为 make 出来的空切片和 nil 切片在 len 上看不出区别,只有 == nil 才分得清。
range 一个 nil 切片更没事,一次都不进循环体,不崩不报错。
这是 Go 里一个很舒服的设计,你不需要为空集合写特判,遍历就是了,循环体自己不会执行,也就不会有越界的问题。
nil 切片和空切片打印一样,为什么行为不一样?map 就不一样了。读可以,写不行。
1 | var m map[string]int |
len 是 0,读一个不存在的键返回零值,第二个返回值是 false,这些都没问题,遍历也没问题,一次都不进。但一旦你往里写,立刻崩,报错原文是 assignment to entry in nil map。这个错误的措辞很直白,说的是往 nil map 里的条目赋值,不是 map 未初始化,它默认你已经知道 nil 就是个值。
这个差别的原因在结构上,切片的零值是一个长度 0 容量 0 的头部,append 做的事情是发现容量不够就分配新数组(这条路径本来就存在),nil 只是容量不足的极端情况。而 map 的零值是一个空指针,往空指针里塞东西没有可以走的路径,哈希表本身还不存在,得先 make 出一张表来。所以 map 要写必须 make,这是硬性的。这个不对称谈不上设计失误,它就是两种数据结构在生长方式上的差别,切片是线性的、可以用重新分配来生长,map 是散列的、必须先有一块能放桶的内存才能谈插入。
理解这一点之后,就不会再指望写 map 能像写切片那样自动就绪。这个不对称在实际代码里还有个后果,一个含 map 字段的结构体如果通过零值声明得到,那个 map 就是坏的,而一个含切片字段的结构体通过同样的方式得到,那个切片却是好的,两件看起来很类似的事,一个要额外处理一个不用。
等一下,这段我重读,发现自己讲快了。上面那个切片能长、map 不能长的对比,我是从 append 那几行和 map 的实际行为反推出来的,哈希表的实现我没认真读过,所以只能算猜得对,不能算推得对。
我见过不少人在结构体里放一个 map[string]string 字段,然后忘了在构造函数里 make,读的时候一切正常,第一次写就崩,而且崩的位置往往离出错的地方很远。这个 bug 的恶劣之处在于它把读能用当成了初始化好的证据,而这两件事在 map 上压根不是一回事。
防线其实很简单,构造函数里给字段赋一个空 map,或者写一个懒加载的取值方法,在第一次写之前判空然后 make,两种都行,怕的是压根没想到要去防。
nil channel 不报错,它只是永远不 ready
channel 的零值行为在我看来是最反直觉的一个,但它也是最优雅的一个,优雅在于它讲道理。
1 | var c chan int |
这段走 default。一个 nil channel,在 select 里永远不会被选中,无论你等多久。它不崩,不报错,就这么安静地待在候选列表里,然后永远不满足条件。如果你不用 select,直接 <-c 或者 c <- 1,那就永久阻塞,runtime 会判定所有 goroutine 都睡着了然后 panic,报 all goroutines are asleep - deadlock!。
但那是整个程序死锁的判定,不是这个 channel 本身的错误,一行 c <- 1 单独拿出来看是没有问题的。
这个永远不 ready 的性质被大量用在一个地方,就是可选的通知。你想让某个 goroutine 只在特定条件下退出,就在结构体里放一个 stop chan struct{},正常情况不赋值,它就是 nil,那个 select 分支永远不走,退出逻辑相当于被关掉了,需要的时候给它赋一个真 channel,逻辑就打开了,不需要额外加一个 bool 开关。
这个用法我第一次见的时候以为是 hack,后来发现这是 Go 里表达这个通道不存在这件事的标准写法,比加标志位干净得多,也更难写错。
零值可用的类型,才是好类型
上面那些讲的都是语言内置类型,换到自己写的类型上,问题就变成另一个,你设计的那个类型能不能做到零值可用。标准库里有一批类型是照着这个标准做的。
1 | zero Mutex usable |
sync.Mutex 的零值就是一把没人持有的锁,直接 Lock 没问题。sync.WaitGroup 的零值就是一个计数器为 0 的组,直接 Add 没问题。bytes.Buffer 的零值就是一个空缓冲,直接 Write 没问题。这三个都不需要构造函数,你写 var mu sync.Mutex 就能用,把它作为结构体字段嵌进去,外层结构体一旦被声明,锁也就准备好了。这件事的价值在接口设计上。零值可用是一条设计红线。如果你的类型零值可用,用户就可以直接 var t T 或者把它放进结构体的字段里,什么都不用管就能用。如果不可用,就必须提供一个 NewT() 并且每处使用都记得调,而只要有一个人忘了,就是一个运行时崩溃,这个检查和提醒的工作永远落在写调用方的那些人身上。更麻烦的是这种错误在测试里往往发现不了,因为写测试的人自己会记得调构造函数,漏掉的是那些后来接手、只看了函数签名就上手用的人。这条规矩我后来扩展了一下,凡是导出类型,构造函数能省就省,实在省不掉就在方法的第一行判一下,宁可多一次 nil 检查,也不要让调用方去背这个记忆负担。
我在项目里定过一条规矩,凡是我自己写的包,导出类型必须做到零值可用。
做不到的时候必须在文档第一行写清楚必须用 New 创建,那条注释是我们给自己留的欠条,也是给下一个接手的人留的警告。
零值和 JSON 之间那层误会
零值最容易出问题的地方不在内存里,在序列化的时候。
序列化那头只认 null 和 []。
这个 null 我是在对接方那边先看到的。
1 | marshal zero: {"Name":"","Retries":0,"Tags":null,"Extra":null,"Timeout":""} |
注意这一行的两个 null。结构体打印出来是 Tags:[] 和 Extra:map[],看着像空集合,但 JSON 里它们是 null,因为它们的零值就是 nil,nil 切片和 nil map 序列化出来就是 null。要让它们变成空数组和空对象,你得显式初始化,光靠声明是没用的。
1 | nil slice: null empty slice: [] |
这两行的长度都是 0,len 相等,用 fmt.Sprint 打印出来也一模一样,但 JSON 一个给 null 一个给空数组。对接方如果是强类型语言,看到 null 会走另一条反序列化路径,很多字段丢失的线上问题都是这么来的。指针字段的情况更明显,Retries *int 的零值是 nil,序列化成 null,这个用来区分没设置和设置为 0 是很有效的,代价是取值的时候每次都得判空。我在一个对接三方接口的项目里被这件事折腾了半天,对方要求数组字段必须是空数组,我们这边一直是 null,查到最后就是因为那个切片从来没被初始化过。这件事之后我给自己加了一条规则,凡是序列化出去的结构体,切片和 map 字段一律在构造函数里初始化成空集合,宁可序列化出一个空数组,也不要给对面一个 null,因为对面怎么处理 null 我控制不了。
回来的时候 null 会解成 nil。
1 | after unmarshal: {x 0 [] map[] } |
我往一个 Config 里塞了一个只有 Name 字段的 JSON,跑完发现 Tags 和 Extra 都是 nil,不是空集合。这符合直觉,缺的字段就不动它,零值自然保留,但如果你的代码在别处假设了这两个字段非 nil,那就崩了,而且这段代码在有人手工构造对象做测试的时候不会崩,因为手工构造的时候你顺手填了空集合。
这类问题只在真实流量进来的时候才暴露,而它暴露出来的位置往往离真正的缺失很远。
var x int 和 x := 0 的差别
这两个写法编译出来的代码一模一样,内存里的位模式也一模一样,落到的状态是同一个状态。我用 go build -S 看过两者的汇编,MOVQ $0, (SP) 这一条一字不差,所以如果你只是为了性能而在两者之间犹豫,那可以不用纠结了,这个层面的差别是零。
差别全在下一层,在别人读你代码的时候,在他要推断你这句话想说什么的时候。
我现在是能 nil 就 nil,要非 nil 才 make。
| 写法 | 编译产物 | 内存位模式 | 想表达的意思 |
|---|---|---|---|
var x int |
完全一致 | 全 0 | 我先声明一个,值等会儿再说 |
x := 0 |
完全一致 | 全 0 | 我现在就把它设成 0 |
var s []int |
完全一致 | 三字段全 0 | 这是一个目前为空的切片 |
s := []int{} |
多一次分配 | ptr 非 nil | 这是一个已经初始化好的空切片,不为 nil |
前两行的差别纯粹在意图上。意图也是一种信息。读代码的人看到 var x int 会想这里有一个计数器、它从零开始,看到 x := 0 会想这里有一个值被设成了 0,这两种理解在后续读代码时的预期不同。后两行的差别是实质的,var s []int 的 s == nil 为 true,s := []int{} 的为 false,虽然 len 都是 0,可返回给上游的时候就变成了 null 和空数组的区别。
随便聊聊几个边界
数组的零值是每个元素各自取零值,var a [3]int 就是 [0 0 0],这没什么好说的,但它有一个推论值得提一句,数组长度是类型的一部分,[3]int 和 [4]int 是两个不同的类型,它们的零值当然也不一样。
结构体的零值是每个字段各自取零值,这意味着结构体可不可比较取决于字段。能比不能比是类型的一部分。我试过含切片的字段。
1 | .\b.go:16:14: invalid operation: t1 == t2 (struct containing []int cannot be compared) |
这条报错说明了零值的另一面,两个都是零值的结构体不一定能比,因为字段里有不可比较的类型。slice、map、func 都不可比较,含它们的结构体就不可比较。
这一条我写测试的时候踩过,想用 == 判断两个配置对象相等,编译不过,最后只能逐字段比或者用 reflect.DeepEqual。需要注意的是 DeepEqual 认为 nil 切片和空切片相等,所以它判过的两个对象在序列化之后未必一样,接口的零值在这里要单独提一句,因为涉及 nil 的两层含义。
1 | nil error == nil: true |
第一行是 var e error,第二行是把一个类型正确、值为 nil 的指针塞进 error 接口。看着都是 nil,== nil 一个真一个假。这个坑太经典了,专门有一篇讲它。
一张表
| 类型 | 零值 | 能用吗 | 崩在哪 |
|---|---|---|---|
int 等数值 |
0 |
能用 | 不崩 |
string |
空串 | 能用 | 不崩 |
bool |
false |
能用 | 不崩 |
| 数组 | 每个元素零值 | 能用 | 不崩 |
| 结构体 | 每个字段零值 | 看字段 | 看字段 |
| 切片 | nil |
能 append、能 range |
不崩 |
map |
nil |
能读、能 len、能 range |
写入时崩 |
chan |
nil |
在 select 里永不 ready |
直接收发会永久阻塞 |
| 函数 | nil |
不能调 | 调用即崩 |
| 指针 | nil |
不能解引用 | 解引用即崩 |
| 接口 | nil |
判空可用 | 调用方法即崩 |
这张表我看过很多遍,记住的只有其中三行,都是踩出来的。每一行背后都有一次事故。读 map 那段我踩过,往没 make 的 map 里写那段我也踩过,nil 函数调用那段踩过两次,第二次是在一个回调注册的代码里,忘了判空。写这篇之前我又把所有实验跑了一轮,发现有一件事我原来想错了,就是我以为 nil 切片和空切片在 JSON 上也一样,实测不是。len 相等、打印相等、reflect.DeepEqual 也能骗过你,但只要序列化出去就露馅了,一个 null 一个空数组,对接方那边立刻分成两条路走。这件事让我把那个判断改成了看 == nil,因为它才是唯一区分得开这两者的手段。
而 len 和 DeepEqual 都会把两者混为一谈,它们不是骗你,它们只是在回答另一个问题,你问它长不长,它就告诉你长不长,它没责任告诉你那个东西存不存在。
所以零值这个东西,它的坑不在语言层,在语言和外部世界交界的地方,在那些它必须变成一个具体表示的地方。