冲突不是意外,是可以被制造出来的
冲突不是意外,是可以被制造出来的
隔壁老康难度 ★★★☆☆ · 前置:哈希表的 O(1) 有三个前提 | 一句话结论:冲突在平时是概率,在被人盯上的时候是一道可以提前算出来的算术题。
三百三十七个空桶
第一个月接的活是给一份导出的访问日志去重计数。三十多万行,一行一个 URL,我想着自己写个哈希表练手:桶数组开 1024 个,哈希函数图省事,把每个字节加起来再对 1024 取模,桶里挂链表,撞上了就接在链尾。代码一百来行,下午写完,跑出来的去重结果跟同事那份对得上,我挺满意。收尾时顺手把桶长分布打出来看了一眼,本来只想确认没有哪个桶长得离谱,然后就盯着屏幕上那行数字没说话。
最长的一条链挂了七百多个 key,另外三百多个桶一个 key 都没有。
我先怀疑代码。取模、插入、比较,逐行看过去没毛病;又把 key 换成一万个随机字符串重跑,分布立刻正常,说明代码那段没错,问题在数据上。把 URL 按前缀分个组,事情就清楚了:它们前面一大截是同一个域名、同一段路径,只有尾巴上几个字符在变,参数名翻来覆去就那几个词。字节求和这种算法不认位置,只认字符加起来是多少,两个 URL 用的字节一样多,谁在前谁在后它不管,和相同,哈希值就相同。那批日志里同一类接口的参数组合本来就不多,前缀还都长一个样,撞成一坨不奇怪。
换成每读一个字节先乘 31 再加,同一批数据立刻散开了。
我那时候给自己下的结论是数据长得不好,换一批数据就没事了。这个结论只对了一小半:运气确实是其中一项,只是运气这东西能让别人替你安排,只要他知道你用的是哪个哈希函数。
装载因子 0.954 的时候,最长链几千是正常的
一百万个随机字符串,同样 1024 个桶,我跑了两遍。maphash 一个空桶都没有,最满的桶装了 1070 个 key;换成字节求和,337 个空桶,最满的那个 7966 个。一百万个 key 摊进 1024 个桶,平均一个桶九百七十来个,所以 maphash 的最长链贴着平均线,字节求和堆到了平均值的八倍。
同一个坏法,坏得不一样。
后来做另一组实验,我才弄明白最长链这个数字单独拎出来没有意义。它跟三样东西绑在一起:装载因子、冲突处理方式、桶数。
三个不同的哈希函数,一百万个 key 落进 1048576 个桶,开放寻址。
| 哈希函数 | 平均探测次数 | 最长探测 |
|---|---|---|
| FNV-1a 64 | 11.069 | 4261 |
| FNV-1a 32 | 11.235 | 3701 |
| maphash | 11.253 | 3203 |
三行的平均探测次数都在 11 上下,相差不到 0.2 次;最长的那些差得多,4261、3701、3203,可三个都合格。最长到四千多,原因不在哈希函数身上,在装载因子:一百零四万个位置只剩百分之四点六是空的,一路探到空位为止这件事本身就是一次掷骰子,掷得多了总会掷出一长串坏的。装载因子上去,尾巴一定变长,这是概率本身的性质,不是谁写坏了。哈希函数合格与否,看的是它摊得匀不匀;匀的话尾部长度服从一个能算出来的分布,不匀的话,尾巴有多长由造 key 的那个人决定。
上面那三行在前面一件事上打了平手。
摊匀这件事,不一定由你决定。
把字符和凑成同一个数
我给自己出了道题:写一张哈希函数特别烂的表,再造一批专门克它的 key,看看到底差多少。哈希函数就用字节求和,key 定长 16 字节,字符只用 a 和 b。要让它们全撞在一起,只需要每个 key 的字节和相等:16 个位置里固定放 8 个 b、8 个 a,和就恒等于 8 乘 98 加 8 乘 97,1560。位置随便换,和不变,因为加法交换律,挪一次位置的代价是零,这也是这种哈希最要命的地方——它把 key 的排列信息全扔了。
1560 对 1024 取模是 536。
十六个位置里挑八个放 b,一共 12870 种挑法,我取了前 12000 个。前三个长这样:bbbbbbbbaaaaaaaa、bbbbbbbabaaaaaaa、bbbbbbabbaaaaaaa。看着是三个不同的 key,逐字节比也确实不同,交给字节求和,三个都是 1560,三个都落进 536 号桶。
1 | // 16 个位置里选 8 个放 'b',其余放 'a',字节和恒为 1560 |
这不是我瞎凑的,是按公式挑的。
挑一批 key 不需要多聪明,上面那段二十行的代码,一台笔记本跑一秒钟。
一万两千个 key,一个桶
表还是 1024 个桶,链地址法。我故意把桶数钉死不让它扩容,这样两边差的只有哈希函数。
| 哈希 | 用到的桶(共 1024) | 最长一条链 | 查一个不存在的 key(500 轮) |
|---|---|---|---|
| 字节求和 | 1 个 | 12000 个 | 平均每轮比 12000 次,共 6,000,000 次比较,9.361 ms |
| maphash(Go 的随机种子) | 1024 个全用到 | 23 个 | 平均每轮比 9 次,共 4,500 次比较,不到 1 ms |
同一批 12000 个 key,查一个不存在的 key,跑 500 轮。
字节求和那一行,12000 个 key 全在 536 号桶里,剩下 1023 个桶一个没沾上。查一个不存在的 key,得把那条一万二千个节点的链从头走到尾,一轮 12000 次比较,500 轮六百万次,9.361 毫秒。maphash 那一行,1024 个桶全用上了,最长的链只有 23 个,同样查一个不存在的 key,一轮平均比 9 次,500 轮 4500 次,不到 1 毫秒。
一万二千个 key,一个桶。
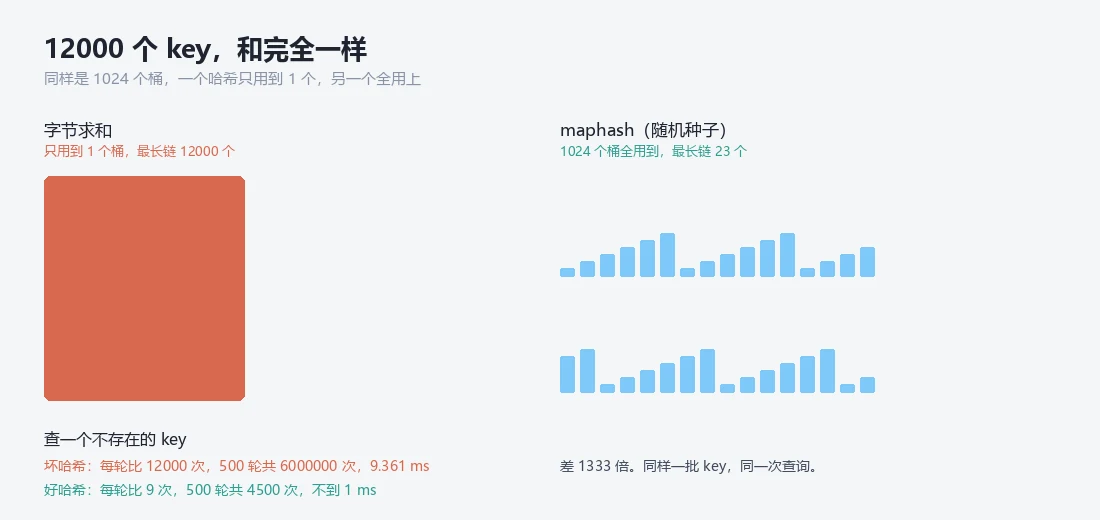
1333 倍这个数得拆开看,两边的代价不跟着同一样东西长。字节求和那边,一次查询的代价跟表里有多少 key 成正比,多塞一个 key,每次查询就多一次比较,表越大越慢,而且慢得没有上限。maphash 那边,代价跟桶里的链长成正比,多塞一个 key,一条链的期望长度只涨一点点,因为 key 会被摊到 1024 个桶里去,表大了它自己会扩容,装载因子压着,链长就压着。
扩容救不了第一种。
那 12000 个 key 不是挤在某个桶,是挤在同一个桶。表从 1024 涨到 2048、4096,哈希值还是 1560,取模还是同一个位置,它们一步都不散。
种子:让你算不出该造哪些 key
挡这个的办法不是把哈希函数写得更复杂。攻击者不需要破解你的哈希,他只需要在离线状态下算出哪批 key 会撞;只要哈希函数是确定的,这件事就一定算得出来,多复杂都一样,复杂度只决定他花几秒还是几天。加一个随机量才管用:表建起来的时候,运行时取一个种子,哈希值算完再跟种子混一次。种子一变,同一批 key 落在完全不同的桶里。
拿不到种子就没法提前把 key 算好,想打一次,得先摸清这一次的种子。
Go 的 map 用 maphash,种子来自运行时的随机源,一张表定一个,进程退了就没了,下次启动换新的。Python 从 3.3 起默认给字符串哈希加随机化,种子归 PYTHONHASHSEED 管,不设就随机。Rust 的 HashMap 默认用 SipHash,密钥每个 map 一份。Python 那条最值得抄:它把一个本该透明的实现细节做成了显式的环境变量,装库、跑测试、开多进程调试,凡是要让同一个 key 在不同进程里算出同一个哈希的地方,都绕不开它。三家做法不同,思路是同一个——让一批能撞的 key,从一条可以离线验证的真理,变成一次侥幸。
随机不是为了加密,是为了不可预测。
Java 走的是另一条路。String.hashCode 是确定函数,同样的字符串永远算出同一个数,没有种子可加,这个算法还写进了规范,想改等于让所有存过的数据对不上。HashMap 的应对只能放在结构上:一个桶里的链长到 8,就把这条链换成红黑树。
树化:把一万二千次比较压成二十几次
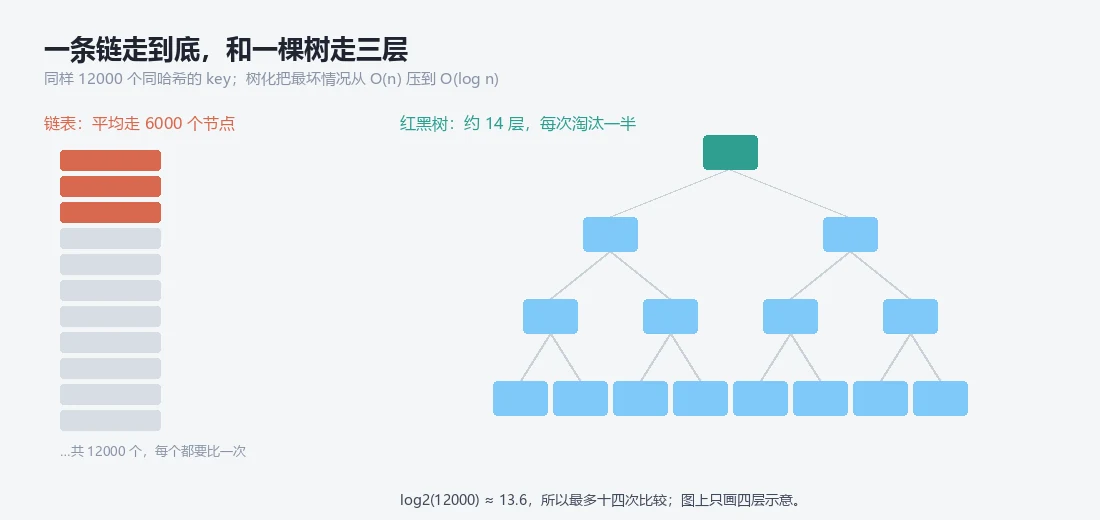
树化就是桶里的链表长到一定长度之后,换成红黑树,让桶内的查找从线性变成对数。
阈值 8 写在源码里,旁边还有一条:表的容量不到 64 的时候先扩容,不树化。容量小的时候桶少,扩容能拆开,划算;到了 64 以上再谈树化,注释里给的理由是别让扩容和树化两套阈值挤在一起互相干扰。
树化之后,桶内查找从线性变成对数。
一万二千个 key 挤在同一个桶里,链要走一万二千步。红黑树的高度最坏是两倍的对数,一万二千个节点算下来二十几层,理想平衡是十四层左右,红黑树允许一边比另一边长一倍,最坏落到二十七八层。String 实现了 Comparable,哈希一样的时候可以按字典序把 key 排开,二十几次比较就够,链表那边是一万二千次。
节点数只是账本的一边,另一边是每个节点占多少内存。
| 指标 | Java 21 HashMap |
|---|---|
| 堆增长(一百万个 22 字节的 key) | 55.81 MB |
| 每个 key 摊到的字节 | 58.5 字节 |
| 命中 | 36.3 ns/op |
| 未命中 | 44.7 ns/op |
一百万个 22 字节的 key,按 HashMap<>(n*2) 预分配,堆增长 55.81 MB,摊到每个 key 是 58.5 字节,是 key 本身的两倍多。链表节点只多存一个 next,红黑树节点要多存左右孩子、父节点和颜色,桶里超过八个的时候,这笔内存才开始回本,回的还是被攻击那一次的账,平时根本走不到那个分支。命中 36.3 纳秒,未命中 44.7 纳秒,5 轮预热、5 轮取最小,-Xmx4g。正常路径上一次查找就是几十纳秒,树化多出来的那几层比较,在这个量级里占不了多少位置。
它压的是斜率,不是截距。
还有个条件得说清楚。树要排得出顺序,才能按二分往下走;哈希值相等、key 又没实现 Comparable 的时候,红黑树分不清谁大谁小,TreeNode.find 只能把两棵子树都摸一遍,最坏又回到线性那一档。String 排得开,你自己写的对象不一定排得开,拿它当 key 就得自己想想这件事,尤其是那些只从外部输入里拼出来的结构体。
哪些 key 是别人递过来的
我现在看一张表,先看 key 从哪儿来。URL 的查询参数、请求头、表单字段、JSON 里的字段名、上传的文件名、日志里切出来的一段,这些都是外面递进来的,而且能反复递,递多少次由对方决定。程序里写死的枚举、自增 ID、内部结构体的字段,外面碰不到,用什么哈希都行。
外面递进来的 key,再看两件事:这张表有没有上限,超了怎么办;哈希函数是不是每张表一份种子。前一个问题的答案如果是没有,一万二千个 key 就够了,一次请求塞不进去,一千次请求就够了。
一万二千这个数不大。
攻击者不用一次灌多少数据,只要让每次请求都落进同一条链,剩下的交给并发,交给时间。表越大,那一条链越长,每次查询要走的路越远,而对方付出的成本一直是那几十行代码。
字节求和那种哈希,我现在只在一种场合还用:key 是程序自己生成的定长 ID,长度固定、字符集固定,外面一个字节都改不了。别的地方要么交给运行时的 maphash,要么给表加一个容量上限,写清楚装满了是拒绝还是淘汰。树化是运行时替你兜的底,兜到哪一层,得你自己知道。