滑动窗口的最大值怎么算
滑动窗口的最大值怎么算
隔壁老康难度 ★★☆☆☆ · 前置:定长数组怎么当队列用 | 一句话结论:滑动窗口最大值的三种写法分别是 O(nk)、O(n log k)、O(n),可 k 缩到一格的时候,那个 O(n) 的写法比暴力慢三十六倍,结构选对了还得看参数。
师傅丢给我一个内部监控页,让我在上面加一条曲线:横轴是最近一小时,每个点是那一刻往前一分钟里的最高延迟。我按最顺手的写法写了个双循环,外层走刻度,内层把窗口里那六十个数重扫一遍取最大,连注释一起十几行,变量名都是现编的。写完刷新了两次,页面没有停顿,我就当这活结了,甚至没往算法那边多看一眼。那台机器上当时还挂着三个表格和两张图,都比这条曲线重,所以它是不是真快,我也没验过。
一小时三千六百个点。
一秒一个点,三千六百个刻度,每个刻度重扫六十个数,一次刷新二十一万次比较。二十一万次在这个页面上快得量不出来,我把它当成一件普通活,没算过那行内层循环跟什么成正比,也没想过数据源会变。那时候我对复杂度的理解还停在面试题上:知道哪个标记更小,但不知道它落到一台具体机器上是什么样子。
后来变了。
数据源改成每二十毫秒一个点,刻度变成十八万个,而往前一分钟这个窗口跟着变成三千个点。刻度涨五十倍,窗口涨五十倍,乘起来两千五百倍,一次刷新五亿四千万次比较。页面开始要等,第一版我以为是前端画坏了,翻了两遍才看明白,慢的是那十来行。
五亿四千万次,一秒一次。
那个下午我去查这道题有没有更好的解法,查到的名字叫滑动窗口最大值。三种写法摆在一起,复杂度分别是 O(nk)、O(n log k)、O(n),看着像教科书上的常识,可我当时没读懂的是括号里那个 n 和 k。它们写的是增长的方向,不是这一台机器上的毫秒数;而让我改代码的偏偏是毫秒数,所以那张复杂度表对我一点用处都没有,我只知道内层循环跟窗口宽度成正比这一件事。我先照着写了一版,又把自己那版留在同一个文件里,总得有个地方让它们对着跑。
一句话的题面,三种代价
题面短得不像一道题:给定 n 个数和窗口大小 k,窗口从左滑到右,每滑一格报出窗口里的最大值,一共 n−k+1 个答案。数组只读一遍,k 固定,k 大于 n 或者 k 等于零的时候返回空。三种写法各自对应一种代价——每个窗口从头重扫一遍是 O(nk),k 越大越难看;大顶堆把窗口里的数排好序,每次进出花 log k 调整,总计 O(n log k);单调双端队列让每个下标只进队一次、出队一次,总计 O(n)。
三行复杂度写在一起像常识。
可这三行背后是三种不同的假设。暴力假设窗口很小,小到重扫一遍不值一提;堆假设窗口里的顺序有用,值得每次花 log k 去维护;单调队列假设的是一件更窄的事,窄到要单独说一段。
那个条件才是骨头。
比它小、又活得没它久的数,可以当场扔掉
那句假设是这样的:新进来一个数 v,队列里所有比 v 小的数,从这一刻起再也当不上答案了。v 比它们大,v 又比它们晚过期;既当不了答案,又活得没它久,留在队列里只是占一个位置。所以新数进队之前,先从队尾开始把比它小的弹掉,弹到队尾比它大为止。这一步不需要知道窗口有多宽,也不需要知道什么时候滑,它只看两个数的相对大小和谁先谁后,这也是它的成本跟 k 无关的原因。
拿五个数 5 3 8 2 9、窗口取三来走一遍就清楚了。8 进队的时候,5 和 3 都还在队里,两个都比 8 小,两个都被弹掉。它们本来还能在窗口 [5,3,8] 里当一次候选,可那个窗口的最大值是 8;从此往后每一个装得下 8 的窗口,最大值都不可能是它们。留着干什么。
比 v 大的那些得留着,它可能是接下来几十个窗口的答案,直到它自己滑出窗口为止。队列里的值于是从队头到队尾递减。
递减,就是单调两个字的来历。
还有一件事容易抄漏:队列里存下标,不存值。存值的话,队头什么时候过期得另外记账,账一多就要出错;存下标,队头一旦落在窗口左边之外,它自己就说明自己该走了,判据是一行减法。这个区别在随机数据上不容易露,重复值一多才看得见。
1 | func maxInWindow(a []int, k int) []int { |
中间那个 for 是这道题的全部:队尾比新数小的弹掉,新下标压进队尾,队头过期就从头弹一格,窗口满 k 个才开始出答案。四件事,一件都不多。
均摊下来,每个下标进出各一次。
内层那个 while 看着像嵌套循环,其实所有窗口加起来最多弹 n 次,因为每个下标进队只有一次,弹出去也只有一次。这个账要这么算:不看某一格弹了多少,看整趟下来总共弹了多少;单看最坏的那一步会把人吓住,看总量就是线性的。我第一次在纸上把这个摊还算清楚的时候,才明白它凭什么敢叫 O(n):整个算法没有任何一步的次数跟 k 挂钩,k 只决定窗口里剩多少个数,不决定做多少动作。
十万个数,三种写法各跑三次
机器是 i9-14900HX,go1.27.2 windows/amd64,GOMAXPROCS=32。数组是十万个随机 int,三种写法各跑三次,取中间那次读数。
差得不算小。
| 写法 | k = 1 | k = 100 |
|---|---|---|
| 暴力,每个窗口重扫 | 0.11 ms | 22.2 ms |
| 大顶堆,带下标判过期 | 没测 | 8.2 ms |
| 单调双端队列 | 4.0 ms | 2.6 ms |
k 等于 100 时,暴力 22.2 毫秒、堆 8.2 毫秒、单调队列 2.6 毫秒。单调队列比暴力快 8.5 倍,比堆快 3.2 倍。
倍数都对得上。
堆输在哪儿,读一遍它的操作就清楚。它维护的是整个窗口的有序性,可题目只要一个最大值。窗口每滑一格,压一个元素进去,把已经滑出窗口的堆顶弹掉,每次调整要走 log k 层。窗口里那 k 个数,绝大多数从头到尾都当不上答案,堆却替它们排好了座次,一次不落地排。它付的是全序的钱,买的是极值的货。单调队列收的钱少,可不是因为它更聪明,是因为它敢不收:它认定了那些被弹掉的数永远当不上答案,于是干脆不给它们留位置,连排都懒得排。
全序的钱,极值的货。
这段代码能不能信,我拿 200 组随机输入对过:n 不超过 200,k 随机,三种写法逐位比对,结果完全一致。正确性这一关过了,上面那串数字才有意义。
k 缩到一,赢家慢了三十六倍
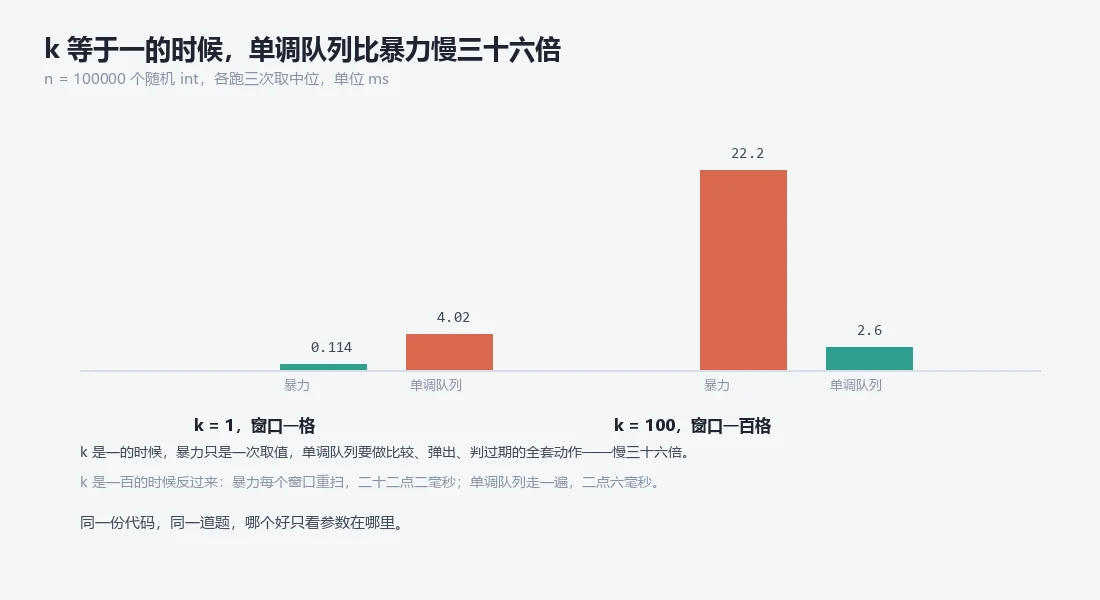
表上有两个数不太合群。k 等于 1 时暴力只要 0.11 毫秒,单调队列要 4.0 毫秒,前者比后者快 36 倍。同一个程序,同一个数组,只是窗口从一百缩到了一格。
胜负反过来了,反得很彻底。
原因不复杂。窗口只有一格时,最大值就是那个数本身,暴力取一下完事。单调队列那四件事一件都省不掉:比队尾、压下标、判过期、判窗口满没满。它维护的是一个长度为一的队列,而维护这个队列的成本,跟维护长度为一百的队列差不了多少;它做的活跟窗口宽度无关,这是它的优点,也是它在 k 小的时候输得难看的原因。优点和缺点共用同一行代码,只是窗口大小换了个取值。我在这件事上走了个弯路:一开始我以为 4.0 毫秒是哪里写漏了,盯着那十来行看了半天,才发现它一个分支也不能减,减任何一个都会在某些输入上算错。
结构要钱,跟它装多少无关。
趋势比这两个数更说明问题。暴力从 0.11 到 22.2,差 192 倍,差不多是窗口宽度乘一个常数,窗口翻多少它翻多少。单调队列反过来,从 4.0 掉到 2.6,窗口变宽它反而快了。我自己的解释是,k 等于 1 时每一步都是进了立刻出,分支和边界检查一次也省不掉;k 等于 100 时同样的操作摊在更长的窗口上,每个元素压进去之后还能多待一阵。这条我没单独测过,只当读数的方向,不当结论。
复杂度管趋势,不管起点。
O(n) 说的是 n 变大时它怎么涨,它没有承诺 n 小的时候一定快。小到 k 等于 1,一个常数项比整个算法的差别还大,这时候比的是谁少做几次分支、谁的循环体更短。
双端队列用切片还是环形,账在分配次数上
单调队列两头都要动:队尾弹、队头弹、队尾进,底下得是双端队列。Go 标准库里没有现成的,两种土办法都能用。
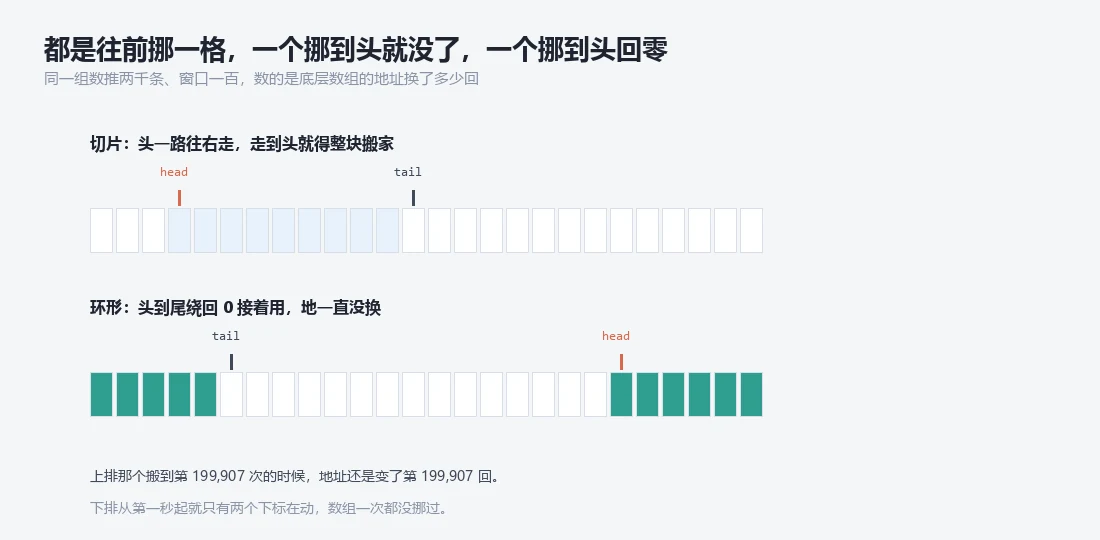
第一种拿切片当:队尾进就是 append,队头出就是 a = a[1:],把切片头往后挪一格。看着像零成本,两次操作都只是改长度字段和那个头指针,数据一个字节都没搬。这个写法在题解里到处都是,因为它短,还不用自己管容量。
挪的是头,不是数据。
实测不是这么回事。往一个切片双端队列里推 200,000 条、不往外拿,底层数组换了 31 次容量,最终 cap 是 219136。换成边推边出、窗口保持 100,同样推 200,000 条,底层数组的起始指针换了 199,907 次,几乎每条都在挪,收尾时 len 是 100,却占着 cap 116。那个切片既不释放前面的格,也不把后面的格让出来,它把这一段时间里进过队的容量都攒在了自己身上。换句话说,它的内存占用记的是最坏那一段的历史,不是现在装了多少:前面推得快、出得慢的时候攒下的容量,不会因为后面又出空了就还给你。
出一格,头指针前移一格。
第二种是环形缓冲,头尾各动一格,容量固定。同样推 200,000 条、窗口 100,容量从头到尾是 1024,当前装着 100 条,一个字节都没多要。
分配次数更直白,读的是 MemStats 里 Mallocs 的差值。切片版推 1,000,000 条滑动窗口,分配 8080 次、13.79 MB;环形版分配 1 次、0.00 MB。窗口放大到 1000、推 4,000,000 次,切片版 7481 次、87.46 MB,环形版 0 次、0 MB。
| 场景 | 切片当双端队列 | 环形缓冲 |
|---|---|---|
| 推 100 万条、窗口 100 | 8080 次分配 / 13.79 MB | 1 次 / 0.00 MB |
| 推 400 万条、窗口 1000 | 7481 次分配 / 87.46 MB | 0 次 / 0 MB |
单看每一下,环形反而慢。稳态下推一条出一条,切片版 5.4 / 9.8 / 17.2 纳秒,环形版 11.1 / 11.9 / 12.5 纳秒,环形要算两次取模,每一下多花几个纳秒。
每一下都慢,总量却省。
这笔账得看场景。滑动窗口常年挂在采集循环里,一秒几次、一次几十万条,攒下来的垃圾总要 GC 收;省下的是 GC 的时间,那几纳秒不算什么。
先看 k 有多大,再决定要不要上结构
那个监控页最终没上单调队列。我跟提需求的人对了一轮,那个指标看的是最近一两秒有没有尖刺,一分钟的窗口本来就宽,改成六十个点之后,一次刷新一千零八十万次比较,照前面那个速率算二十几毫秒,够用。
k 小的时候,结构是负担。
真该上的是另一类场景:窗口几百上千、数据按毫秒进来、每秒都要出结果。那种地方比的不是几毫秒,而是还能不能留出余量,以及这段代码要连着跑多少天。反过来,堆在这道题里也不划算,它把窗口排成全序,题目只要一个最大值,多出来的顺序没有下家接。
判断可以压成两步。先看 k 的量级,个位数就别上结构,双循环又短又好读;再看这段代码要跑多久,一次性跑的脚本和常年挂着的采集循环,容忍度差着一个数量级。
先量参数,再选结构。
我在笔记本上留了那版双循环,注释写了窗口上限和刷新频率,超过某条线再换队列。
现在想想,那行注释比代码有用。它把这个选择依赖的参数记下来了:窗口多大、多久跑一次、单次能容忍多少毫秒。参数一变,选择就该重做一次,代码本身不用动。