Go 只有值传递,切片也一样
Go 只有值传递,切片也一样
隔壁老康难度 ★☆☆☆☆ · 前置:零值不是空,是一个具体的数 | 一句话结论:Go 的函数调用永远是复制,没有例外,所谓引用类型只是被复制的东西里含着一个指针,指针指到的内存是共享的,指针本身不是。
我在别的语言里学了七八年引用传递,转到 Go 之后第一个月一直在找一个东西,一个能把参数改回调用方的关键字。C# 有 ref,C++ 有引用符号,Java 对对象是隐式引用,我下意识以为 Go 也有类似的东西,只是名字不一样,翻了半天文档也没找到。于是我就认定了一件事,Go 里的切片和 map 是引用类型,传进去改就是改原的。
这个认定在大部分时候是对的,所以它能活很久,s[0] = 100 传进去真的改了外面,m["k"] = 1 也真的改了外面,一看就对。
第一次出事是在一个把字节流切块的小工具里,我在函数内部对传进来的切片做了一次 append,回来继续用外面那个切片,结果最后一段数据怎么都对不上,我盯着终端打了半小时日志,每一行长度都比预期少一截。那天晚上我才第一次认真去读切片到底是什么,读完之后发现那个理解把一条更简单的规则糊住了。
那个更简单的规则就是标题里那句话,Go 只有值传递,无一例外。
切片传进去的到底是哪 24 个字节
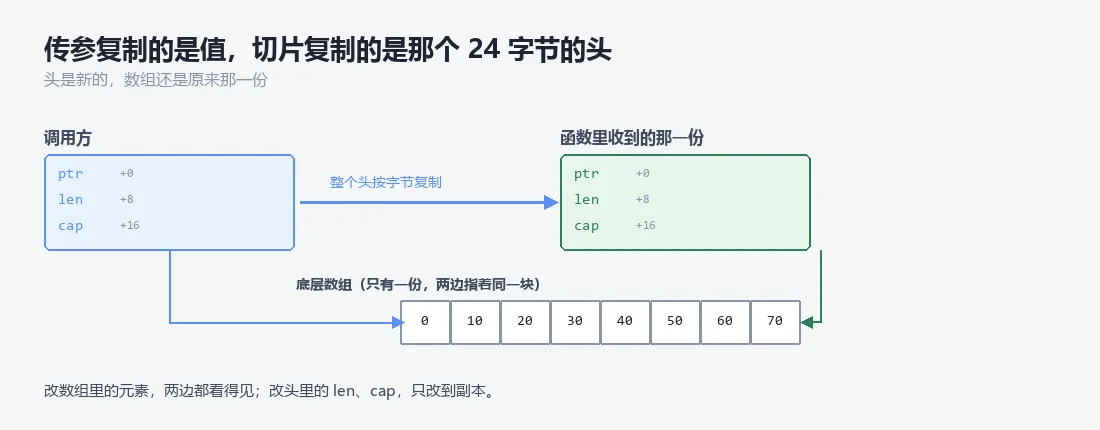
要看清楚这件事,得先知道切片在内存里长什么样。我用 unsafe.Sizeof 把几个常见类型都量了一遍,结果里最值钱的一行是切片等于 24 字节,正好三个机器字,分别是指向底层数组的指针、长度、容量。map 是 8 字节的一个指针,channel 是 8 字节的一个指针,函数值也是 8 字节,string 是 16 字节,一个指针加一个长度,接口是 16 字节,两个指针。这张尺寸表是理解后面所有现象的地基,因为函数调用复制的是这个东西,而不是它指向的内容。顺带说一句,这些数字都是编译期常量,编译器看到 Sizeof 就直接把结果填进去了,运行时不产生任何开销,所以你可以把它当成一个免费的测量工具来用。
这张表是我在通勤的地铁上抄下来的,抄完才发现自己以前对便宜和贵的判断基本靠感觉。
感觉在一个类型只有一个字段的时候很准,到了嵌套结构体就开始飘,到了里面塞了切片和接口的时候基本等于瞎猜。切片传参的时候,复制的是这 24 个字节,不是底层数组。三个字段一模一样地复制过去,所以形参和实参指向同一块底层数组,长度容量也一样,这就是改元素能改到外面的原因,因为两个头部里的指针指向同一个地址。容量这个字段存在的原因也很直接,append 拿到一个新头部之后,要判断这件事能不能就地做,判断的依据就是长度有没有顶到容量,所以三个字段缺一不可。
modSlice 里改的是一号元素,它走的是指针加偏移算地址这条路,头部是复制品,指针是真指针,所以写到了共享的数组上。
1 | sizeof slice header: 24 |
1 | after modSlice: [100 2 3] |
编译器为这一行生成的指令跟函数外写同样一句生成的完全一样,它不知道也不需要知道你站在哪个函数的栈帧里。map 同理,复制的是指向哈希表的指针,channel 同理,复制的是指向同一个 hchan 的指针。string 稍微特殊,16 字节复制过去以后两个头部指向同一段不可变的字节序列,所以传 string 的代价很小,不用复制内容,但也正因为不可变,你没法通过它改到任何东西。
到这里我已经能解释一半的现象了。剩下那一半(也就是 append 为什么改不到外面),得换个角度。
append 改的是头部,不是数组
append 这个函数做的事情分两条路。如果原来的容量还够,它把新元素写到底层数组的下一个位置,然后返回一个新的头部,长度加一,指针不变。如果容量不够,它分配一块更大的数组,把老数据拷过去,追加新元素,返回一个新的头部,指针变了。
两条路的共同点是返回新头部,append 从来不就地改它拿到的那个头部,只改头部指向的内存,再把新的三个数字交回给你。两条路都返回一个新头部。
那条扩容的路值得单独看一眼,因为它不是每次加一格。我实测过从零开始一个一个 append,容量序列是这样的:前八次是干脆的翻倍,从 512 之后变成了一点二五倍左右的渐近增长,因为那时候块已经够大,再翻倍就浪费了。
1 | 4 8 16 32 64 128 256 512 848 1280 1792 2560 3408 5120 7168 9216 |
这解释了另一件事,两个容量看起来一样的切片,append 之后一个重新分配了一个没重新分配,跑起来的开销可能差几十倍,因为一个是写一格,一个是拷一整个数组。s2 的长度没变,返回的 out 长度是 4。原因很直接,append 返回的是一个新头部,appSlice 里把这个新头部赋给了形参 s,形参是复制品,赋值只影响复制品,函数一返回它就没了。
1 | after appSlice: s2 = [1 2 3] out = [1 2 3 9] |
所以切片是引用类型这句话错在哪,错在它让人以为切片本身是一个引用。切片不是引用,它是一个含指针的结构体值,跟那个三字段的 SliceHeader 定义完全等价,传参复制这个结构体,append 返回一个新的结构体,都是值语义。
真正共享的只有指针指向的那块内存。这个词从 Java 和 C# 借过来,只借了结论,没借结论成立的前提,到了 Go 这边就成了一个半真的说法。这个理解一到位,很多原来觉得邪门的事情就都有解释了。比如两次 append 为什么会互相覆盖,我拿一个长度 2 容量 4 的切片做底,一次追加 1,一次追加 2,打印出来两个都是最后那个 2,第一个 1 不见了。原因还是那两条路,容量够,两次都走写到底层数组下一个位置这条,写的是同一个位置,后一次的 22 覆盖了前一次的 11,两个头部的指针相同长度相同,打印出来自然一样。
这种事在测试里几乎抓不到,因为两次写之间只要夹进任何一次超过容量的生长,两个头部就会指向不同的数组。
反过来也一样,如果我把那个底的容量从 4 改成 10,两次追加照样互相覆盖,因为容量够不够只看有没有顶到上界。
这个实验我做了一组不同的容量,从 2 一直到 16,结论只有一个,只要能装下,就覆盖。真正决定结果的是容量余量,而容量余量在代码里是看不见的,你得把脑子里的头部画出来才想得到。
这不是 bug,底层数组就那一份。
1 | b1: [0 0 22] b2: [0 0 22] |
你在两个地方对同一个底做 append,只要容量够,它们就抢同一格。
我在一个循环里拼过这种东西,把结果攒到一个切片里,每次 append 都从同一个长度为 0 的底出发,最后所有行都指向同一份数据,那个 bug 我找了整整一个下午,最后是靠打印每一行的地址才看出来的。
修法很土,就是把 append 的返回值接回去,或者干脆一开始就把容量给足。调完 append 原切片有时跟着变有时不变,差在哪?
三索引切片切断的是什么
full[1:3:3] 里的第三个数字是容量上界,它把新切片的容量钉死成 3 减去 1,也就是 2。这个数字让新切片没有多余容量,任何一次 append 都得重新分配。第一组是两索引切片,容量是 5,append 之后那个 777 直接写进了 full 的第四个位置,外面看得见。
三索引切片是少数能切断共享的写法。
1 | append 后 part: [2 3 777] full: [1 2 3 777 5 6] len/cap: 3 5 |
1 | append 后 part: [2 3 888] full: [1 2 3 4 5 6] len/cap: 3 4 |
第二组是三索引切片,容量只有 2,append 触发重新分配,888 写进了新数组,full 一点没变。
第三个数只影响 append 能不能长,不影响读写的边界在哪里。
这两行的对比就是三索引切片存在的全部理由,它让你在传一个切片给下游时,明确告诉下游你只能读写这几格,别想往后长。
要注意它切断的只是往后长这条路,改元素还是共享的,因为写元素走的是指针加偏移,跟容量没关系。
1 | 改 p3[0] 后 full: [1 200 3 4 5 6] |
数组、结构体、字符串
这三个类型是把值传递看得最清楚的地方,因为它们里没有指针,复制就是老老实实的复制。数组传进去改不动,结构体传进去也改不动,加个星号就改得动。这三行我在学 Go 的第一天就看过,当时觉得太显然,后来才发现代价差异比我想的大得多。一个含一千个 int 的结构体,传参要复制 8000 字节,这个复制是编译器插的内存搬运,一百次调用就是八百 KB,而且它是在栈上搬,压力不大但也不是免费。
所以传大结构体一律用指针(这条规矩不是风格问题),是实打实的成本问题。
我量过一个含一千个 int 的结构体,Sizeof 打出来 8000,跟手算一模一样,那一刻我才真切地感觉到值传递这三个字有多实在。
栈上搬八千字节当然不至于让程序卡住,但一个每秒被调几十万次的函数,把这些搬运加起来就是一秒钟几百兆的带宽,它不会出现在任何一份性能报告里,只会让整个服务比别人慢一截,然后你在别处找原因找了三天。数组更极端,因为数组的长度是类型的一部分,一百万长度的 int 数组传一次就是 8 MB。这也是为什么标准库里的哈希函数收的是切片或者数组的指针,很少见到直接收一个大数组的。我见过有人把三十二字节的数组当哈希值传,比一个切片头部还小,但换成一千零二十四字节就是另一回事了,尤其在每帧都要调一次的循环里。字符串是另一回事,它是 16 字节的头部指向不可变的字节,复制头部很便宜,不可变性让共享变得安全,你不用怕某个函数悄悄改了你传进去的字符串内容。
1 | after modArray: [1 2 3] |
这个设计换来的是转换成本,字节切片和字符串互相转换都要复制,我拿 1 MB 来回转了两千次,转成字节切片用了 105.67 毫秒,转回来 104.66 毫秒,这还只是转换本身,没算中间用掉的内存。所以传字符串放心传,传字节切片之后要转字符串,就得想着这一下是有代价的。
三种改不回来的情况
我把改不回来总结成三种,每一种我都真的踩过。第一种是 append 的结果没接住,赋给了局部变量或形参,外面看不到,新头部只活在函数里。第二种是 map 整个重新赋值,那改的是 8 字节的指针,不是它指向的表。第三种是重排切片时以为返回新切片外面就不受影响,其实交换元素走的是共享数组。第一行的 inner 打印出了长度 4,外面还是长度 3。同时注意那个 42 是前面改元素改的,那次改动生效了,因为它走的是共享数组这条路。同一个函数里,改元素生效了,append 没生效,这两件事同时成立,这就是值语义最容易搞混的地方,也是我在开头那个字节流工具里栽跟头的地方。两行输出一模一样,第一次加了一个键,第二次试图换一张表,结果什么都没发生。这条踩的时候我还疑惑,因为 map 被反复说成引用类型,我下意识以为赋值过去就是换引用。
第三种最容易骗人,一看返回值就觉得是新东西。
比如一个反转切片的函数,里面交换元素,最后把切片返回,外面早就改了,返回值是多余的。
但很多人写时会下意识觉得返回了新切片所以外面不受影响,这个联想是错的,返回的是同一个头部。标准库里的 sort.Slice 就是靠这一点工作的,它不返回任何东西,你也知道它排好了。
我把那个反转函数改成原地操作,返回值删了,调用方没改一行。
1 | inner: [42 2 3 9] |
1 | after modMap: map[a:1 k:1] |
引用类型这个词该不该用
Go 的官方规范不用这个词,那里只有值、指针,以及含指针的类型。这个词是从别的语言借来的,借过来的时候把语义也带歪了。我现在的说法是,Go 里没有引用类型,只有含指针的类型,切片含指针,map 含指针,channel 含指针,函数值含指针,接口含两个指针,字符串含指针但指的是一段不可变内容,所以它看起来像值。
值传递只复制头部,啰嗦但准。
精确在它能直接回答你要不要担心共享。你看到一个参数的类型,如果它里面没有指针,那就一定不会共享,改不到外面,也不用担心并发。
引用类型这个词传得比机制快。
如果它里面有指针,那就得看一眼那个指针指向的东西是不是可变的,切片和 map 是,字符串不是,接口要看里面装的是什么。
这张表比记哪些是引用类型有用,它给的是复制了多大一块这个信息,而复制多大才是所有现象的总源头。
这三个数字拿尺子量出来的,量完才明白那列写的是复制了多大一块
| 类型 | 复制的是什么 | 能改到外面吗 | 什么情况改不到 |
|---|---|---|---|
| 数值 | 值本身 | 不能 | 永远 |
| 数组 | 全部元素 | 不能 | 永远 |
| 结构体 | 全部字段 | 不能 | 永远 |
| 指针 | 地址 | 能,改指向的内容 | 改指针本身 |
| 切片 | 指针加长度加容量 | 能,改元素 | append 后不接返回值 |
| map | 指针 | 能,增删改 | 整个重新赋值 |
| channel | 指针 | 能,收发 | 整个重新赋值 |
| 函数 | 指针 | 不适用 | 不适用 |
| 字符串 | 指针加长度 | 不能 | 永远,内容不可变 |
| 接口 | 两个指针 | 能,改指向的值 | 整个重新赋值 |
一句提醒
写这篇的时候我把所有实验又跑了一轮,其中有一个结果让我愣了一下。这一行是赋值之后比较两个切片的指针字段,它们相同。我本来以为赋值会复制数组,跑完才想起来复制的就是那 24 字节,指针原封不动地过去了。这个复制概念上很清楚,直觉上却容易被切片是个容器这个想法带偏。容器这个词暗示里面装着东西,而我手上这个变量只是地址加一个范围,把它当容器看,就会以为复制变量等于复制内容。容器这个比喻害了我很久。
所以我现在看代码的方式是,遇到一个参数,先问这两个问题,它复制了多少字节,它里面有没有指针。
答案决定了我能不能在这个函数里改到调用方,也决定了这个函数贵不贵。
这两个问题比问是不是引用好回答得多,也更接近编译器实际干的事。前者查一张尺寸表就有答案,后者要靠理解,而理解隔半年不看就会褪色。我把这条记在笔记本第一页。
1 | copy header points to same data: true |