装包顺序是怎么排出来的
装包顺序是怎么排出来的
隔壁老康难度 ★★★★☆ · 前置:图的遍历:递归不溢出,是因为栈藏起来了 | 一句话结论:拓扑排序是 BFS 的一个特例,入度表就是那个队列的来源;顺便它还免费送了一个环检测。
敲完一行 pip install,终端刷出来的头几行经常不是你要的那个包。它先装 typing-extensions,再装 numpy,然后才轮到正主。你盯着那串滚动的名字,多半不觉得稀奇,装包工具又不傻,谁依赖谁它当然清楚。可真要追问一句它凭什么这么排,回答往往就卡住了。知道谁依赖谁,跟知道先装哪个,中间还隔着一步。
那一步叫拓扑排序。
依赖描述的是关系,安装要的是顺序。关系允许并列:A 和 B 谁也不欠谁,先干哪个都行。顺序不允许并列:终端只能一行一行往下打,两个包没法同时占住同一行。把允许并列的关系拉成不允许并列的队列,学名是把偏序补成全序。拓扑排序干的就是这件事,输入一张有向图,输出一个线性序列,序列里每一条边都朝前指。
一张图里没有时间
时间这条轴是画上去的。
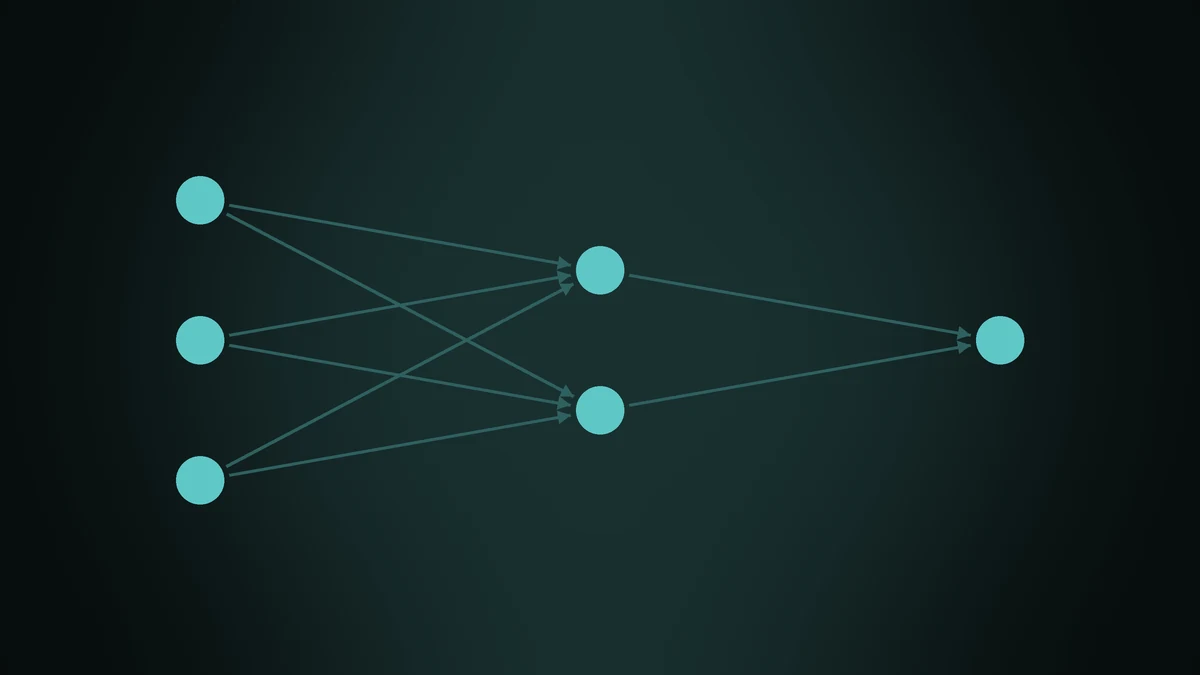
把每个包画成一个点,把“我依赖它”画成一条带箭头的边,你得到的是一张网。这张网本身不提供任何执行顺序,它只提供局部约束:从 A 指向 B 的那条边,只管这两个点的先后,对第三个点 C 完全沉默。局部约束攒得再多,也凑不出一条从头到尾的线。两条边在图上画得一样长,那是画图软件的审美,跟先后毫无关系。
决定先后的只有边。
补成全序的办法不唯一,这一点得先接受。同一时刻可能有三个点的入度都是零,先动谁都合法,于是输出通常不是唯一的。算法给出的是众多合法序列里的一条,而不是那条唯一的正确答案。工程上这个性质很好用:所有合法顺序里随便挑,挑最省事的那个,比如让体积小的包先下、让本地缓存里已经有的先装,只要不违背任何一条边,结果照样成立。
入度:每个点还欠几个前置
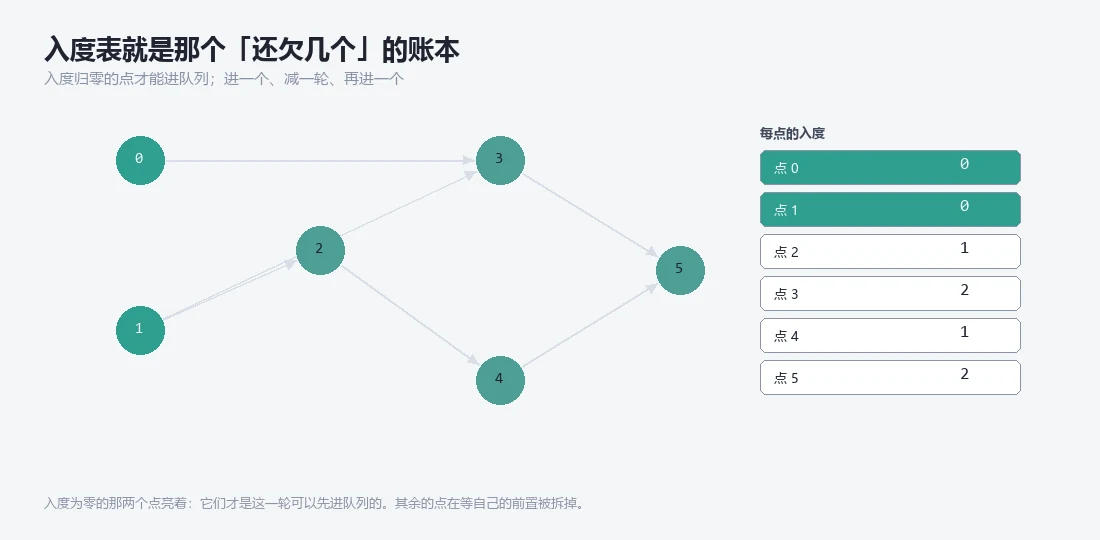
判断一个包现在能不能装,只需要回答一个问题:它还有几个前置没到位。这个问题的答案是个计数,叫入度,指的是指向该点的边的条数,也就是它的前置数量。所有入度为零的点,构成此刻可以立刻动手的那一批。装完其中一个,把它发出的边全部删掉,被指向的那些点各减一,然后重新看谁归了零。
每轮只做一次自减。
这个动作看着寒酸,却是整台机器的推进力。没有比对,没有回溯,没有试探性假设,只做一次自减,然后看结果是不是零。归零的被收进待办,没归零的继续等。整趟流程由上百万次这样的自减堆出来,没有一步需要回头看,也不存在“这一步走错了要不要退”的问题。
入度表就是那本账。
它把图里跟当前决策相关的部分单独抽了出来,抽成一张整数数组。点不需要记住自己的前置是谁,也不需要知道自己被谁依赖,遍历时连边都不用回头翻。边的分布、环的形状、路径的长短,在这个阶段全被丢掉。丢得掉是因为算得清:入度归零等价于它的全部前置都已经出队,这个等价关系在算法里是精确的,不需要任何额外校验。既然如此,一张数组足够撑起整个流程,多存一个字节都是浪费。
两个动作,一个循环
做法短得不像话。
1 | func topoSort(n int, adj [][]int) ([]int, bool) { |
第一段扫一遍所有边,把每个点的入度数出来。这一步没有捷径,任何一条边都得被数一次,O(V+E) 里那个 E 就是从这儿来的。第二段扫的是点而不是边,把零入度的点一次性收进队列,有些实现会把它并进第一段,效果相同,只是分开写更好读。第三段是主循环,也是唯一容易看错的地方。
循环变量只增不减。
出队这个动作被化简成了一个下标自增,数组当成一根不断往前长的游标在用。好处是不用实现真正的队列,也不会因为反复切掉切片头部而产生搬移。每个点恰好入队一次,每条边恰好被访问一次,两个恰好叠起来,复杂度就是 O(V+E)。
它就是个 BFS。
区别只在于是什么把点放进队列。普通 BFS 靠访问标记,谁没看过就放谁进去;拓扑排序靠入度归零,谁没人拦着就放谁进去。前者在扩散,后者在拆解,骨架是同一副:一个数组,一个只增不减的下标,一轮一轮把待办吃掉。
那个 make 到底值不值
那行 make 值得单拎出来。
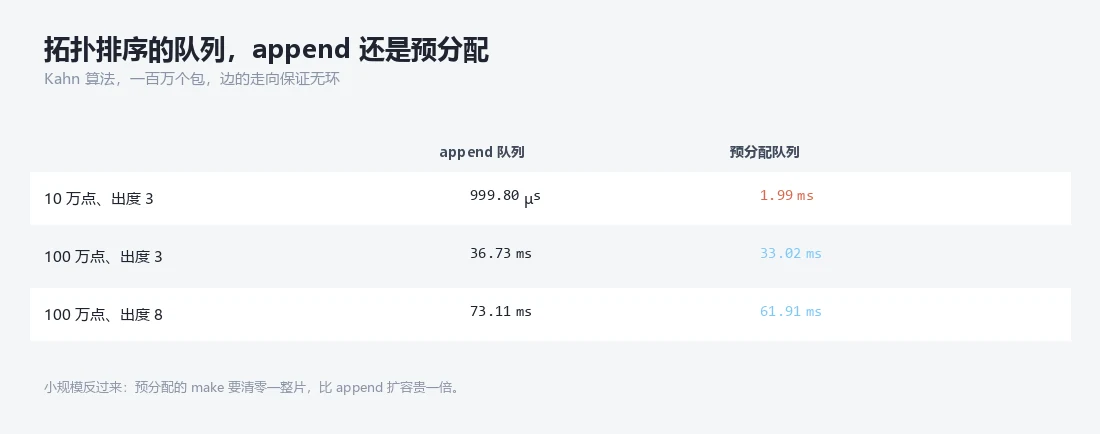
queue := make([]int, 0, n) 提前买断 n 个整数的额度,长度留零,随后用 append 往里塞。看着像性能优化,跑起来未必。
先摆一组实测数。
| 规模 | append 队列 | 预分配队列 | 比值 |
|---|---|---|---|
| 10 万点、出度 3 | 999.80 µs | 1.99 ms | append 快一倍 |
| 100 万点、出度 3 | 36.73 ms | 33.02 ms | 预分配快 1.11 倍 |
| 100 万点、出度 8 | 73.11 ms | 61.91 ms | 预分配快 1.18 倍 |
十万点那一行最反直觉。预分配是一次性买断:make 分配并清零 n 个整数,十万个是 800 KB,这 800 KB 得实打实写一遍零,才轮得到 append 往里填。大块内存还可能向操作系统要新页,第一次触碰触发缺页中断,这笔账在计时器上不单独列出来,但它确实要花时间。append 走的是另一条路,容量不够时按增长因子重新分配并拷贝,前几轮拷的数据极少,越往后越贵,总拷贝量是几何级数求和。把这两笔账摆在一起:预分配一次付清 800 KB 的清零,append 分期付款,前几期几乎不要钱,后面几期金额翻倍但总量收敛到最终容量的常数倍。十万点这个规模,首付那 800 KB 比 append 全程的累计拷贝更贵,预分配慢了将近一倍。
清零是要付费的。
一百万点,局势翻转。
预分配要清的零涨到 8 MB,append 这一路搬过的数据、反复申请又丢弃的内存块、扩容瞬间新旧两片同时存在造成的缓存压力,加起来压过了清零那笔开销,预分配开始领先 1.11 倍。出度八条那一行差到 1.18 倍,原因不在队列本身,在算法耗时的占比:边多了,主循环里对每条边的自减把总时间抬高,队列这点开销被摊薄,绝对差距没变多少,相对差距反而变大。
别拿这个比值去重构。
微基准里两版差一到十几毫秒,看规模:十万点那组差不到一毫秒,一百万点、出度 8 那组是 73.11 对 61.91,差 11 毫秒。换到真实负载里可能只占几个百分点。容量优化没有普适答案,它依赖规模,依赖元素的增长速度,也依赖运行时对清零和拷贝各自的定价。十万点以下直接 append,代码干净,读者也不用去想容量;预估规模稳定上百万,把 n 写进 make 才有回报。中间那一段最尴尬,只能量。order 那个切片同理,它在循环里从头长到尾,最终长度恰好是 n,预分配的收益比 queue 更早出现。
排不满的点就是环
排不满的点,就是环上的点。
一张有向图,如果每个点都被排进输出,说明每一次取零入度的动作都成功了,没有任何点陷入“前置永远装不完”的死局。反过来,如果跑完输出长度小于 n,就一定有某个点从头到尾没进过队列。这些没进队列的点,入度从来没有归零过。把已经排出的点整个删掉,剩下的子图里每个点的入度都至少是一,指向它们的边一条不剩,全通向了已经排出的那些点。
一个环就藏在这儿。
一个有限的有向图,如果每个点都至少有一条入边,从任意一点沿入边反向走,走过的点有限而步数无限,必然踩到重复的点,那就是环。所以判环不需要任何额外的代码,len(order) == n 为真就是无环,为假就是有环。环检测在 Kahn 里是副产品,你不会为了它多扫一遍图,也不会为了它多分配一个数组。
这笔代价是零。
三色 DFS 那条路
另一条路是三色 DFS:白点未访问,灰点在当前递归栈里,黑点已完成。顺着边走,撞到灰点,说明回到了自己脚下。它同样正确,同样 O(V+E),同样只需要一趟遍历。一百万个包、出度三条:三千个节点连成环时,Kahn 返回“有环”,三色 DFS 也返回“有环”;不造环时两边都返回“无环”;在环上摘掉一条边之后,两边都返回“无环”。
工程里仍然少见 DFS。
原因不在正确性。它要三个状态数组,要一层递归,图的形状能把递归深度顶到几万层,还得自己维护栈或者改成显式栈,改完那套染色逻辑不比 Kahn 短。更要紧的是交付方式:装包工具往往排到一半就开始下载,边定顺序边干活,Kahn 天然流式,出队一个立刻派活,DFS 得先钻到底再回头,中间很难交出半成品。
Kahn 还白送一个名单。
排不出来的点原样留在数组里,入度非零,直接就是环上或者被环卡住的集合,报错时能指出具体是哪个包参与了循环依赖。DFS 想在报错信息里给出同样的东西,得再扫一遍颜色数组,把灰点一个个收集起来。
顺序只是约束的一个解
把网压成线,是有损的。
回到那串滚动的终端输出。它看起来理所当然,是因为有一台机器把网压成了线,还顺手证明了这张网没有缠死。被压掉的信息很多:哪些包可以并行、哪条依赖链最长、某个包被几个地方同时依赖,这些在入度表里都被抹平了。抹平不等于丢失,需要的时候能单独算回来。入度表只保证一件事,出来的顺序里每一条边都朝前指。这条性质够了,装包工具可以一格一格往下干。