最短路:同一个名字的两种写法,一对一错
最短路:同一个名字的两种写法,一对一错
隔壁老康难度 ★★★★☆ · 前置:堆为什么只排一半序就够了 | 一句话结论:Dijkstra 在负权图上不一定会报错,它可能给你一个看起来正常的错答案;而错不错,取决于你用哪种写法去重。
从一张送货单说起
城市配送的调度台上,一张单子往往挂着几十个收货点。仓库到每个点的里程不一样,路口有单行道,有些桥限高,绕行会让同一条路的两个方向长度对不上。系统要回答的问题很具体:从仓库出发,到每一个点各自最短要跑多少公里。把路口看成点,把路段看成带权的边,里程就是边权,这张有向图上的一次单源最短路,决定了后面所有承诺时间。看起来只是算几行数字,落到工程里却会牵出三个分叉:图有多大,边权长什么样,以及你用的是哪一种 Dijkstra。前两个分叉决定跑得快不快,第三个分叉决定答案对不对。很多人把第三个分叉直接跳过了。
路网是稀疏图。
每个路口平均只连出去四五条路。
十万个点,四十万条边,这个比例很常见。
每轮扫一遍,代价是 V 的平方
朴素 Dijkstra 的流程只有四步。把源点的距离设成 0,其余点设成无穷大;每一轮,在还没定下来的点里挑距离最小的那个;把它标记成已定;用它所有的出边去更新邻居的距离。重复 V 轮,所有点的最短距离就都确定了。这个描述里没有任何堆,也没有任何复杂数据结构,一个数组就够。挑最小那一步,最直白的做法是把 dist 数组从头到尾扫一遍。V 个点,每轮扫 V 次,光这一件事就是 V²。松弛边另算,每条边最多被看一次,加起来是 E。总复杂度 O(V²+E)。注意,这个复杂度里 E 是一次项,边再多,也压不过 V²。
每轮都要重扫。
扫过的绝大多数点,这一轮根本不会更新。
可扫描不看这个。
稠密图上,O(V²) 反而不算浪费。
堆换掉的是找最小那一步
堆优化的改动只有一处:把每轮扫描 dist 数组找最小值,换成从优先队列里弹出一个。剩下的流程原封不动。每个点第一次被更新时,把它的距离和编号压进堆;之后如果又找到更短的路径,再压一次。堆顶始终是当前距离最小的候选。弹出的时候,如果这个距离已经比 dist 里记录的大,说明它是旧版本,直接丢掉。这种写法叫惰性删除。它不修改堆里的旧元素,而是允许同一个点存在多份记录,用 dist 数组来判断哪一份还有效。省掉的是 decrease-key 的复杂度,代价是堆里可能多出一些废记录。对大多数图,这笔买卖划算。复杂度从 O(V²+E) 变成 O((V+E) log V)。
差的是数量级,不是常数。每条边最多入堆一次,每次弹出和压入都是 log 级别;点被弹出的次数不会超过边数,因为每一条入堆记录都对应一次成功的松弛。把这两部分合起来,就是 O((V+E) log V)。和朴素实现的 O(V²+E) 相比,差别不在字母,而在 V 和 E 谁增长得更快。稀疏图里 E 是 V 的几倍,堆的代价大约是几倍 V log V;朴素是 V²。V 越大,差距越明显。第四节的表格展示的就是这件事:堆的优势不在写得巧,而在它避开了一个不该做的全表扫描。常数另说,堆的每次操作都有函数调用和分支,数组扫描却是连续内存,所以在很小的图上,朴素写法经常反超。
惰性删除的骨架是这样。
1 | while pq: |
注意,这里没有 done 数组。
规模上去之后,差的是数量级
先交代测试条件。
随机生成的有向图,边权在 1 到 100 之间均匀取整,平均出度控制在 4 到 5。两种实现读同一份图,跑同一个源点,输出 dist 数组之后逐点比对。机器是同一台,编译选项相同,计时只算最短路本体,不算建图。每一组规模跑多次取稳定值,表里保留两位小数。朴素实现用邻接表加线性扫描,堆实现用二叉堆加惰性删除,都不做特殊的缓存优化。这样比出来的倍数,才接近把代码改成堆之后能拿到的收益。下面五组数据,规模从一万点爬到十万点。倍数那一列,是朴素时间除以堆时间。
先看前两行,都是十万以内的规模。
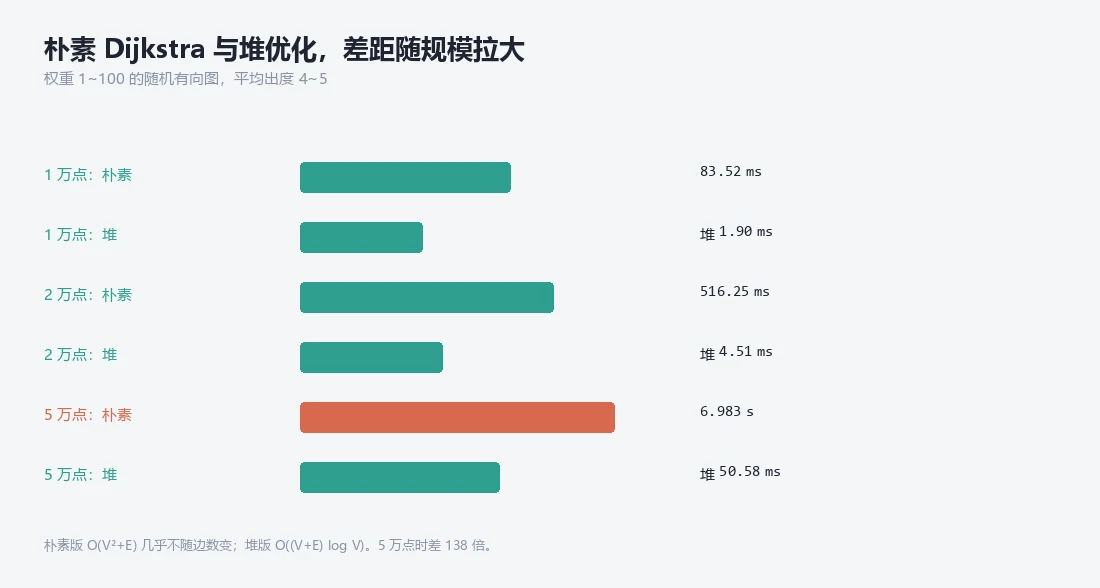
一万点、四万条边这行,朴素 83.52 毫秒,堆 1.90 毫秒,差 43.9 倍。出度翻到 8,边数变成 79 997,朴素还是 80.30 毫秒,堆涨到 2.46 毫秒,倍数回落到 32.7。朴素几乎不动,它花在 V² 的扫描上;堆要多处理四万条边,时间自然往上走。倍数不单调,取决于这一轮增长里 V² 和 E log V 谁占上风。
| 规模 | 边数 | 朴素 | 堆 | 倍数 |
|---|---|---|---|---|
| 1 万点、出度 4 | 39 999 | 83.52 ms | 1.90 ms | 43.9 倍 |
| 1 万点、出度 8 | 79 997 | 80.30 ms | 2.46 ms | 32.7 倍 |
| 2 万点、出度 5 | 99 994 | 516.25 ms | 4.51 ms | 114.6 倍 |
| 5 万点、出度 5 | 249 994 | 6.983 秒 | 50.58 ms | 138.1 倍 |
| 10 万点、出度 4 | 399 998 | 跑不完(放弃了) | 27.88 ms | — |
五万点、二十五万条边,朴素要 6.983 秒,堆只要 50.58 毫秒,138.1 倍。到了十万点、四十万条边,朴素实现已经跑不完,表里只能写放弃;堆实现 27.88 毫秒交卷。为什么十万点的堆反而比五万点快?因为两组的出度不同,五万点那组平均出度是 5,十万点那组是 4,边数只从 249 994 涨到 399 998。堆的时间受边数影响更大,受点数影响小。单看点数选实现,容易判断失误。
所有组的 dist 数组逐点相同。
朴素 O(V²+E),堆 O((V+E) log V)。
负权:两个反例,三种写法,一对一错
教科书上有一句话。
这句话说,Dijkstra 不能处理负权边。它是对的,但它把问题简化了。不能处理,听起来像会报错、会断言失败、会抛异常。实际跑起来,它往往什么都不说,照常返回一个 dist 数组,数组里的数字看起来也很正常。更麻烦的是,错不错不取决于算法名字,而取决于你用的是哪一种写法。同一张负权图,堆加惰性删除可能碰巧给出正确答案,带 done 集的标准写法却会静默地给出错答案。这两段代码在非负图上等价,在负权图上分道扬镳。反例的规模很小,小到可以手算,但足够把两种写法的分歧暴露出来。边权、出边、松弛顺序,全部列清楚。
四个点,五条边。
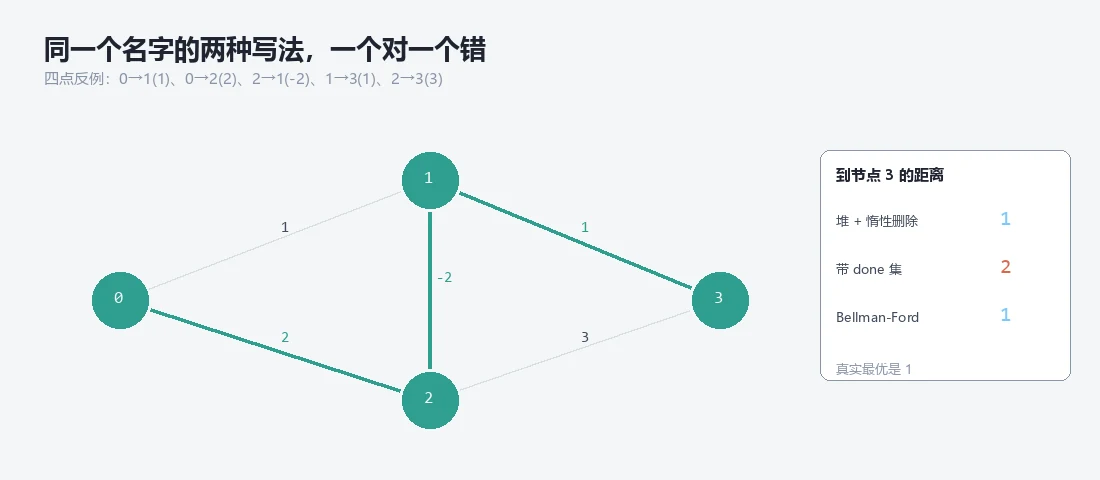
0→1 权 1,0→2 权 2,2→1 权 -2,1→3 权 1,2→3 权 3。源点是 0,问的是到 3 的最短距离。
先手算一遍。
从 0 出发,到 1 是 1,到 2 是 2。走 2→1,可以把到 1 的距离压到 0;再用 1→3,到 3 就是 1。另一条路 2→3 直接给 3,距离是 5。所以真实最优是 1。这个结果没有任何争议,Bellman-Ford 跑出来也是 1。问题在于,Dijkstra 的两种写法,一种给出 1,一种给出 2。给出 2 的那种,dist 数组是 [0 0 2 2];给出 1 的那种,是 [0 0 2 1]。两个数组只差末尾一位,前面的距离完全一样。静默错误就是这个样子:不抛异常,不越界,只是末尾多了 1。如果这个距离被用来算油费、承诺送达时间,或者给骑手排班,多出来的 1 会一路传下去。
三种实现的对照在这。
| 实现 | dist 数组 | 到 3 的距离 |
|---|---|---|
| 堆 + 惰性删除(不设 done) | [0 0 2 1] | 1(碰巧对) |
| 带 done 集的标准写法 | [0 0 2 2] | 2(错) |
| Bellman-Ford | [0 0 2 1] | 1 |
堆加惰性删除给出 1,带 done 集的标准写法给出 2,Bellman-Ford 给出 1。为什么前两种会分叉?节点 1 先以距离 1 出队,被标记成已完成。之后节点 2 以距离 2 出队,用 2→1 这条负权边把 dist[1] 更新成 0,再把 0 压进堆。可当 0 这一版弹出时,done[1] 已经是 true,代码直接跳过,1 不会再展开它的出边。1→3 这条边于是没有被用到,dist[3] 停在 2。惰性删除没有 done 这道闸,0 这一版会被正常展开,所以它能拿到 1。这不是它更聪明,只是它没有提前把门关上。如果图再大一点,这种差别会被淹没在几百个正常数字里,肉眼几乎不可能发现。
事情还有另一面。
换一组五点反例:0→1 权 2,0→2 权 5,1→2 权 -4,2→3 权 1,3→4 权 1。三种实现都给出 [0 2 -2 -1 0],谁都没错。负权边 1→2 确实存在,为什么 done 集没有翻车?因为节点 1 先被定下来,距离是 2;节点 2 后定,距离被压到 -2。负权边从先定的点指向后定的点,方向是顺的。2 拿到更小的距离之后,不需要回头改 1,也就不需要重新展开 1。失败的条件比有负权边更窄:一条负权边,从后定的点指回先定的点,并且真的把先定点的距离改小了。缺一个条件,done 集都可能安然无恙。所以不能简单地说,有负权就一定错——错的是顺序,不是负权本身。
一个节点被过早定下来
done 集的含义很明确。
一个点从堆里弹出时,算法宣称它的距离已经是最终值,以后不会再变小。这个断言在非负权图上成立:所有边权都不小于 0,任何绕路都只会让距离变大,所以当前最小的候选不可能被后来的路径推翻。代码把这条断言写成了一个布尔数组,弹出时置 true,之后不再处理。断言本身没有错,错的是它在负权图上依然被当成真理。负权边让绕路有可能更便宜,当前最小就不再安全。一个已经出队的点,完全可能被后面的点用一条负权边重新拉低。这时候 done 集不会报错,它只是让这个点失去第二次展开的机会。
问题就出在弹出之后。
1 | while pq: |
把四点反例代进去。0 弹出,1 和 2 入堆。1 以距离 1 弹出,done[1] 置 true,3 被更新成 2。2 以距离 2 弹出,done[2] 置 true,2→1 把 dist[1] 改成 0,并把 (0,1) 压进堆。接着 (0,1) 弹出,done[1] 已经是 true,continue。1 的出边不会再被看一遍,dist[3] 保持 2。整个过程中没有任何异常,数组长度正确,下标正确,只有那个 2 是错的。单看 dist 数组很难发现,因为除了末尾一位,其他数字都符合直觉。
标记本身没有错。
错在标记得太早。
如果边权非负,这个标记是安全的,因为不会再有更短的路出现。负权边打破了这个前提,done 集却还在按老前提工作。工程里的危险往往不在明显的崩溃,而在这种前提失效之后仍然返回结果的代码。它不吵不闹,测试也可能过,因为大多数随机图没有负权边,或者负权边的方向恰好是顺的。要抓到它,得专门构造反例,或者换一个不会提前下结论的算法。Bellman-Ford 不设 done,它把每条边反复松弛 V-1 轮,直到没有更新为止。慢,但它不替图做假设。
边权全是 1,优先队列是白花的钱
边权全为 1 时,图退化了。
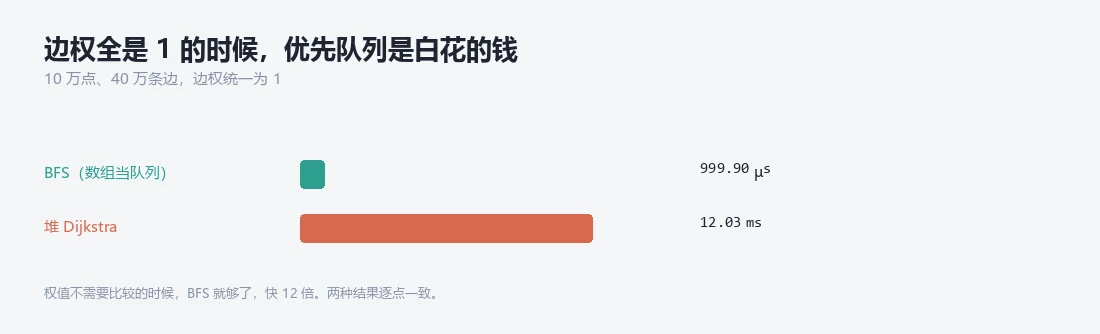
所有边的代价相同,最短路就是最少走几步。BFS 从源点一圈一圈往外扩,先到的一定步数更少。队列的先进先出,天然对应距离的层次:第一层全部处理完,才轮到第二层。每个点只入队一次,每条边只看一次,复杂度 O(V+E)。这里没有堆,没有 log,也没有任何排序。优先队列维护的顺序,BFS 用一层一层推进就免费拿到了。十万点、四十万边的图上,BFS 跑 999.90 微秒,堆 Dijkstra 跑 12.03 毫秒,差 12 倍,结果逐点一致。差的不只是 log,还有堆的分配、压入、弹出和缓存不友好。边权全为 1 时,这些开销全是白花的。
BFS 快 12 倍。
这不是微观优化,是选错了工具。
0 和 1 两种权值也有对应写法:双端队列,0 走队头,1 走队尾。权值是小的非负整数,还可以用桶。
三条线:BFS、堆 Dijkstra、Bellman-Ford
把选择压成三条线。
边权全为 1,或者所有边权相同,用 BFS。边权非负且图很大、很稀疏,用堆 Dijkstra;点数很小、边数接近平方,数组版 Dijkstra 可能更稳。边权可能为负,用 Bellman-Ford,或者先做一次 Johnson 重标号把负权消掉。三条线之外还有两个旁支:图是 DAG 时,按拓扑序做一遍 DP,O(V+E),负权也能处理;只求单点到单点、且有可采纳的启发函数时,A* 能少扩一些点。选错的代价不一样。BFS 用在带权图上会得到错答案,堆 Dijkstra 用在负权图上可能静默出错,Bellman-Ford 用在小图上只是慢一点。先确认边权,再确认规模,末尾才看常数。
顺序不能反:边权决定正确性,规模决定速度。代码审查时先找 done 集,有 done 集就问一句,边权保证非负吗?
没写 done 集的那种,判完之后还得再扫一遍,看有没有还在被放松的边,有就说明图上藏着负环,答案整个作废。