第一个测试和第一个基准

第一个测试和第一个基准
隔壁老康难度 ★☆☆☆☆ · 前置:够用的那十几个标准库 | 一句话结论:
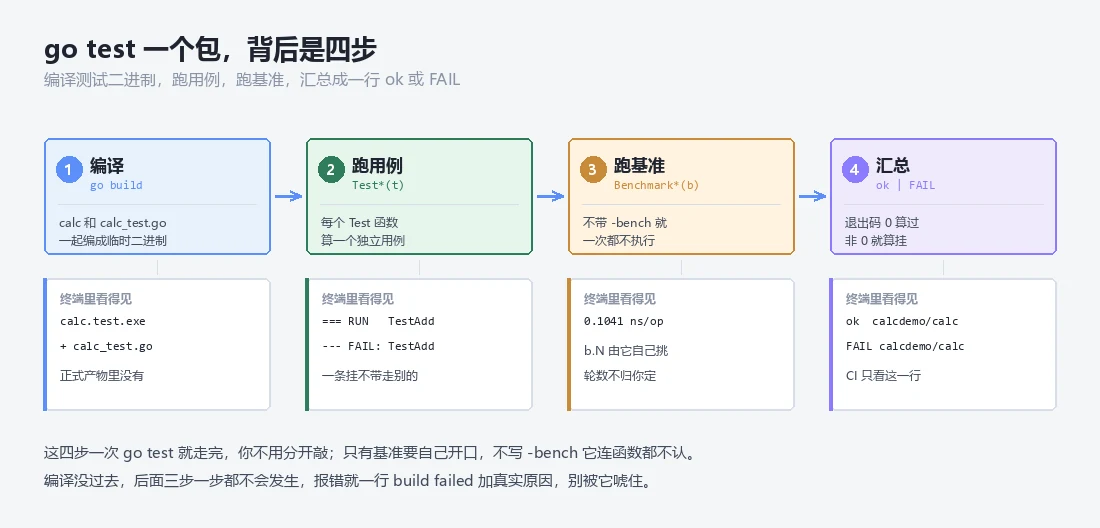
go test做的事是先把你的包编成一个测试用的可执行文件再跑一遍,通过了屏幕上只有一行ok,没通过就给你一行带文件名和行号的失败,那一行指向哪里,取决于你写的是Errorf还是Fatalf。
写测试这件事我拖了很久。不是不会写,是不知道写完该按哪个键,也不知道屏幕上那行 ok 到底是夸我还是敷衍我。calc 这个包是我给自己搭的试验田,里面只有一个函数,两行代码,我拿它当借口,说这么点东西测它干什么。后来有个下午我真把它拆开试了一遍,从写第一个测试开始,一条命令一条命令地跑,每次终端的输出都原样抄下来贴在旁边。抄到天黑我才发现,我原先以为测试就是跑一遍看有没有报错,这跟 go test 实际干的活差得挺远,它比我想的笨,也比我想的诚实。
一句话,它先把东西编出来,再跑。
先有一个能被测的函数
目录我在 _local/golab/h11 下面建的,模块名 calcdemo,一条 go mod init calcdemo 就有了,再在里面建一个子目录 calc,那就是被测的包。目录长这样:
1 | calcdemo/ |
calc.go 里只放一个函数,收两个 int,返回一个 int。注意它写的是 package calc 而不是 package main,它是个库,自己不会产生可执行文件,go run . 到这一层也跑不起来。这一点马上要用到,因为测试文件的第一行也得写 package calc,两个文件得住在同一个包里,测试才看得见 Add 这个名字。
1 | package calc |
被测的东西就这么点,一个加号,但正因为简单,出问题的时候你不用先怀疑它,注意力能全放在测试本身。
第一个测试,三行就够
测试程序写下来只有九行,真正在断言的只有一行。
但文件名和函数名都有硬规定。文件名必须叫 <名字>_test.go,那截 _test 少一个字 go test 连看都不看一眼,不报错也不提示,你以为在跑,实际一条都没执行。函数名也一样,Test 后面那一位得大写,写成 testAdd 框架不认,同样安静地不跑。我在 calc 目录下建 calc_test.go:
1 | package calc |
九行里只有一行在断言,其余都是壳。import "testing" 得写,*testing.T 那个参数也得写,它就是你跟框架说话的那根线,报错、记日志、跳过、标记失败,全从这个参数上出。这个 t 不能自己造一个,只能从参数里接过来,所以断言函数要想复用,就得把 t 一路传下去。
存好文件回到终端,把这条命令敲下去,通过的输出就只有一行:
1 | $ go test ./... |
ok 是通过,中间那截是包的路径,后面那个时间是这个包从起来到收工用了多久,跟你的断言写得深不深没有关系。这一行里没有任何关于数量的信息,跑一条和跑一百条长得一模一样。想知道到底跑了哪几条,得在命令后面加一个 -v:
1 | $ go test -v ./... |
多出来的三行各管一段。=== RUN 是开始跑,--- PASS 是跑完并且过了,后面那个 (0.00s) 只算这个测试函数,不含编译,PASS 是整包的结论。第一次跑会明显慢,因为 testing 这半个标准库得现编一遍,第二次开始才快,快的原因跟你写的代码一点关系都没有。
这一行你以后会见到几千次。
让它红一次
光看绿的不够,你还得知道红了长什么样。我把 Add(2, 3) 改成 Add(2, 2),期望值还留着 5,故意让它算出一个 4 来:
1 | func TestAdd(t *testing.T) { |
再跑一次,屏幕从一行变成五行,多出来的四行每一行都在说不同的事:
1 | $ go test ./... |
这五行值得逐行认。第一行的 --- FAIL 说 TestAdd 挂了,括号里是耗时。第二行缩进四个空格,是失败的正文,格式固定成 文件名:行号: 消息 三段,calc_test.go:8 指的是 t.Errorf 那一行,不是你写错的那个 Add 调用,从文件顶部往下数是第八行,我当初对着这个行号找了三遍才确认它指的是报错那一句而不是出错那一句。第三行那个孤零零的 FAIL 是测试二进制自己的结论,第四行带包名的 FAIL 是 go test 这一层的结论,末尾再加一个,同时进程退出码变成 1,所以你把它放进脚本里跑,挂了就是挂了,不会静悄悄过去。同一个词出现三次,位置不同,说的是三件事,你只要认准第二行那个 文件:行号,剩下几行都是噪音。我刚看这五行的时候以为末尾那个 FAIL 是重复打印,跑去翻了一趟源码才明白,最下面那个是 go test 发现子进程退出码非零之后自己补的。
Errorf 记一笔,Fatalf 掀桌子
一个测试里塞三条断言,差别就露出来了。
我把三种输入喂给同一个函数,前两条用 Errorf,第三条用 Fatalf,末尾再挂一句 t.Log,四条全错:
1 | func TestAdd(t *testing.T) { |
跑出来只有三条,末尾那句 t.Log 不见了:
1 | $ go test -v ./... |
原因在那个 f 上,Fatalf 除了记一笔,还会立刻把当前这个测试函数掐掉,后面的语句一行都不执行,日志因此没有机会打出来。Errorf 不掐,它只记账,记完接着往下走,所以前两条都报了出来。把第三条换成 Errorf,输出会多出 calc_test.go:15 那行日志,正是刚被吞掉的那句。
差别就这么点,但选错了很烦。我的判断标准是后面还用不用得上,第一步就失败、接着跑会 panic 的,用 Fatalf,几条检查彼此独立、一次报完能省一轮改代码的,用 Errorf。还有一个容易踩的地方,Fatalf 放进循环里,第一条错就把整个循环掐了,表驱动里尤其容易犯。
用例排成一列,名字当路径
加到第五个用例,手写的 if 就开始碍事了。
上面每个用例都手写一个 if,加到第五个就得再抄一遍,抄到第八个一定会抄错。表驱动把输入和期望值排成一张表,循环跑:
1 | func TestAdd(t *testing.T) { |
那个匿名结构体是整段的骨架,name 这一列不参与计算,只给 t.Run 当名字。循环体三行,把表里每一行喂给同一段断言,加用例的时候你只动表,不动逻辑,这是它最实在的好处。
-v 跑出来是这样,一次父的五次子的:
1 | $ go test -v ./... |
注意两件事。一是 === RUN 出现五次,一次是父的,四次是子的,子测试的名字由斜杠拼出来,形式是 父/子。二是下面那组 --- PASS 是缩进的,缩进量标层级。这套斜杠路径不是给你看的装饰,-run 就是照它匹配的,所以子测试怎么取名,直接决定你能不能一条命令把它拎出来。只想跑有负数的那一条,把全名抄进去:
1 | $ go test -run TestAdd/负数 -v ./... |
父测试还是跑了一遍,因为它得先把子测试登记出来,再按名字筛,所以 === RUN TestAdd 一定出现,被筛掉的三个连 === RUN 都不会打。-run 后面跟的是正则不是精确匹配,写 TestAdd/负 一样能选中它,我试过,输出跟上面一字不差。名字起得好不好,全绿的时候一点区别都看不出来,只有红的那一次才开始算账,叫 case2 的挂了,你得回源码里数它排第几,叫 有零 的那个挂了,报错里那半截本身就是一句话。
名字是你留给半年后的自己的线索。
t.Helper 把行号还给调用者
表里那四个用例,断言还能再抽出去变成一个函数,这样将来加 Subtract 也能共用,抽完是这样:
1 | func checkAdd(t *testing.T, a, b, want int) { |
第三条我故意写错,期望 8 而实际只能算出 7,跑出来的报错指向 calc_test.go:7:
1 | $ go test -v ./... |
行号 7 是 t.Errorf 所在的行,在 checkAdd 的函数体里面。这条信息告诉你断言在这个位置炸了,但它没告诉你哪一行调用喂错了数据,真实项目里 checkAdd 可能在文件另一头,中间隔着两百行,你得自己顺着往上找是谁调的它,我在这上面浪费过一整个下午,一度以为是自己表里的数据写错了。更烦的是调用点一多,同一条消息会重复出现好几遍,光看行号根本分不清是第三行喂错了还是第五行喂错了。在 checkAdd 第一行加一句 t.Helper(),别的什么都不改,再跑一次:
1 | $ go test -v ./... |
行号从 7 变成 15,而 15 正好是 checkAdd(t, 0, 7, 8) 那一行,也就是真正喂错数据的地方。t.Helper() 这个调用本身什么也不做,它只是给函数插一个标记,告诉框架下面报的错别算在我头上,往上走一层,消息一个字没变,变的只有那个数字,而那个数字正是你按下跳转要用的东西。它把一条错误从知道哪里错了,变成知道该改哪里,这一处是整篇里我觉得最值钱的一个对照。
基准:跑多少轮不归你定
测试管对错,基准管成本。
基准函数也住在 _test.go 里,形状换成 *testing.B,函数体里套一个跑 b.N 次的循环。我另建一个 bench_test.go,里面放两个,一个只调 Add,一个把结果用 fmt.Sprintf 拼成字符串:
1 | package calc |
这些函数平时不跑,得点名,go test -bench . -benchmem ./... 的输出是这样:
1 | goos: windows |
头部四行是环境,goos 和 goarch 是平台,pkg 是包路径,cpu 是处理器型号。下面两行才是结果,一行一个基准,BenchmarkAdd-32 尾巴上那个 32 是 GOMAXPROCS,跟核数有关。第二列那个十亿是这一轮跑了多少次,第三列是把总时间摊到每次调用上的结果,末尾两列是 -benchmem 加上去的,一个说每次操作在堆上要了几个字节,一个说分配了几次。
第一次看到 0.1041 这个数我愣了半天,觉得它快得不真实。它确实不太真实,Add 里就一个加法,现代 CPU 一个周期能吃完,一纳秒里能塞十次,编译器还可能把整个循环优化得只剩壳,所以基准里的结果通常要落到一个包级变量上,我写的那个 sink 就是这个用途,让编译器没把握把调用整个删掉。不过就算落到 sink 上,BenchmarkAdd 那个数字也还是 0.1 上下,几乎没动,说明什么我至今没完全搞清,只能确定一件事,这种一纳秒级的数当参照物可以,当承诺不行,真要拿它做决策,得先把被测量的东西放大到微秒级,让它比噪音高出一个数量级。这也是为什么 fmt.Sprintf 那一行我留着没删,它四十纳秒左右,读数稳得多,两个数并排放着,你才知道第一个数小到了什么程度。
5 B/op 和 1 allocs/op 那两列我更信得过一点,第一行两个 0 是因为 Add 压根不碰堆,第二行那个 fmt.Sprintf 才真的分配。这里有个我踩到的小坑,格式串一开始写成 %d,跑出来是 0 B/op 0 allocs/op,改成 sum=%d 才变成五个字节和一次分配,为什么差一个前缀就差出一次分配,我没去翻汇编,只知道这个数字对格式串的内容敏感。基准里那两个内存列也有可能骗人,它们测的是这一版编译器在这台机器上对这段代码的处理,不是语言规范。
还有一件事得说清楚,b.N 不归你定。框架先拿一个小一点的数试跑,看这一轮够不够长,不够就翻倍,直到耗时落在它能量准的范围里,所以那个次数不是成绩,是这次测量选定的量程,换台慢机器次数会小一大截,成本那一列才有意义。
所以那个次数别当成绩看,它只是这回测量选定的量程。
覆盖率、竞态检测器,和一张开关表
-cover 会多打一段百分比,单位是语句:
1 | $ go test -cover ./... |
coverage: 100.0% of statements 说的是这个包里每一条语句都至少被执行过一次。注意单位是语句不是分支,if 两边都走过和只走过一边,在它眼里没区别。Add 只有一条语句,四个用例怎么排都覆盖得满,这个 100% 说明不了太多,它只能告诉你没有整块死角被漏掉。
-race 是另一个路子,查的是并发读写打架,我第一次跑它,报的不是代码问题,是环境问题:
1 | $ go test -race ./... |
Windows 上 -race 依赖 cgo,而我的环境里 CGO_ENABLED 是 0,跟测试写得对不对一点关系都没有。加上环境变量再跑就过去了,同一份代码,不带它是 0.100 秒,带上变成 1.985 秒,慢了将近二十倍:
1 | $ CGO_ENABLED=1 go test -race ./... |
这个倍数别拿去当结论,包太小,启动开销占了大头。它值钱的地方在于跑的时候往每次内存读写里插检查,两个 goroutine 同时写一个变量,它当场把调用栈打出来。
Example 是另一样东西,它不是测试,是一份能被执行的文档,函数体末尾用注释写下期望的输出:
1 | package calc_test |
跑通了什么都不打印,把注释里的 5 改成 6,它立刻对不上,got 和 want 两段并排摆着,差在哪个字符上一眼就能看出来。它比的不是某个变量,是这个函数写到标准输出的全部内容,你多打一行调试信息,对账立刻失败。
六个开关收在一张表里,哪个管什么、什么时候该加,忘了就回来查一眼:
| 开关 | 接什么 | 什么时候加 |
|---|---|---|
-v |
不接参数 | 想知道跑了哪几条、挂在哪一条 |
-run |
一个正则 | 只跑一条或一组,调 bug 时省时间 |
-bench |
一个正则 | 跑基准,. 表示全跑 |
-benchmem |
不接参数 | 基准要连内存分配一起看 |
-cover |
不接参数 | 想知道哪些语句一次都没被执行过 |
-race |
不接参数 | 怀疑有并发读写打架 |
到这儿,一个包从没有测试到有测试、有基准、有示例,路就走完了,剩下的是下一篇那条线,把这些东西拼成一个能装到机器上的命令行工具。