把 gctrace 那一行拆开,每个字段对一遍
把 gctrace 那一行拆开,每个字段对一遍
隔壁老康难度 ★★★★☆ · 前置:三色标记、写屏障,还有那句 gc 1 | 一句话结论:gctrace 那一行里最该看的是存活量,它决定了下一轮的目标值,而三个一模一样的数是回收器在告诉你这一轮白跑了。
上一篇讲的是三色标记和写屏障,那套东西解释的是对象为什么不会丢,可它跟真到线上把内存问题摁下去还是两码事。内存曲线往上爬的时候,手边能抓的东西常常只有 gctrace 刷出来的那一行字,认不全就只能凭感觉去调参数,调完也不知道是调对了还是运气好。
1 | gc 1 @0.054s 0%: 0+0.55+0 ms clock, 0+0/0/0+0 ms cpu, 3->4->1 MB, 4 MB goal, 0 MB stacks, 0 MB globals, 32 P |
我这回用的还是那个最小的程序,先把堆推到 64MB,再自己调一次 runtime.GC(),输出干净很多,四行摆在那儿够我对。环境是本机的 go1.27.2,windows/amd64,GOMAXPROCS 设成 32。先看它长什么形状。
这一行分成五段,段段各答一个问题
从逗号处切下去,这一行是五段,序号和启动时间、CPU 占比、三段墙钟、三段 CPU 时间,最后是内存那一长串,也是唯一会告诉你堆此刻长什么样的一段,前面四段都只描述过程,过程读得再细也推不出堆上还剩下什么,五段里只有最后一段写的是堆的现状。
第五段最长,也最该先看,它回答的是堆上现在什么情况,前几段回答的只是这次回收花了多少,前者是诊断,后者更像账单,账单再漂亮也不说明堆是健康的,账单和体检报告不是一回事。
先认那五列各是什么,再读数字。
我一开始把注意力全押在毫秒上,盯着 0.55 和 1.1 看了半天,后来才发现真正有用的是那三个用箭头连着的数,毫秒只说明快慢,箭头才说明形状,两样混着读就会把快慢当成健康,我最早写的那份排查笔记里整页都是毫秒,一个箭头都没抄。
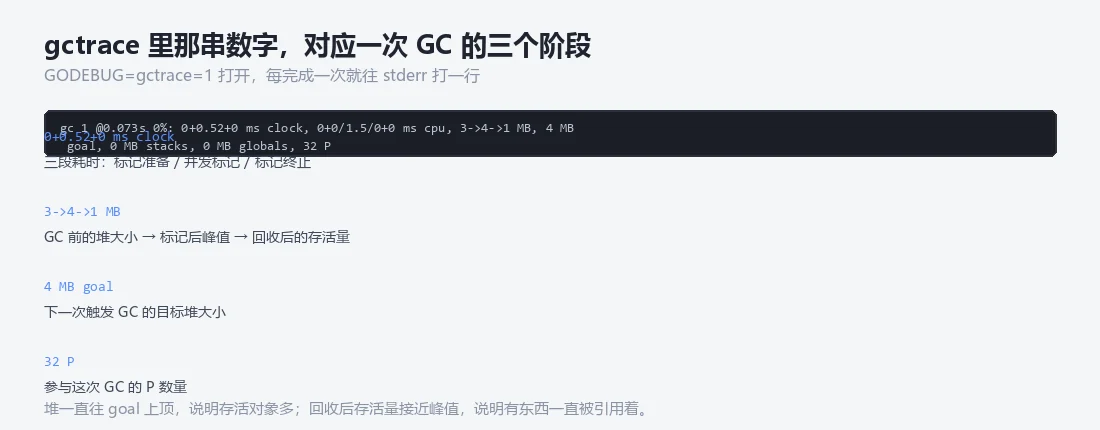
列的顺序是固定的,会变的是里面的数。
四行里第一段一直在动,@ 后面从五十四毫秒走到五十九毫秒,四次回收全挤在这五毫秒的窗口里,程序刚起来什么都没干就先回收了四轮,这四轮加起来还没跑满一毫秒。
第二段的 0% 四行都没变过,那只是采样口径下的整数百分比,量小到显不出来就写 0,不代表一点 CPU 都没花,这两段只描述过程,不描述状态。
认字段可以只靠位置,不必去背名字。逗号把这一行切成固定的格子,同一个序号后面那一格永远表示同一件事,32 P 和 0 MB stacks 从头到尾没动,一个是 GOMAXPROCS 设死的结果,一个是这几个小程序太干净,栈和全局变量都没占到要单独记账的量。
我后来把这一行抄在纸上,用不同颜色的笔把五段一段段框开,框完再回头看那四行,才发现自己前半小时一直盯着第二段和第三段,最该看的那一段一次都没扫到,眼睛会自动往左边跑,因为左边数字密。
存活量才是那一行的主语
三个数的顺序是死的,位置一换,读法就全反了:
| 位置 | 是什么 | 好不好看它 |
|---|---|---|
| 第一个 | 这一轮开始之前的堆 | 过程量,有波动正常 |
| 第二个 | 标记结束那一刻的峰值 | 过程量,通常还是三个里最大的 |
| 第三个 | 回收做完之后还活着的量 | 状态量,涨了才是真问题 |
真正决定后面一切的只有最后那个 1,前面两个都是过程。这一格上三个数的读法跟前几段正好反过来,前两个是过程量,最后一个才是状态量,读反了就会把峰值当成占用。存活只有 1 MB,回收前堆上却有 3 MB,说明这个阶段分配出去的东西里有三分之二是活不过一轮的,标记扫完、清扫一做就没了。中间那个 4 比两边都大(我一开始想不通),后来才明白中间那个数里还含着已经判定成垃圾、但清扫还没来得及收走的部分,标记本身也要占一点内存,所以它常常是三个数里最大的。这个数最容易被随手读成堆的当前大小,读完就去猜曲线为什么涨,方向从这一步就偏了。gc 3 是 3->5->2,gc 4 是 4->6->2,存活从 1 涨到 2,涨出来的那一兆是程序自己还捏着的引用,回收器碰不了它。这一兆是怎么涨上去的,比这轮回收花掉的那一毫秒上下有意义得多。看这一格我习惯拿手指盖住前两个数,只留最后一个,前两个是过程,过程有波动很正常,标记期间分配还在继续,峰值高一点低一点说明不了什么,最后那个数涨了才是真问题(这一点我到现在还得提醒自己),因为中间那个数更大,眼睛更容易被它抓走。
我后来给自己定了个笨办法,每看到一行就先把最后一个数念出来,念完再回头补前面两个,这样手比眼睛快一步,不容易又滑回峰值上去。
4 MB goal 是算出来的,不是攒到 4 MB 就收
目标值那一格回答的是下一轮什么时候开。4 MB goal 里的 4 是从上一轮的存活量推出来的,拍脑袋定不出这个数,它跟前面几段的区别在于,前面写的是发生过的事,这一格写的是运行时接下来打算怎么办。
存活 1 MB,GOGC 默认是 100,含义是瞄准存活量的两倍,照这个算该是 2 MB 上下,可这个数太小了,运行时还有一条下限兜着,最后落到 4,所以这个 4 不是谁设的,是算出来又被下限抬了一手,我最早把它当成一个开关,以为堆到了这个数才动手,后来才明白它是上一轮结束时就已经写好的剧本。
目标是 4 MB,为什么它不等堆长到 4 MB 就动手?存活量不涨,gc 3 @ 后面的目标值也不涨。
所以 GOGC 等于 100 瞄准的是存活量的两倍,不是很多人以为的堆涨到两倍才回收,一个说的是还活着多少,一个说的是多花了多少,两个东西不一样。
  flowchart LR
    A["这一轮结束时的存活量"] --> B["goal = 存活量 × (1 + GOGC/100)"]
    B --> C["再抬一条下限"]
    C --> D["堆长到 goal"]
    D --> E["触发下一轮回收"]
    E --> A
这两种理解在存活量小的时候看不出差别,因为一兆两兆怎么算都在个位数,一旦存活涨到几十兆,差别立刻显出来,算出来的门槛能差出一大截,错的那一边不会立刻报错,代码照样跑,只是每次回收的时机都比你预期得早一点或者晚一点。
按错的那种理解去调参,多半会往小里调,觉得越勤越安全,其实只是让回收器多跑几趟,CPU 全花在描边上。我早年就干过这事,觉得越勤越安全,把 GOGC 往小里压了一档,回收次数确实上去了,可内存曲线一点没往下走,那几天我隔一会儿就刷一次 gctrace,最该看的那一格始终没动过。
这就解释了一个常见的误会。堆从 3 MB 涨到 4 MB 只涨了一兆就回收,看着像回收太勤,其实是因为存活只有 1 MB,目标值被压到了 4。这里的因果常常被读反,不是堆涨到 4 才收,是目标定在 4 才会在那个点前后收。
目标值不会自己往下掉,它只跟着存活量走,存活量不下来,它就下不来,这句话我在评审里说过不止一次。
后面带 (forced) 的两行更能说明这件事。48->48->48 配的是 65 MB goal,65 是从那 48 MB 的存活量推出来的,乘上一个跟着 GOGC 走的系数,再叠一条下限,我把 65 和前面那个 4 并排写在纸上,两个数差得远,算法却是同一套,喂进去的存活量差了四十多兆。
三个一模一样的数就是一次白跑
48->48->48 和 64->64->64 这两行,三个数一模一样,意思很直白,这一轮回收一个字节都没收走。前后一样说明回收前有 48 MB,回收后还是 48 MB,标记扫完了,清扫也扫完了,堆一点没小,原因是那时候堆上全是我还拿着的引用,没有任何东西能被判定成垃圾,标记器从根出发能摸到每一个对象,一个白的都不剩,清扫阶段面对的是一个空的白名单。
这次回收是纯浪费,它把整块堆从头扫了一遍,付了扫描的代价,然后什么都没换回来,连一兆的空闲都没腾出来,那两次按下去的时候堆上的引用图还是满的,扫得再仔细也变不出垃圾来。
这种浪费在真实服务里也会出现,只是长得不那么整齐,定时任务的缓存、长期持有的连接池、还没到期的会话,这些东西都还活着,你调一次 GC 想让内存降下来,结果降不下来,gctrace 上就会冒出这种三个数几乎一样的行。
(forced) 后面藏着一句我是故意的
括号里那个词只有手动调 runtime.GC() 才会出现,正常靠堆增长触发的回收不会带这个后缀。看到它就等于看到一行自白,这次回收是有人在代码里按下去的,不是运行时自己决定的。我这四行里的两次都是这么来的,程序先把堆推到 48MB 按一次,再推到 64MB 再按一次。手动触发的好处是把时机从运行时手里拿走,换来可复现的输出,代价是这两次回收对程序本身没有任何好处,跑完还得接着跑,只是白描了一遍堆的样子。还有个细节值得记下来,带 (forced) 的两次耗时全是 0,0+0+0 ms clock,一个数都没冒出来,那两行里唯一非零的数字只剩内存那一段。我第一次看到这两个 0 还以为是打印出了问题,因为耗时就那么直挺挺地写着三个零,后来才明白它写的不是快,是不用干活,快和不用干活在数字上长得一模一样,得回头看那三个数才分得清,三个零拆开看是三个不同阶段的耗时,凑在一起才等于没干活。耗时这一栏在这里不骗人,三个 0 老老实实地告诉你,这几次扫都是零成本的空转,不是因为快,是因为对象全都活着,标记集合一上来就是满的,从根出发第一层就走完了,没有白对象要反复涂灰。
三个数一样、耗时全 0 的行,是 gctrace 里信息量最低的一种,它只能说明此刻没有垃圾,别的什么都推不出来,尤其推不出这程序有没有内存问题。
(所以看到这种行别急着高兴,它连这次回收快不快都没说。)
先数 NumGC 长得快不快
拿到一行 gctrace,我的第一反应是数 NumGC 长得有多快,毫秒先放一边。这个数在一行开头,gc 1、gc 2 一直往上累加,程序结束的统计里也有一个,我这次跑完是 7。要看的不是绝对值,是单位时间里的增量,日志里要是每秒冒出几十行,说明分配速率高到回收器追不上,这时候去调 GOGC 基本没用,调大只是让间隔变长,每一轮的存活量还是那么多,内存曲线该涨还是涨。分配速率的问题只能回到分配点上去解决,这是唯一有效的方向,参数只能改节奏,改不了总量。只靠这一个字段就能把问题分成两类,一类是造垃圾太快,一类是留垃圾太多,走错门就白忙。我这个程序总共就分配了那么点东西,NumGC 到 7 就停了,停在那儿不动。换成一个真在接请求的服务,这个数会一直往上走,停不下来,那才是需要盯的形态,个位数说明不了任何问题。
我第一次看这四行还数错过,把序号当成了最后一行统计里的那个总数。
我在另一个服务上见过的形态刚好反过来,NumGC 半天不怎么动,可 HeapAlloc 一路平推,那是留得太多,跟造得太快完全是两码事。
我刚接手现在这个服务的时候,第一天看到的是每秒几十行,那时候还在参数上找原因,找了半天才回头去看分配点,那半天白花了,可也正是那次让我把顺序固定了下来。
分配点怎么找,go build 带上 -gcflags=’-m’ 能看到哪些变量逃到了堆上,pprof 的 alloc_space 能看到哪一行分配得最多。这两样我一般一起开,先看逃逸,再看排名。逃逸名单里排在前面那几行,基本就是 NumGC 涨得快的原因。
调大 GOGC 换到的是另一笔账
GOGC 调大能让回收次数变少,这话没错,但它是拿内存换来的。默认 100 是瞄准存活量的两倍,往上调就是把这个倍数拉大,堆得涨到更大的规模才触发下一轮,次数下去了,驻留内存上去了。这两边都得付账,只看次数会得出越大越好的结论,只看内存又会得出越小越好的结论,两个都不对,因为真正的取舍在你自己的服务上,跟存活量、分配速率,还有那台机器上还剩下多少预算都有关。参数改的是一个比例,不是一道闸,改完先去量,别改完就当解决了,量的时候还得连着看好几轮,只看一轮容易撞上偶然(尤其是分配有波峰的服务),单轮的增量说明不了趋势,我现在至少要连着看好几轮,取个中位数才敢下结论,单看某一轮会被偶发的一次分配带着走。我现在的做法是先不动 GOGC,把分配点压一轮,再看 NumGC 的增量,压完还是高,才考虑动它,动的时候同时盯 HeapSys,因为那才是向操作系统要来的部分,HeapAlloc 只算还活着的那些。(有一回我只盯着 HeapAlloc 看,觉得没降就急着往回改,后来才想起该看的是 HeapSys,白折腾半天。)debug.SetGCPercent(-1) 关掉自动触发会返回上一次的值,我这次拿到 100,正好确认这台机器上的默认值没被人改过,别人机器上排查我也常用这一招,因为你不知道对方的启动参数里塞了什么,先问一句比猜半天快。
调参数这件事最容易犯的错是一改就想看到结果,可它是几轮之后才显出来的,改完这一秒看不出来,下一分钟也看不出来,得让程序自己跑过去。
HeapAlloc 和 HeapSys 差的那七兆多
跑完的统计里 HeapAlloc 是 67760584,HeapSys 是 75137024,两个数差了七兆多。HeapAlloc 是当前还活着的对象占的字节,HeapSys 是向操作系统要来的字节,所以看占用不能只看前者,RSS 高而 HeapAlloc 稳,说的就是中间那一块。
中间那部分就是分配器手里攥着、暂时没用的空闲页,75137024 减 67760584 是 7376440 字节。这个差不是泄漏,泄漏是 HeapAlloc 一路涨,这里是 HeapAlloc 稳住了而 HeapSys 不往下走。堆推到 64MB 之后手动回收,64->64->64 后面跟着 97 MB goal,97 也是从那 64 MB 的存活量推出来的,两个目标值各跟各的存活量,差着三十多兆,谁也没去改那个数,是两个不同的存活量各自算出来的。
那一行字最大的用处,是让你没开 pprof 的时候也能判断堆上现在是什么形状,形状不对,看什么都是猜。