数据竞争不会每次都报错,所以得让工具去盯
数据竞争不会每次都报错,所以得让工具去盯
隔壁老康难度 ★★★★☆ · 前置:select 有多个 case 都就绪,会选哪个 | 一句话结论:检测器给每个内存字节记一份影子状态,只在两次访问真的撞上时才报,所以干净只说明这次没撞上,说明不了没有竞争。
这段报告我第一次看的时候只读了第一行,后面全跳过了。
1 | ================== |
这个程序短得几乎不用解释。四个 goroutine,每个循环一千次对同一个 int 自增,主 goroutine 等在 Wait 上。写它本来是为了讲 WaitGroup 的加减怎么配对,我心里预期的答案是四千,四条线各记一千笔账,加起来就该是那个数。第一眼我以为是循环边界抄错了,把 4 写成 3 会少,把 1000 写成 900 也会少,可这两处我都逐个核过,又对着源码从头看了一遍,剩下的解释只有一种,有几笔账根本没写回去,被别人的写操作盖掉了。
我把 4000 减 3649 算了两遍,都是 351,这个差值不大不小,不像少跑了一整条 goroutine,也不像差了一位数,更像是每一轮都在某个点上漏掉一点。跑出来是 3649,少了三百五十一次。这个盖掉不是抽象说法,counter++ 在源码里长得像一步,落到机器上是三步,先把那个值从内存读进寄存器,再在寄存器上加一,最后写回原来的位置。
三步之间没有任何东西挡着别的 goroutine 插进来,两个 goroutine 几乎同时走到这一步,都读到三千,都各加成了三千零一,都写回去,内存里只留下一个三千零一,其中一笔账就这么没了。注意这里丢的不是一次运算,是一次更新,读写的窗口开得越长,两个人的窗口重叠的机会就越多,这也是为什么把变量加宽、把一个操作拆成两步都会让丢的次数变多。丢掉的次数跟撞车的次数有关,撞得越密丢得越多,所以每次跑出来的结果都不一样,3649 只是其中一次,换个时刻再跑大概率是另一个数。
两个 goroutine 撞上的机会少一些,八个就多得多,所以同一个程序换一个并发度,少掉的数目能差出很远,拿这个偏差反过来推并发度是行不通的。这也是它讨厌的地方,看代码怎么读都对,跑起来就是错的。
当时的排查方向是错的。
我先怀疑 WaitGroup,觉得可能是 Add 和 Done 没配上,或者 defer 在某个分支上没执行,让主 goroutine 提前往下走了。把四条线的结束都打印出来看,一条都没漏,Wait 也确实等到最后一条才返回,这条路封死。先排除的是等待。
环境记一下,go1.27.2,windows/amd64,GOMAXPROCS=32,CGO_ENABLED=1,机器是 i9-14900HX。
后面几组耗时都在这台机器上量,换台机器数字会变,倍数大致不会。
1 | package main |
确认方向之后我做的第一件事是给命令加 -race。原以为它顶多丢一行提示,说某个变量被两边同时碰了,结果它给了整整一屏结构化输出,有地址,有两个 goroutine 编号,有各自的调用栈,还有一段专门交代那个 goroutine 是在哪儿创建的,就是开头贴的那一屏。那一屏比我前面自己猜的那几轮都管用,它直接指向一行代码,说这行被两个 goroutine 各碰了一次,中间没有任何同步动作。我盯着两段栈看了很久,因为它们的形状几乎一模一样,函数名相同,文件名相同,行号也相同,只有末尾那两个偏移对不上,一个 +0x8d,一个 +0xa5。我一开始以为这是两处不同的竞争,各修各的就行,看到地址完全一样才转过来,两段说的是同一处。
报告得倒着读,先出现的那段反而是后发生的。最后三行最容易被忽略。
3649 是程序自己的输出,跟检测器无关。
Found 2 data race(s) 是它收尾时的汇总,说的是这一轮运行里撞上了两处,不是这个程序里一共只有两处。
exit status 66 是 go run 转述的退出码,进程没以 0 退出去,这一段放进 CI 就会红,不用你自己去 grep 日志找关键词。
很多人扫一眼栈就关掉终端,把这最后三行漏掉,最后误以为程序只是数字算错了,其实流程早就不是正常结束。
头一次我也漏了,第二次才注意到退出码那一行。
1 | counter: 3649 |
两段栈落在同一行,顺序还是反的
报告的结构其实很有讲究,第一次看会觉得乱。第一段是 Read at,说某个地址在某一刻被 goroutine 10 读了一次,第二段是 Previous write,说同一个地址更早被 goroutine 8 写过。两段栈都落在 main.go 第 18 行,偏移分别是 +0x8d 和 +0xa5,差了那么一小截(这两个数我当时盯着看了半天,没看出名堂)。
所以打印顺序跟发生顺序是反的,先出来的那段反而是后发生的,检测器先把抓住现场的那次摆在前头,再把它的对手从影子里翻出来放在后面,这个顺序我一开始读错了半天,一直以为前一段是先动手的那个,其实正好相反。第 18 行就是 counter++,这行在机器上不是一步。两处竞争指向同一个源码位置,一行里既有读又有写,四个 goroutine 同时在跑,撞上的组合不止一种,所以汇总写的是二。
读到这一层,报告里那些看着多余的行才开始有意义,地址相同说明是同一块内存,行号相同说明是同一处代码。
影子内存按字节记,记的是谁碰过
所以大程序跑 -race,干净这两个字要打得比小程序更小心。
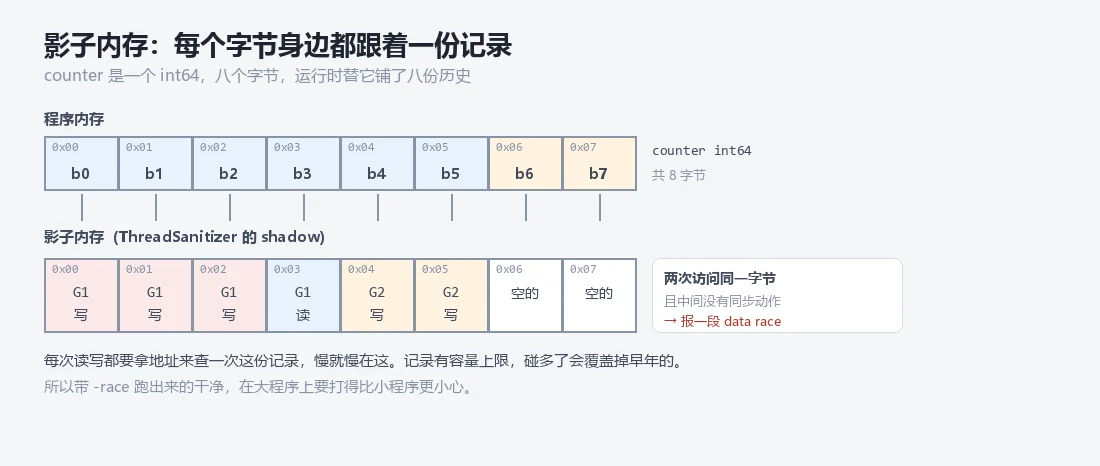
检测器的底子是 ThreadSanitizer 那套算法。它不盯着你的变量,而是给每一块内存的每一个字节都维护一份影子状态,记着最近一次碰它的是哪个 goroutine,那次是读还是写。counter 是个 int,八个字节,于是它身边就跟着八份这样的记录。你给它一个地址,它翻出对应的那几份,跟你当前这次访问比一比,看有没有别人在没跟你打过招呼的情况下动过同一块地方。这套记录不在你的代码里,是运行时替你铺的。它也不认识你的变量叫什么,不知道你在写业务还是写测试,手里只有地址和访问类型,判断完全基于这两样。也正因为不认识变量名,它给不了关于修法的建议,只会告诉你哪个地址、哪一行、哪两个 goroutine。影子是按字节记的。每次读写都要跟影子状态比一遍,这个比对本身就是开销,所以带 -race 的程序慢,慢在这个动作被插进了每一次内存访问里。比对只有两种结果,要么这次访问从没被别的 goroutine 碰过,要么对面确实碰过而且中间没有同步动作,后者就报一段。
这份记录也有失效的时候,影子状态本身是有容量上限的,碰过的内存多到一定程度,早年的记录会被覆盖掉,可能漏掉一些本来该报的东西。
它那份容量参数我翻过,没翻明白。影子内存记的是什么,为什么能反过来指出哪一行?
带 -race 跑一次,慢多少、大多少
速度这块我用两组代码对照过,加上体积一共是四个数:
| 量的是什么 | 不带 -race | 带 -race | 差多少 |
|---|---|---|---|
| 八个 goroutine 各五十万次累加 | 0s | 529µs | 打印不出来,不算数 |
| 八个 goroutine 各十万次加锁自增 | 26.4106ms | 202.0406ms | 约 7.6 倍 |
| 二进制体积 | 2515968 字节 | 4129879 字节 | 约 64% |
第一组那个 0s 不是真的不花时间,是没到计时器能打印出来的量级,拿它当基准没什么说服力,我换了一组。第二组两边都真的在做事,锁的代价也在里面,检测器叠上去的就是这么厚的一层。开销跟访问次数成正比,读一次写一次都要过一遍影子,循环里越密集,倍数越难看。这一组数我重跑了。体积涨出来的那部分主要就是影子状态和检测器自己。
这也解释了为什么带 race 的产物不适合直接发到线上,它本来就是拿空间换检查,一张影子内存要覆盖整个地址空间,谁也没打算让它替生产环境跑常规流量,那个 64% 的体积就是这张表的账单。
把 counter++ 塞进锁里,检测器就不报了,原因是加锁这个动作本身会更新影子状态,检测器一看这两个访问之间已经有了明确的先后关系,就不再把它们当成并发,报告的规则里有一条就是只报没有同步关系的那些。
两个 goroutine 的访问被排出了明确的先后,先拿锁的那次算在前,后拿锁的那次算在后。
体积涨这么多在部署上也有代价,一次给所有服务开 race 版本,镜像和发布包都得跟着重做,它能待在测试环境里的原因也在这里,它要的是能复现,不是能扛量。
1 | plain : 0s |
1 | plain : 26.4106ms |
加锁之后它就不报了,原因是同步
1 | var ( |
所以要它闭嘴很容易,把同步补上就行。这句话我拿几个例子试过。难的是知道哪两个变量真的需要同步,以及那把锁护住的范围对不对。锁护得太窄等于没护,护得太宽又会让并发退化成串行,两头都不算解决。护得准比护得多难,准的意思是知道哪两处必须排成先后,其余的地方放开。这层判断靠读代码,工具帮不上,检测器只告诉你哪里撞了,不告诉你哪里该锁。这个判断我改过好几回。
channel 的收发、原子操作、sync 包里那些工具,做的事都是同一件,在两个本来毫无关系的时间点之间插进一个确定的顺序。
它只报真的跑到过的那两次
翻完那十几段,形状几乎一样。
这套机制有个前提,那两次访问得真的发生。测试用例没覆盖到的分支,它跑不到,自然不会报。线上才有的那种并发度,本地压不出来,它也看不见。只在某个特定时序下才会同时发生的那两次访问,跑十遍可能一遍都不撞上。
这几种情况都不是检测器的失误,它给的是观测结果,不是证明,它只能看见这一次运行里真的发生过的事。所以 go test -race 过了,只能说明这次跑过的那批用例在这次的时序下没撞上,说明不了那批代码里没有竞争。
反过来也一样,它报出来的东西是真的,没报出来的地方它一个字都没说,这个沉默里什么都没有。干净不等于没有,它只说明这一次没撞上。我现在的习惯是把它当成一次抽样,抽到了就有问题,抽不到不证明干净。
往发布说明里写已验证无竞争这种话,我劝自己别写。
锁和 channel 我都不保证用对,能保证的只是让检测器多跑几遍。另一头是它可能报得很多。
一个 bug 藏在循环里,每次撞上都单独报一段,十几屏很容易(我第一次撞见的时候以为程序里到处是问题),把每一段都读完,才发现栈的形状几乎一模一样,只是 goroutine 编号和偏移在变。
它每抓住一次就写一次,不去重也不合并,所以段数反映的是碰撞频率,不是缺陷数量。
同一个地方在很短的时间里被撞上很多次,它就能给你写出很多段,看上去像很多个 bug,其实只有一个。
一个 bug 能刷十几屏,第一段就够了
先看第一段就够。那段给的信息最全,地址、两个 goroutine 的编号、两段栈、创建的位置,都在里面。后面那些重复的段落多半是同一处竞争在不同时刻又被抓了一次,先读明白第一段的栈,回到源码确认那两行是不是真的没有同步,再决定要不要往下翻。
未定义行为比读到旧值严重得多
悄无声息的故障最难查。
数据竞争在 Go 里是未定义行为,这句话的分量比它听起来重。它不是读到旧值那么温和,编译器完全可以把这个读提到循环外面,只读一次,后面的迭代全用那个旧值,也可以把这个变量整个放进寄存器,循环里一直在寄存器上加减,写回内存的动作被推迟或者干脆合并掉。站在写这段代码的人眼里,就是那个变量在某个 goroutine 里永远不变。代码明明写着每轮都加,跑出来却像根本没进过循环,这也是为什么这类问题上线之后表现得不像数据错了,更像某段功能安静地消失了。我原先以为数据竞争就是读到旧一点的值,看过编译器那几种可能的处理方式之后才改了想法。
那段手册我反复翻过。值旧可以靠重试兜住,代码没跑没办法兜。
同一条语句在报告里只是两行栈,到了线上可能是整整一段功能不出声。
前者有日志可查,后者只剩用户那边的一句反馈,连报错都没有,连复现都要靠运气。
交叉编译会卡在 cgo 这一关
还有一个绕不开的坎。-race 依赖 cgo 和运行时那部分的改写,命令跑起来需要 CGO_ENABLED=1。交叉编译的时候这条就卡住,目标平台是另一套架构,cgo 编不出来,整个 -race 也编不出来,报出来的错跟 race 本身没关系,看着更像环境没配好,容易在那边耗掉很久。
我第一次撞上时翻了半天的工具链文档,最后才反应过来,问题不在这条命令本身。交叉编译会在这一步停住。我现在的做法是在 CI 里单独拆一个任务,跑 go test -race ./…,放在本机能开 cgo 的环境里,不进交叉编译的矩阵,也不指望它替我做发布前的最后一道闸。
它拦住的是那些真会撞上的写法,拦不住的是没被跑到的路径。